AI Agent 是一种自主软件系统,它以大语言模型作为核心推理引擎,用于感知环境、做出决策并借助外部工具执行操作。这份 AI Agent 入门指南 面向软件工程师,探讨其架构、框架和实际实现。
什么是 AI Agent?
人工智能的范式已经发生了巨大转变,从静态、无状态的请求-响应机制,转变为动态、有状态且自主的实体,即 AI Agent。在传统的大语言模型(LLM)交互中,系统是纯粹被动的:用户提交一个提示词,模型根据其预训练权重生成相应的文本输出。这种方式虽然强大,但将模型限制在一个封闭的对话沙箱中,缺乏自主性,也无法影响外部世界。
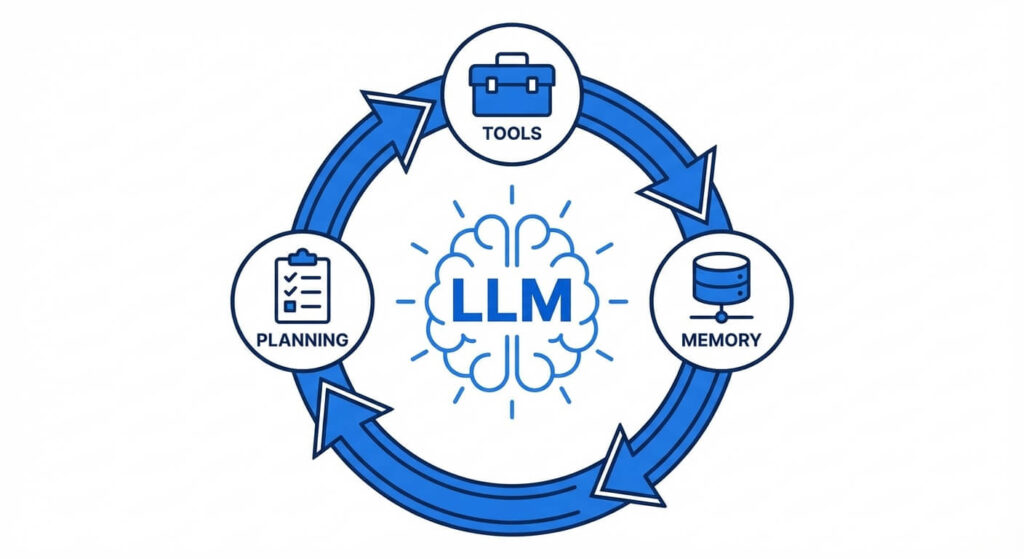
AI Agent 通过将推理引擎与执行环境解耦,从根本上改变了这一动态。通过将 LLM 封装在一个编排循环中,AI Agent 获得了持续观察环境、处理上下文数据、制定分步计划,并调用外部应用程序编程接口(API)以实现预定目标的能力。这一转变使 LLM 从简单的文本生成器进化为强大的认知引擎,能够在无需持续人工干预的情况下执行复杂的软件工程、数据分析和工作流自动化任务。
免费的 Agentic AI 认证课程
实践学习 LLM、提示词工程、RAG 与 Agentic AI。零成本获得业界认可的证书。
AI Agent 的核心架构
要了解如何构建 AI Agent,需要解构其内部架构。一个健壮的 Agentic 系统由四大支柱组成:推理引擎、记忆系统、规划模块和工具执行环境。
1. 推理引擎(“大脑”)
任何 Agentic 系统的核心都是大语言模型(例如 GPT-4、Claude 3、Llama 3)。在 Agent 架构中,LLM 并非仅用于生成人类可读的文本,而是经过大量的指令微调,用于评估状态、解析 JSON、执行逻辑推理,并确定序列中的下一个最优步骤。推理引擎处理输入状态,并输出底层执行脚本可以解析和执行的指令格式。
转变你的职业生涯
选择我们为职业成功设计的行业领先课程
现代软件与 AI 工程课程
掌握全栈开发与 AI 集成

+1000 更多
AI 前沿部署工程师(AI 应用方向)
构建并部署 AI 解决方案,解决真实世界的商业问题
+1000 更多
现代数据科学与机器学习(AI 方向)
采用 AI 方向的高级数据科学技术
+1000 更多
高级 AIML(智能体 AI 方向)
深入学习 AIML,聚焦智能体系统
+1000 更多
DevOps、云与 AI 平台工程
构建和管理 AI 驱动的云基础设施
+1000 更多
IIT-Roorkee AI 工程高级认证
由 IIT-Roorkee 颁发的顶级 AI 工程认证

2. 规划模块
自主智能体必须解决多步骤问题。规划模块负责任务分解——将复杂、宏观的目标拆解为更小、更易管理的子任务。现代智能体利用 ReAct(推理与行动)或思维链(CoT)提示等范式,在调用工具之前逐步阐明其逻辑。这种自我反思机制使智能体能够纠正自身的错误。例如,如果一次 API 调用返回 404 错误,规划模块会观察到这一失败,重新评估参数,并制定新的请求。
3. 记忆系统
标准 LLM 本质上是无状态的。要在长时间内自主运行,智能体需要复杂的记忆架构:
- 短期记忆: 依赖于模型的上下文窗口。它保存当前交互循环(思考、行动和观察的序列)的即时历史。
- 长期记忆: 为了跨多个会话持久保存信息,智能体使用外部向量数据库(如 Pinecone、Milvus 或 pgvector)。文本数据被转换为高维数值向量(嵌入)。当智能体需要历史上下文时,它会执行数学上的最近邻搜索——通常计算余弦相似度,表示为 sim(A, B) = (A · B) / (|A| |B|)——以检索最相关的过往经验。
4. 工具与执行器
工具是让智能体能够操控其环境的函数。它们可以是简单的 Python 函数和 shell 执行脚本,也可以是与 REST API、SQL 数据库和网页抓取工具的复杂集成。LLM 会获得这些工具的模式(通常使用 OpenAPI 规范),并利用其推理能力根据当前目标向这些函数传递正确的参数。
生成式 AI 智能体与传统自动化
软件工程师常常将现代生成式 AI 智能体与传统的机器人流程自动化(RPA)或标准的基于规则的自动化流水线混淆。虽然两者都旨在减少人工干预,但它们的底层架构和能力截然不同。
传统自动化基于确定性的、严格定义的规则集(if/else 逻辑),并且需要高度结构化的数据。相比之下,生成式 AI Agent 是非确定性的,能够处理非结构化数据,并具备动态应对模糊场景所需的语义理解能力。
| 特性 / 属性 | 传统自动化(RPA) | 生成式 AI Agent |
|---|---|---|
| 核心逻辑 | 确定性规则、预定义状态机和僵化的 if/else 语句。 | 概率推理、动态任务规划,以及借助 LLM 实现的语义理解。 |
| 输入数据 | 需要严格结构化的输入(例如格式化的 CSV、严格的 JSON 模式)。 | 轻松解析非结构化输入(例如自然语言邮件、原始 HTML、PDF)。 |
| 错误处理 | 一旦遇到意外的异常或边界情况就立即失败。 | 能够自我反思、分析错误堆栈,并动态调整 API 参数。 |
| 适应性 | 零适应性。UI 元素或 API 端点稍有变化,工作流就会中断。 | 高适应性。可以即时阅读新文档,并适应各种数据格式。 |
| 开发开销 | 映射精确工作流的初始设置成本高;系统变更时维护负担重。 | 需要精心的提示词工程和工具绑定,但能原生应对运营层面的差异。 |
Agentic AI 背后的关键概念
要真正掌握 AI Agent 的开发,工程师必须理解让 LLM 表现出智能体行为的基础提示词工程技术和系统架构。
ReAct 框架
ReAct(推理与行动)框架可以说是智能体开发中最关键的范式。由研究人员提出后,ReAct 将推理轨迹与特定任务的动作交织在一起。智能体不是简单地预测最终答案,而是生成一个严格按以下结构组织的序列:
- 思考: 智能体解释它需要做什么。
- 行动: 智能体指定要使用的工具以及输入变量。
- 观察: 系统执行该工具,并将原始输出返回给智能体。
这个循环不断重复,直到智能体的“思考”判定最终目标已成功达成,此时它会执行最后的“结束”动作。
函数调用与工具绑定
现代 LLM,尤其是针对智能体工作流微调的模型,都是在包含 API 模式的数据集上训练的。函数调用是一种技术机制,通过它你可以向 LLM 提供一个 JSON 模式,定义可用的工具(包括函数名称、描述和所需参数类型)。LLM 本身并不执行代码;而是输出一个高度结构化的 JSON 对象,指明要调用哪个函数以及传递哪些参数。应用层(你的 Python 或 Node.js 后端)解析这个 JSON,执行本地代码,并将返回值反馈给 LLM。
多智能体编排
随着目标变得更加复杂,依赖单个全能智能体会变得效率极低,并且容易出现上下文窗口退化的问题。多智能体系统通过实例化多个专门的智能体来解决这一问题,每个智能体都有特定的角色设定、工具集和系统提示词。例如,一个软件开发工作流可能包括:
- 一个负责拆解用户需求的产品经理智能体。
- 一个负责编写代码的软件工程师智能体。
- 一个负责编写测试并标记编译错误的QA 智能体。这些智能体通过共享状态或消息队列进行通信,相互评估彼此的输出,直到最终产品满足既定标准。
用于智能体 AI 开发的工具和框架
开源生态中涌现了大量框架,旨在抽象构建生成式 AI 智能体所需的复杂编排逻辑。选择合适的框架在很大程度上取决于你的具体用例,范围从简单的数据检索任务到复杂的自主多智能体层级结构。
1. LangChain 和 LangGraph
LangChain 是构建 LLM 应用的基础框架。它为记忆、工具和向量存储提供了标准化接口。然而,传统的 LangChain 智能体依赖于遗留的
AgentExecutor
类,这些类可能难以调试。为了解决这个问题,生态系统中引入了 LangGraph。LangGraph 将智能体工作流视为有状态的有向无环图(DAG)或循环图。通过定义节点(函数/智能体)和边(条件路由逻辑),工程师可以对智能体的执行循环进行细粒度控制,从而支持人在回路中的审批以及显式的无限循环防范。
2. Microsoft AutoGen
AutoGen 由 Microsoft Research 开发,是一个专为多智能体对话构建的框架。它允许开发者定义多个“可对话智能体”,它们可以相互交流以解决任务。AutoGen 原生支持在 Docker 容器内执行代码,这使其在自主软件工程任务方面异常强大。其架构高度依赖消息传递,智能体解析传入的消息,执行本地逻辑或 LLM 查询,并将结果广播给拓扑结构中的下一个智能体。
3. CrewAI
CrewAI 是一个构建在 LangChain 之上的更高层级框架。它抽象了 LangGraph 复杂的图路由逻辑和 AutoGen 原始的消息传递机制,让开发者能够使用类似人类组织结构的方式来定义工作流。在 CrewAI 中,你需要定义“Agent”(包含角色和背景故事)、“Task”(具体目标)和“Crew”(整体团队)。它针对生产环境进行了高度优化,特别适合 Agent 需要以顺序或层级方式协作以达成业务成果的场景。
4. LlamaIndex
虽然 LlamaIndex 主要与检索增强生成(RAG)相关联,但它已经发展成为一个强大的 Agentic 框架。它的优势在于“数据 Agent”——专门为遍历、查询和综合海量企业数据而优化的 Agent。LlamaIndex 提供了可充当工具的高级查询引擎,使 Agent 能够根据用户的提示动态决定是运行 SQL 查询、执行向量搜索,还是扫描知识图谱。
不要碎片化地学习 AI——通过 IIT Roorkee CEC 认证,掌握一门结构化的 AI 工程课程,动手实践 GenAI 系统
如何构建你的第一个 AI Agent:分步指南
为了巩固这些概念,我们将使用 Python、LangChain 和 OpenAI API 构建一个基础的 AI Agent。这个 Agent 将拥有一组简单的工具——具体来说是一个数学计算工具——并利用 ReAct 框架来解决一个仅凭其基础模型权重无法解决的问题。
前提条件与环境配置
首先,确保你已配置好现代的 Python 环境。你需要安装 LangChain 核心库和 OpenAI 集成包。将你的 OpenAI API 密钥存储在一个
.env
文件中,以确保访问安全。
pip install langchain langchain-openai python-dotenv
第 1 步:定义工具
工具是经过装饰器处理的标准 Python 函数,用于向 LLM 暴露其函数签名和文档字符串(docstring)。文档字符串至关重要;LLM 会根据这段文本来准确理解何时以及如何使用该工具。
import os
from dotenv import load_dotenv
from langchain.tools import tool

load_dotenv()

@tool
def calculate_multiply(a: float, b: float) -> float:
    """Useful for multiplying two numbers together.
    Input should be two floats."""
    return a * b

@tool
def calculate_add(a: float, b: float) -> float:
    """Useful for adding two numbers together.
    Input should be two floats."""
    return a + b

tools = [calculate_multiply, calculate_add]
第 2 步:初始化 LLM 并绑定工具
我们实例化 LLM 并将工具模式(schema)绑定到它。绑定工具可确保模型在决定需要调用工具时正确地格式化其输出。
from langchain_openai import ChatOpenAI

# Initialize the reasoning engine (LLM)
llm = ChatOpenAI(model="gpt-4-turbo", temperature=0)

# Bind the tools to the LLM
llm_with_tools = llm.bind_tools(tools)
第 3 步:构建 Agent 框架
利用 LangChain 预构建的抽象层,我们可以快速组装 Agent。我们将从 LangChain 提示中心拉取一个专为工具调用型 Agent 设计的标准系统提示。
from langchain.agents import create_tool_calling_agent, AgentExecutor
from langchain_core.prompts import ChatPromptTemplate

# Define the system prompt instructions
prompt = ChatPromptTemplate.from_messages([
    ("system", "You are a helpful mathematical assistant. You must use the provided tools to calculate answers accurately. Never do math in your head."),
    ("human", "{input}"),
    ("placeholder", "{agent_scratchpad}"),
])

# Create the agent logic
agent = create_tool_calling_agent(llm, tools, prompt)

# Initialize the Executor (The While Loop that runs the ReAct paradigm)
agent_executor = AgentExecutor(agent=agent, tools=tools, verbose=True)
第 4 步:执行 Agentic 工作流
当我们向 Agent 执行器传递一个复杂查询时,它会分析请求,意识到需要执行加法和乘法运算,依次调用本地 Python 函数,并生成最终响应。
query = "If I have 15 apples and buy 23 more, and then I multiply my total by 4, how many apples do I have?"

response = agent_executor.invoke({"input": query})
print("Final Answer:", response["output"])
当这段代码执行时,详细的输出将展示 Agent 的内部推理过程。它会首先调用
calculate_add(15, 23)
,观察结果(38),然后再调用
calculate_multiply(38, 4)
,在返回人类可读的答案之前观察最终结果 (152)。
评估构建 Agentic AI 系统的成本
将 AI Agent 初学者指南部署到生产环境,需要对 Token 经济学有严格的了解。与标准 LLM 实现中一个提示等于一次补全不同,Agentic 架构是迭代式的。单个用户请求可能触发一连串的内部推理循环、工具调用和记忆检索。
Token 消耗倍增效应
在标准 RAG 流水线中,用户提示和检索到的上下文可能消耗 1,500 个输入 Token 并生成 300 个输出 Token。而在依赖 ReAct 框架的 Agentic 流水线中,上下文窗口会随着每一步持续增长。
- 第 1 步: 系统提示 + 用户查询 + 工具 Schema(输入:1,000 个 Token)-> 思考 + 行动(输出:100 个 Token)。
- 第 2 步: 系统提示 + 用户查询 + 工具 Schema + 第 1 步输出 + 工具观察结果(输入:1,300 个 Token)-> 思考 + 行动(输出:100 个 Token)。
- 第 3 步: 累积历史 + 新观察结果(输入:1,600 个 Token)-> 最终答案(输出:200 个 Token)。
由于 Agent 必须在每一步都摄取整个“草稿板”(其思考和观察结果的历史记录),输入 Token 的消耗会随着完成任务所需步骤数的增加呈二次方增长。工程师必须实施严格的防护措施,例如
max_iterations
,以防止失控的 Agent 在无限循环中耗尽 API 预算。
基础设施和托管成本
除了支付给基础模型提供商(OpenAI、Anthropic)的 API 费用之外,支持 Agent 的基础设施也占有相当大的比重。记忆架构需要高性能的向量数据库。虽然像 ChromaDB 这样的开源解决方案可以在本地运行,但企业部署需要像 Pinecone 或 Qdrant 这样的托管服务,它们按索引大小和读写操作收费。此外,执行 Agent 生成的不可信代码(尤其是在软件工程用例中)需要沙箱环境,这增加了动态 Docker 容器配置和临时计算资源的成本。
顶级 Scaler 讲师的免费课程
Agentic AI 解决方案的实际应用案例
生成式 AI Agent 的理论能力目前正在跨多个工程和运营领域转化为巨大的企业价值。它们自主导航复杂环境的能力正在颠覆传统软件范式。
1. 自主软件工程
AI Agent 正迅速成为 DevOps 和软件开发生命周期 (SDLC) 中不可或缺的一部分。像 SWE-agent 和 Devin 这样的系统能够自主解决 GitHub issue。给定一个代码仓库和 issue 描述,Agent 会克隆代码,使用沙箱化的 bash 终端浏览文件结构,阅读相关文件,编写补丁,运行测试套件,评估编译错误,根据这些错误重构代码,并最终提交 pull request。
2. 网络安全与自动化威胁狩猎
在安全运营中心 (SOC) 中,Agent 被部署用于对安全警报进行分类分诊。当 SIEM(安全信息与事件管理)系统标记出异常网络行为时,AI Agent 可以自主查询服务器日志,在安全沙箱中对可疑的可执行载荷进行逆向工程,交叉比对威胁情报数据库,并撰写一份完整的事件报告。这大幅缩短了安全工程师的平均响应时间 (MTTR)。
3. 动态数据工程与分析
数据分析师传统上要花费数小时编写样板式的 SQL 和 Python pandas 代码来提取洞察。数据 Agent 简化了这一流程。直接连接到数据仓库的只读副本后,Agent 可以接受自然语言查询,例如“找出我们第三季度欧洲市场营收下滑的根本原因”。Agent 会自主发现正确的数据库模式,编写并执行 SQL 查询,检索数据,分析其中的统计异常,生成通过 Matplotlib 绘制数据的 Python 代码,并交付一份最终的分析报告。
Agentic AI 的未来
随着生态系统的成熟,Agentic AI 的发展轨迹坚定地指向人工通用智能 (AGI) 的前身。当前一代的 Agent 虽然强大,但非常脆弱;它们会受到误差累积的影响——推理链早期出现的一次幻觉就可能使整个执行过程脱轨。
未来很可能由两个关键领域的改进主导:模型微调和分层架构。基础模型正越来越多地被明确训练用于具备 Agentic 能力——具体来说就是函数调用、JSON 解析和自我纠错——而不仅仅是简单的对话文本。
此外,我们将看到异步的、边缘部署的多 Agent 系统的兴起。不再完全依赖大规模的云端 LLM,直接部署在本地硬件上的更小、高度量化的开源模型(如 Llama 3 8B)将处理快速的、专门化的 Agent 任务。这些边缘 Agent 只在需要高层认知规划或复杂数据综合时,才会与云端的“管理者”模型协调。这些 Agent 的编排将模仿人类的组织结构,创建能够动态扩展计算资源以实时解决问题的数字劳动力。
Scaler 校友及其成功故事
常见问题(FAQ)
AI Agent 和 RAG 流水线有什么区别?
检索增强生成(RAG)流水线是一种线性的、只读的流程:系统从数据库中检索相关文档并提供给大语言模型(LLM),以生成有依据的回答。而 AI Agent 是循环式的,并且具备写入/执行操作的能力。Agent 可以把 RAG 仅仅当作众多工具中的一种,主动决定是否、何时以及如何搜索信息,然后再采取进一步行动,例如发送电子邮件或执行代码。
如何防止 AI Agent 陷入无限循环?
当 Agent 反复错误地使用某个工具、收到相同的错误却未能调整策略时,就会出现无限循环。工程师通过设置硬性
max_iterations
上限来缓解这一问题(例如在 5 步之后终止运行)。此外,注入明确的系统提示指令,例如“如果某个工具因相同错误失败两次,你必须停止并报告失败”,有助于 Agent 进行自我纠正。
生成式 AI Agent 会执行恶意代码吗?
会的。如果 Agent 被授予访问不受约束的 bash 终端或 Python REPL 的权限,它可能会无意中(或在遭遇提示注入时被恶意引导)执行破坏性命令(例如
rm -rf /
)。Agent 必须始终部署在严格沙箱化的环境中(例如网络访问受限的临时 Docker 容器),并在 API 密钥和数据库权限方面遵循最小权限原则。
是否有能够执行 Agent 工作流的开源模型?
有。虽然 GPT-4 和 Claude 3.5 Sonnet 等专有模型凭借其庞大的参数规模和推理深度在复杂的 Agent 任务中占据主导地位,但 Meta 的 Llama 3(70B)和 Mistral 的 Mixtral 8x22B 等开放权重模型在配合合适的系统提示和框架时,也完全能够胜任函数调用和多 Agent 编排。