深度剖析
面向智能体式 AI 的循环工程
循环工程是指设计受控的 AI 循环,其中 AI Agent 进行规划、执行、观察、评估并重复,直到可以安全停止。
| 为什么我们需要循环? |
普通的提示词是线性的:你向模型提出一个问题,它生成一个答案。这对于摘要、起草和许多知识型任务很有用。但企业级 AI Agent 往往需要做更多。它可能需要检查数据、调用工具、对比多个来源、发现证据缺失、尝试不同的操作,并判断最终结果是否足够好以便返回。
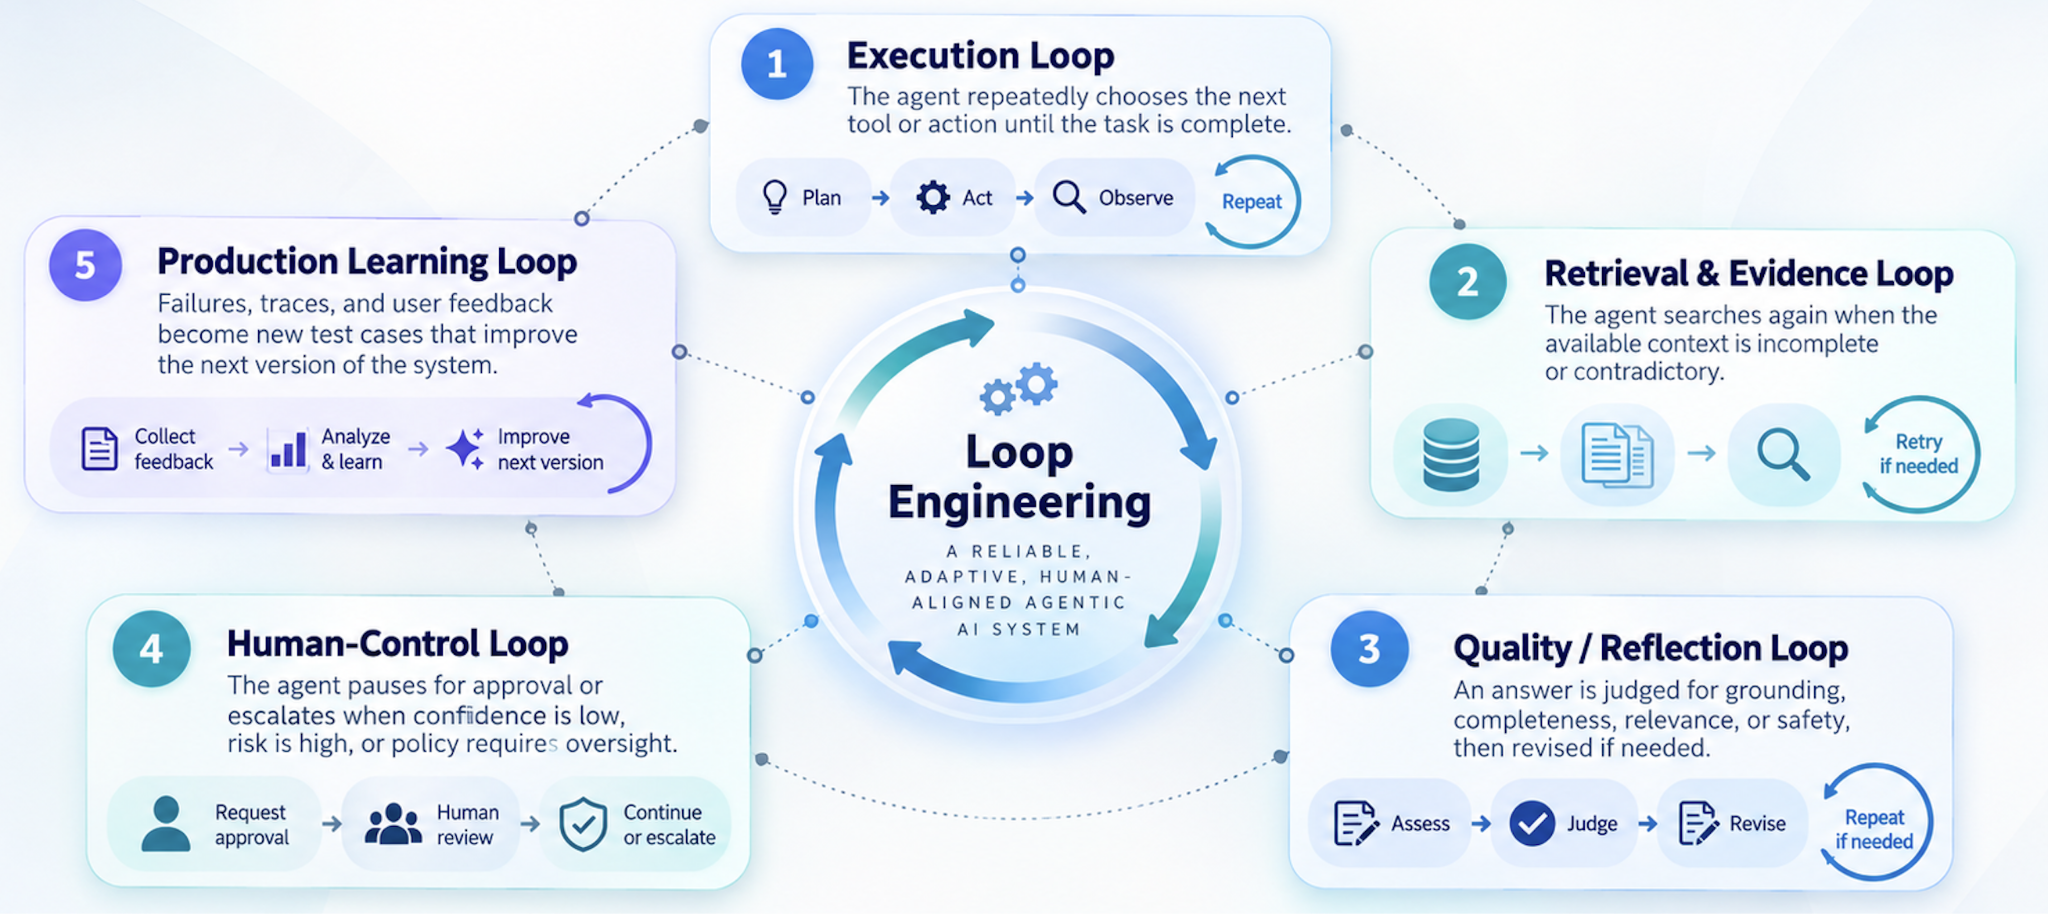
这就是循环工程的起点。我们不再把模型响应视为工作流的终点,而是把它视为受控系统中的一个步骤。系统会保持状态、观察发生了什么、评估进展,并决定接下来应该做什么。
区别可以概括为:提示词工程改进单次响应;智能体工程为模型提供工具和操作;循环工程则围绕这些操作设计反复进行的决策过程。
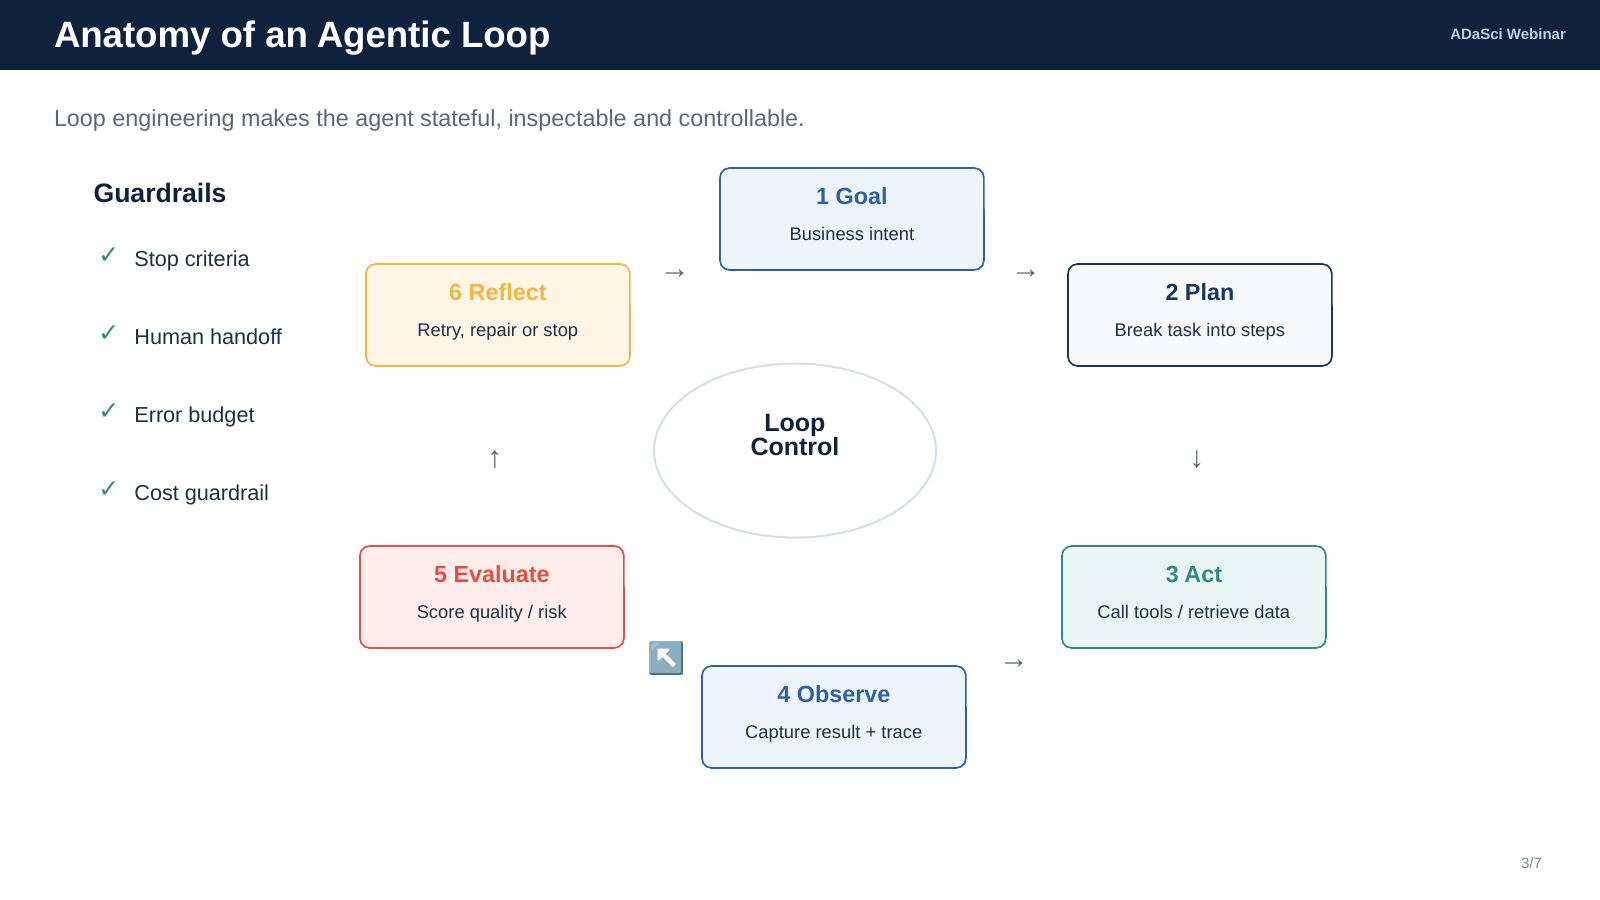
图:智能体循环的解剖结构:目标、规划、执行、观察、评估和反思——四周环绕着护栏。
核心循环:规划 -> 执行 -> 观察 -> 评估
一个对初学者有用的模型包含六个步骤。目标定义业务成果。然后 AI Agent 规划下一步,通过调用模型、工具或数据源来执行,并观察结果。评估环节检查结果是否有用、有据且安全。如果不是,AI Agent 会反思或重新规划,并采取另一个行动。
最重要的设计决策往往不是模型本身,而是围绕模型的控制逻辑:允许重试多少次?什么才算足够的证据?当两个数据源不一致时应该怎么办?系统何时应该停止?何时应该由人来批准下一步?
| A loop is useful when: the task needs multiple actions, evidence can be incomplete, or an output must be validated before it is returned. |
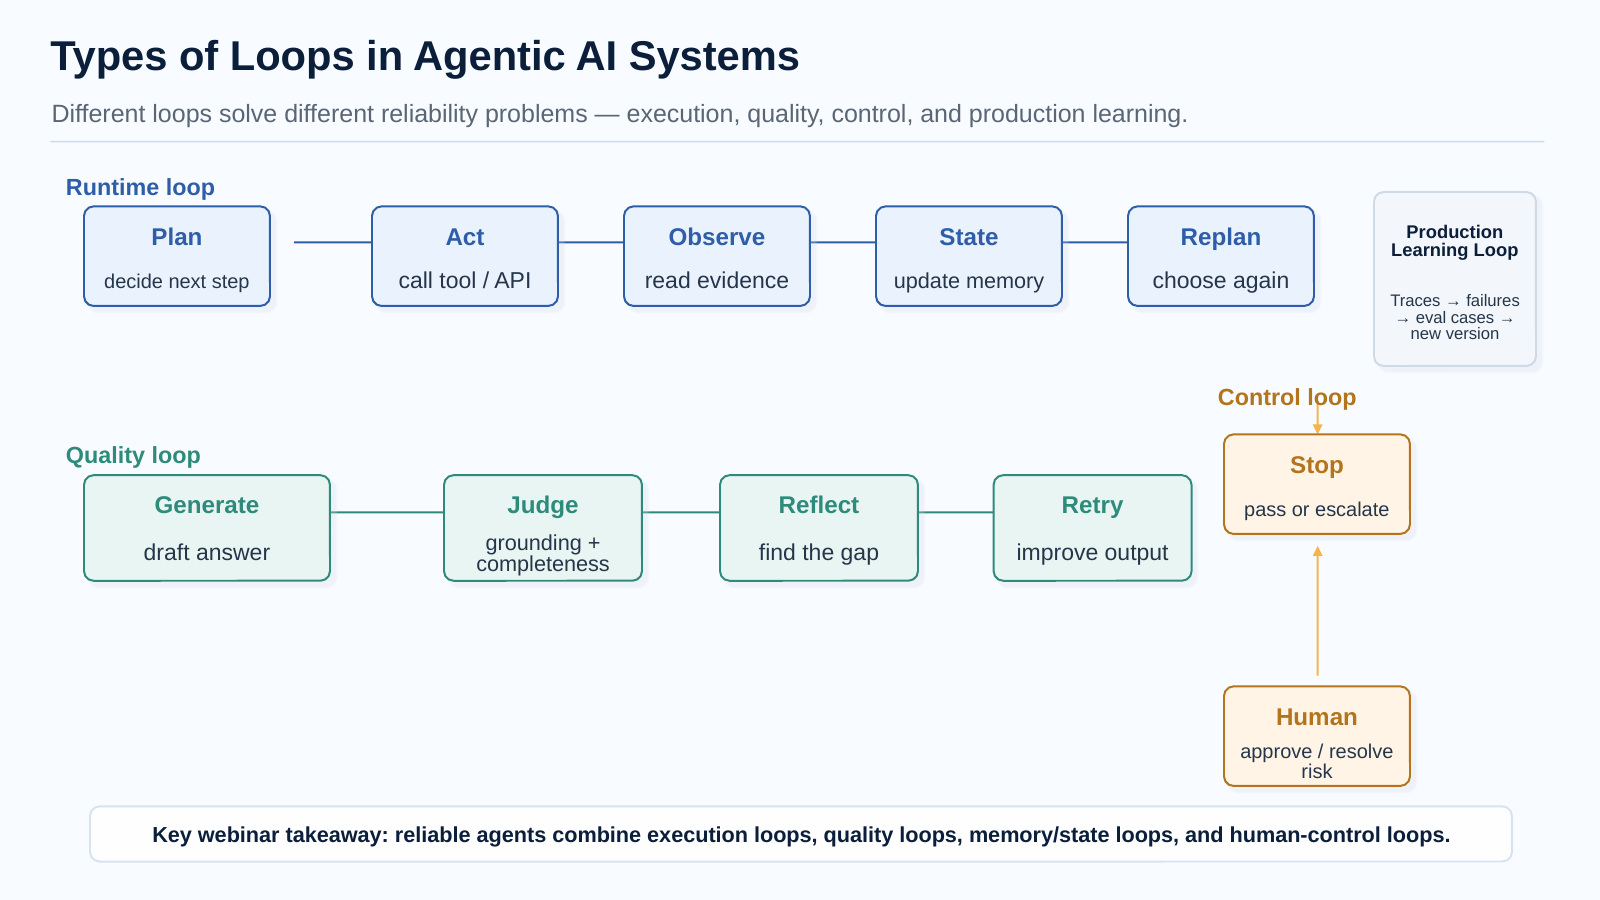
图 - 不同的循环解决不同的可靠性问题:执行、质量、控制、记忆和生产学习。
五种值得了解的循环模式
- 执行循环(执行者)——AI Agent 反复选择下一个工具或操作,直到任务完成。
- 检索与证据循环(研究者)——当可用上下文不完整或相互矛盾时,AI Agent 会再次搜索。
- 质量或反思循环(编辑者)——对答案的有据性、完整性、相关性或安全性进行评判,必要时进行修订。
- 人工控制循环(护栏)——当置信度低、风险高或政策要求监督时,AI Agent 会暂停等待批准或进行升级处理。
- 生产学习循环(飞轮)——失败案例、追踪记录和用户反馈成为新的测试用例,从而改进系统的下一个版本。
这些循环可以组合使用。生产级 AI Agent 可以在质量循环内嵌套执行循环,对高风险动作设置人工把关,并让生产反馈循环随时间持续运行。
Wanderbricks 演示:亲眼看到循环的运行
该笔记本使用 Databricks 内置的 Wanderbricks 示例数据构建一个小型旅行支持调查 Agent。设想一个预订案例,需要调查其预订状态和支付状态。Agent 不是预先连接所有表并让模型一次性给出答案,而是逐步推进。
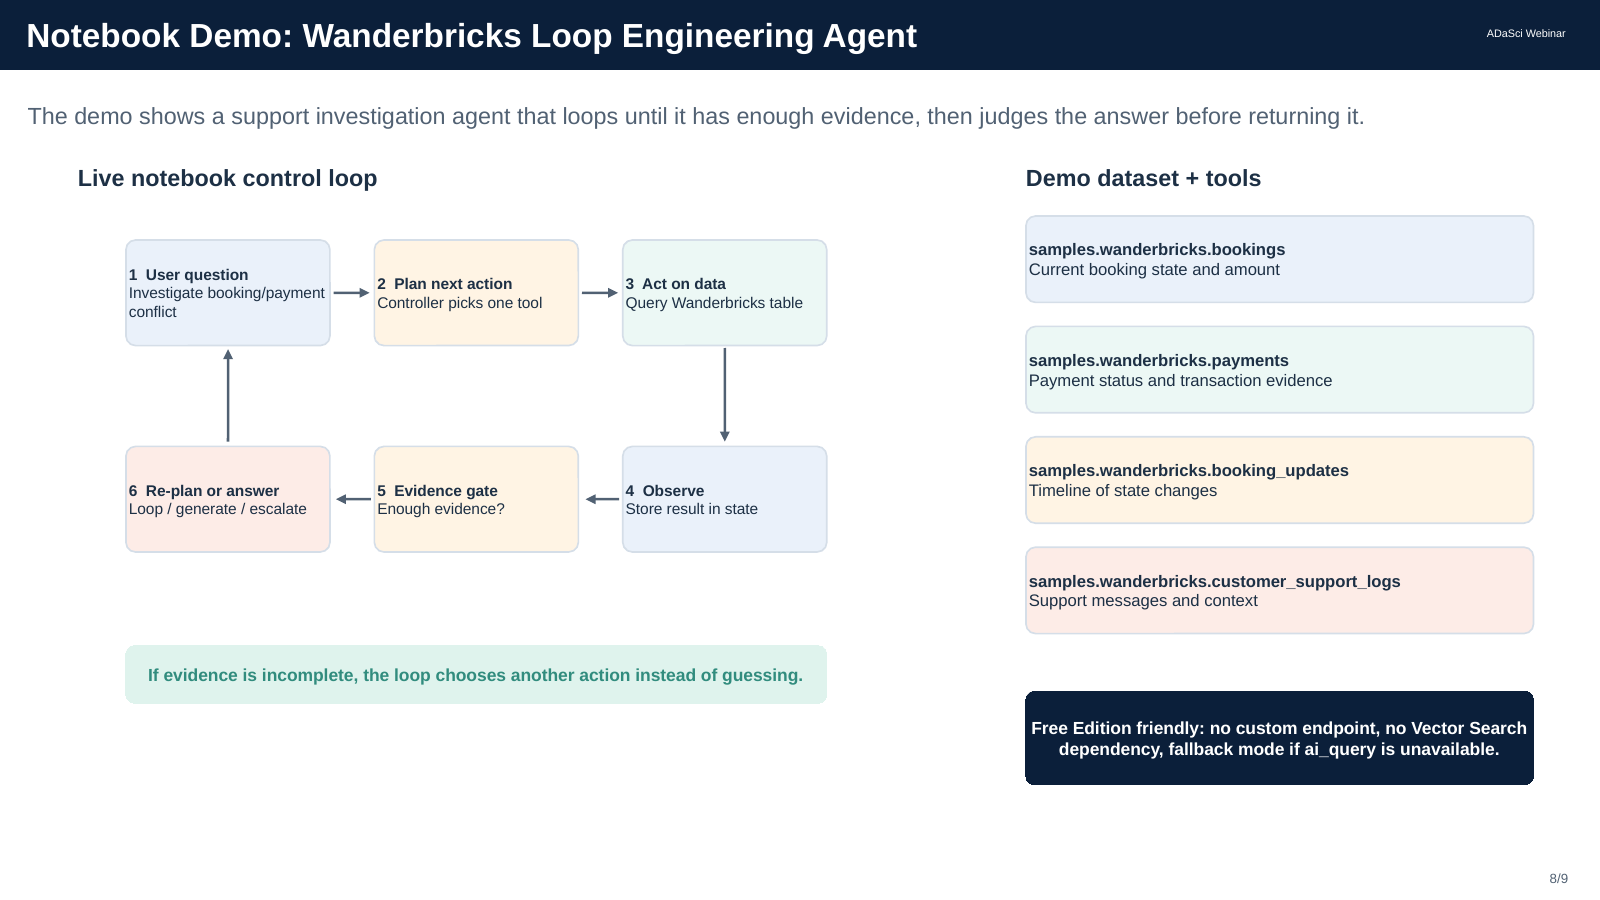
图 . 笔记本演示让循环变得明确:选择一个动作、查询证据、观察、评估,仅在需要时继续。
第一次迭代可能检查预订记录。证据门控判定这还不够,于是循环继续检查支付记录。接着它可以检查预订更新和客户支持历史。只有当证据门控满足时,Agent 才生成答案。第二个质量循环对该答案进行评判,要么通过,要么附带批评意见重试,要么在达到重试上限后将案例转交人工审核。
| Key engineering idea: The model can propose the next action, but the system owns the state, quality gates, retry budget and stop conditions. |
可靠的循环需要边界
没有控制的循环可能变得昂贵、缓慢或不可预测。因此生产级循环工程需要明确的边界:最大迭代次数、时间和成本预算、允许使用的工具、证据要求、置信度阈值、可审计性和人工升级机制。可观测性至关重要,因为当 Agent 失败时,团队需要知道是哪个动作、检索结果或决策导致了失败。
这就是循环工程与评测紧密相关的原因。一个系统若无法衡量进展,就无法决定继续还是停止。有些检查可以是确定性规则,有些则可以使用基于模型的评判器或领域专家审核。正确的组合取决于业务风险。
FDE:把循环从原型带到生产
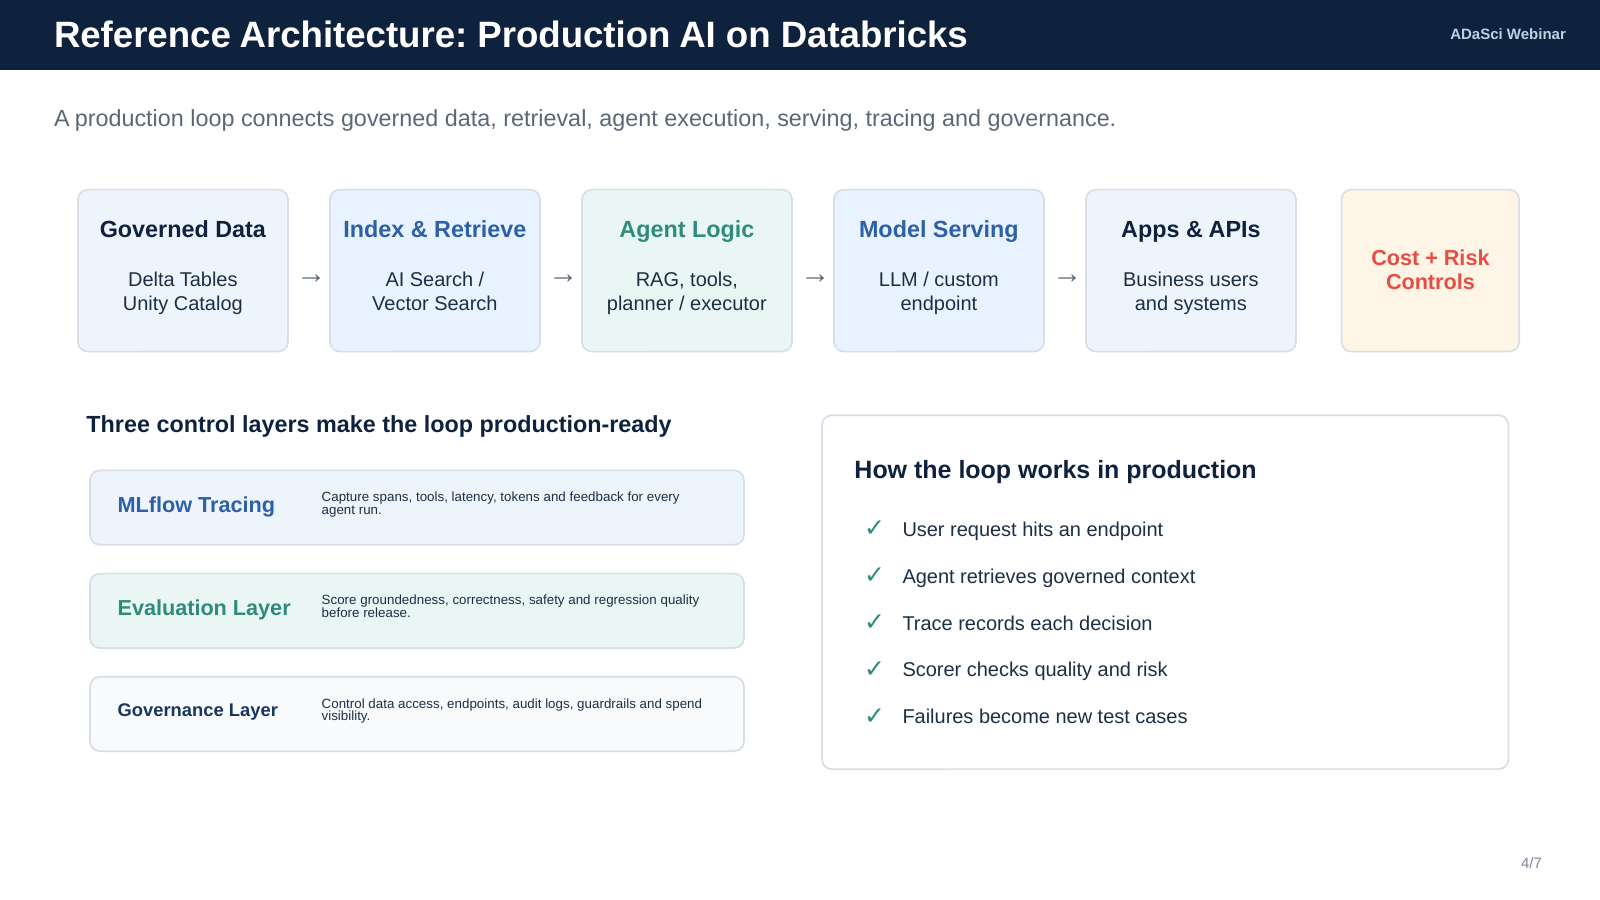
图 - 生产级 AI 连接受治理的数据、Agent 逻辑、评测、服务与控制——这正是 FDE 的工作环境。
前沿部署工程师(FDE)贴近客户的业务问题、数据和用户开展工作。这一角色并非孤立地构建模型,而是把一个成果变成可运行的系统,将其接入真实的工作流,从生产行为中学习,并在部署后持续改进。
这使得循环工程与 FDE 的工作直接相关。FDE 帮助定义当证据不完整时 Agent 应该做什么、可以调用哪些工具、如何衡量成功、应该在何处引入人工干预,以及生产反馈如何转化为下一次改进。因此,FDE 工程化的不仅是 AI 能力,还有围绕它的运营循环。
代码实现
Notebook: Loop_Engineering_Wanderbricks_Databricks_Free_Edition.ipynb
该实现将一次旅行支持调查转化为两个受控循环。第一个循环逐个来源收集证据;第二个循环评估生成的答案,并决定接受、重试或升级处理。关键的设计选择是:状态、工具使用、质量门控和停止条件都在代码中显式定义,而不是完全交给模型处理。
1 | 四个基于表的工具:受控操作,而非一个巨型查询
该 Agent 提供四个基于 Wanderbricks 表的小工具:booking、payment、booking_updates、support。每个工具代表控制器可以选择的一个独立操作。这与先把所有表连接起来再查询的做法刻意不同:Agent 先查看一个操作的结果,将其存储在状态中,然后决定下一步需要什么证据。
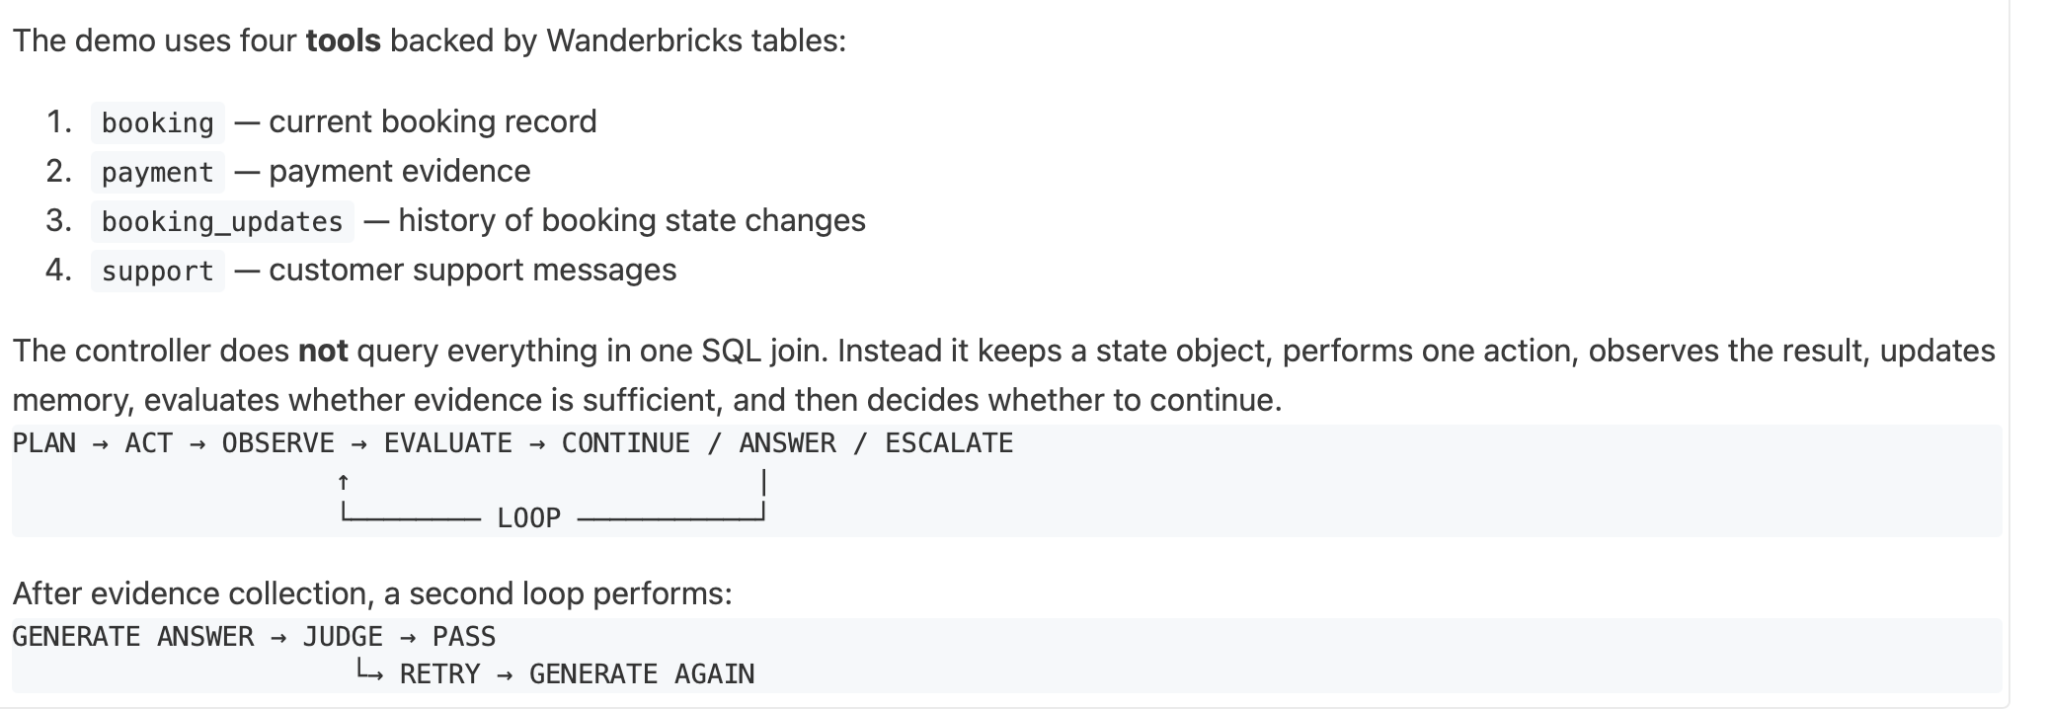
图 - 四个 Wanderbricks 工具以及该 notebook 中使用的双循环控制模式。
2 | 证据收集循环 + 答案质量循环
| 证据循环 | PLAN → ACT → OBSERVE → EVALUATE → CONTINUE / ANSWER / ESCALATE |
| 质量循环 | GENERATE ANSWER → JUDGE → PASS,或 RETRY → 再次 GENERATE |
注意:证据循环使检索具有自适应性,而质量循环则防止第一个看似合理的答案自动成为最终答案。两个循环都受显式重试上限和人工审核路径的约束。
3 | 运行循环:执行历史使控制逻辑可见
run_loop() 调用会执行完整的控制器。每次操作后,notebook 会向 history 追加一条记录,包含迭代次数、操作、观察到的行数、决策及原因。将该历史转换为 Spark DataFrame 后,可以为观众提供简单的审计轨迹:你可以看到控制器何时继续收集证据,何时最终进入答案生成阶段。
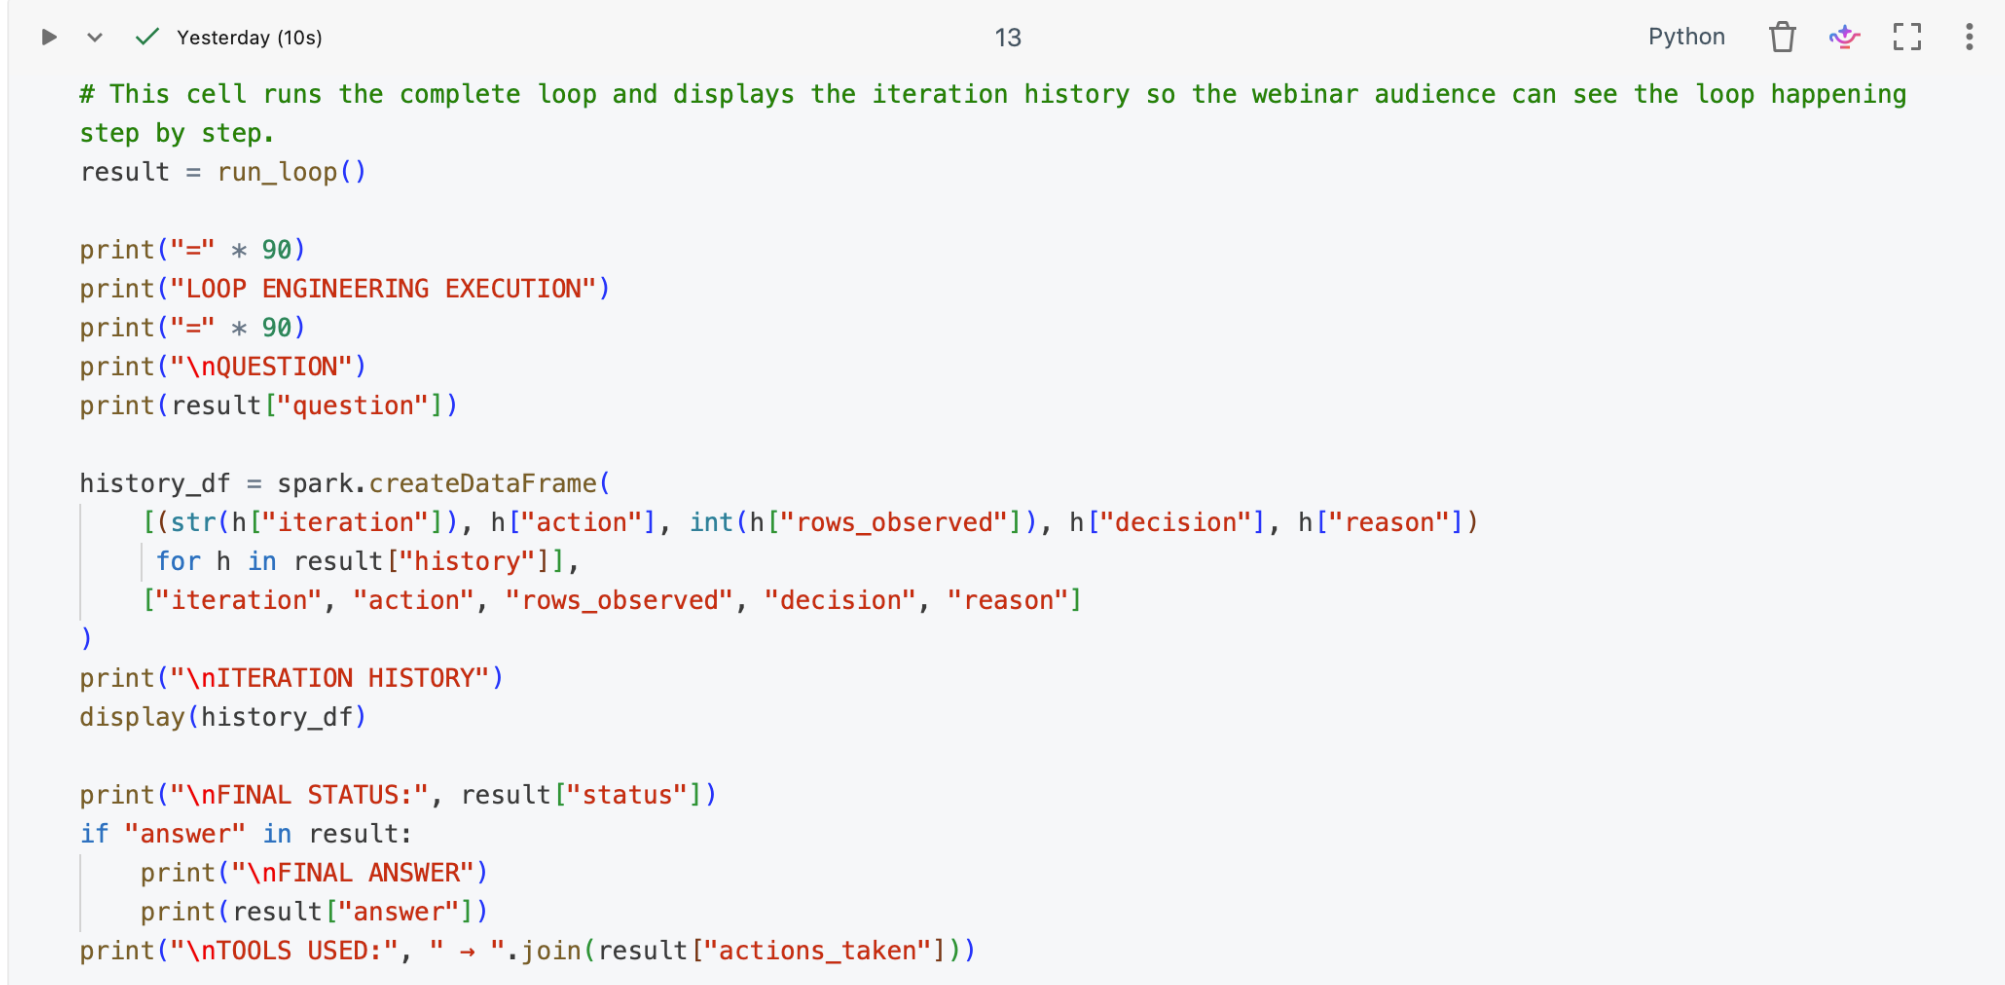
图 - notebook 执行循环并渲染迭代历史,然后展示最终状态和答案。
4 | 证据作为可检查的状态被保留
循环工程的一个关键原则是:观察结果不应消失在提示词中。该 notebook 将结果存储在 result["evidence"] 下,并按来源分组。因此,最终答案可以对照预订记录、支付事件、预订更新和支持上下文进行核查。在示例运行中,预订已被取消,且支付历史同时包含已完成的扣款和对应的退款,使 Agent 能够基于证据推荐一个安全的下一步操作。
| Final status and answer | 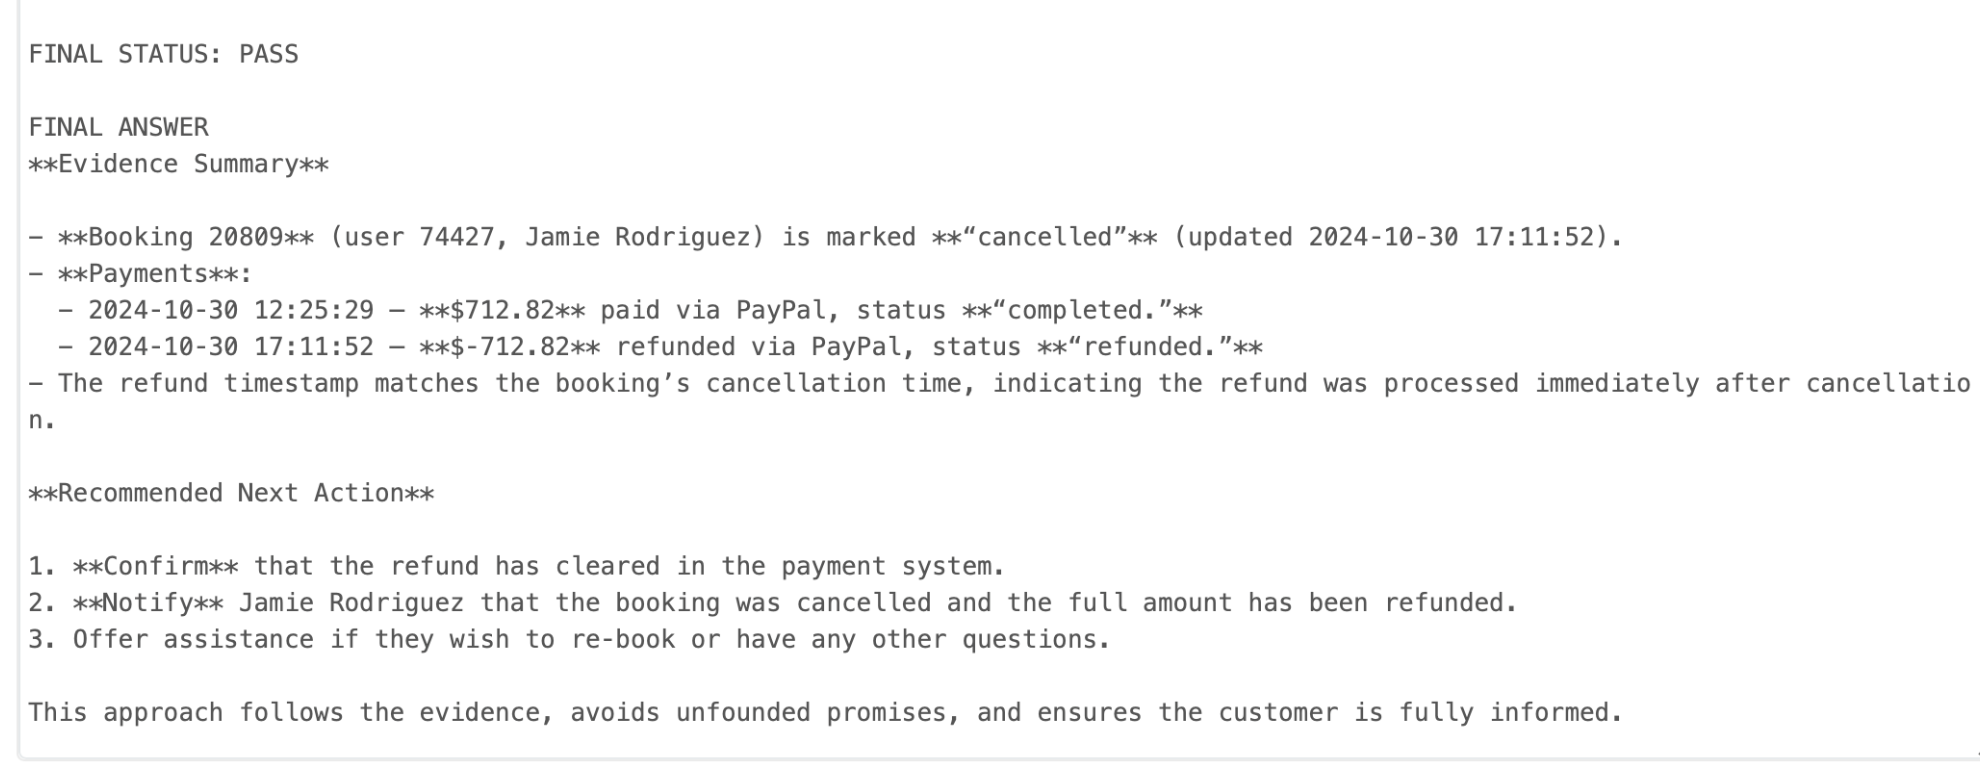 | Evidence memory | 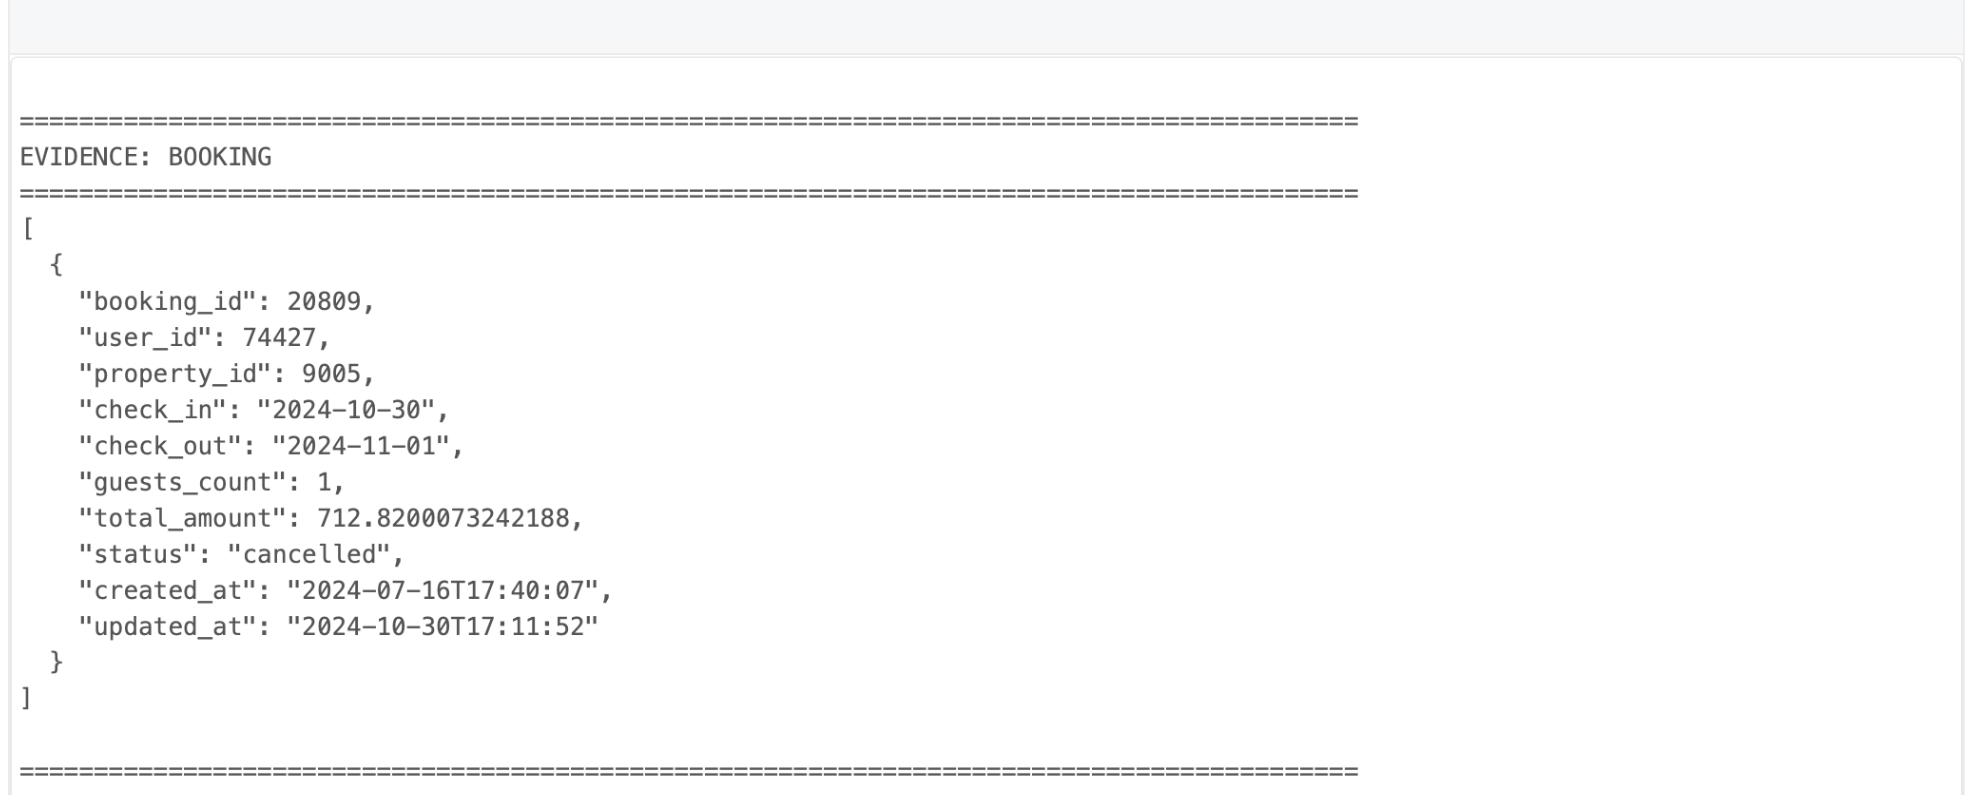 |
图 3. 循环在 PASS 时停止,而证据仍保持可见,以便审计、解释和人工审核。
| 实施要点:LLM 负责生成和评判,但外围的 Python 控制器掌握状态、工具调用顺序、重试上限、证据充分性以及停止/升级决策。正是这种分离,把一个 Agent 演示变成了一个工程化的循环。 |
核心要点
从小处着手:给 Agent 一个目标、少量工具、明确的状态、清晰的质量检查、有上限的重试次数以及人工接管机制。一旦这个循环清晰可见且可测试,它就可以逐步成长为具备更丰富记忆、追踪、治理和持续学习的生产系统。
| Reliable agentic AI is not just about a smarter model. It is about engineering what happens before, after and between model calls. |
一个实用的下一步是探索 ADaSci 的 FDE Track。该方向提供前沿部署工程认证,这一学科与循环工程高度契合,因为它专注于在真实环境中构建、部署、评估和改进 AI 系统。
更多详情请见 - https://adasci.org/certifications/cfde-pro