你不应该在生产环境中信任 AI Agent
OpenAI 表示,AI 编码的真正工作在于构建其周围的系统
OpenAI 前沿部署工程师 Luis Velasco 表示,我们正在进入一个新领域:元软件工程。
工程师不再需要构建遵循预定义操作序列的软件,而是需要围绕 AI Agent 构建系统,为其提供上下文、工具、技能、约束条件以及评估其工作的方法。
最难的部分永远是上下文
对 AI Agent 来说,代码更容易处理。代码库是有结构的,结果也容易验证,因为代码可以编译、测试可以通过。Luis 解释说,业务工作流则要混乱得多:
在业务工作流中,上下文是碎片化的,分散在人员和系统之间。一条 Slack 消息可能解释了某个决策为何改变,一个遗留应用可能保存着数据状态,而一位经验丰富的同事知道那些没人写下来的部分。我们试图自动化的工作项依赖于所有这些内容。
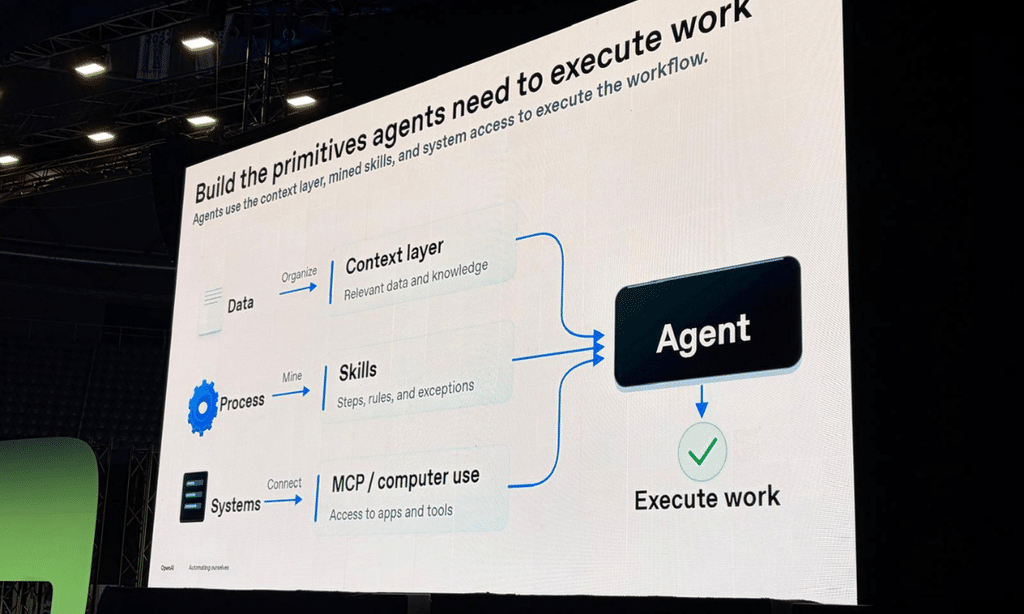
要让 Agent 完成这项工作,工程师首先必须重构工作发生的上下文。Velasco 将其分解为三个要素:数据、流程和系统。
数据为决策提供信息和领域知识。流程定义规则、例外情况和时间线。系统提供让工作得以完成的应用和 API,并具备相应的权限。
Agent 需要一个保持最新、并为其提供与任务相关信息的上下文层。流程可以转化为 Agent 技能,而 API 和其他系统则赋予 Agent 执行工作的能力。Velasco 用一个保险理赔工作流展示了这一点:Agent 读取了一封电子邮件及其附件,在多个应用中核对信息,验证了理赔申请,计算了赔付金额,并在 22 秒内准备好了回复,而不是原来的 20 到 30 分钟。
一切运行良好,直到需要大规模运行
让一个 Agent 完成一个工作流只是开始,因为真正的挑战始于该工作流需要大规模运行之时。此时 Agent 必须并行工作,工作流可能变得相互关联,一个 Agent 的结果可能成为另一个 Agent 的输入:
这可以通过共享上下文的 Agent 和子 Agent 来处理,也可以通过一个独立的环境来处理,让 Agent 能够读写共享状态。该状态帮助它们恢复已完成的工作,并弄清楚接下来需要做什么。
这就是为什么围绕 Agent 的基础设施至关重要:队列、工作进程、检查点,以及存储结果、证据和报告的工件库。目标是构建一个持久化的执行环境,能够在发生崩溃时恢复,并避免重复执行同一任务。
多 Agent 系统需要的不只是额外的模型调用
Velasco 通过一个专注于 CPU 设计的实验展示了这在更大规模下的样子:一个活动控制器将目标、预算和工作分配到不同的 CPU 领域,由 512 个 Agent 分别负责算术、内存排序和控制流等领域。
他解释说,这些 Agent 有不同的角色:一些负责寻找潜在 bug,批评 Agent 对它们的发现提出质疑,验证 Agent 则尝试复现这些问题。该活动运行了四天,使用了约 1.4 TB 的数据,并在问题进入生产环境之前生成了可与验证工程师共享的证据。
这表明多 Agent 系统需要协调、共享状态、验证以及一种在众多 Agent 之间管理工作的方式,而不仅仅是额外的模型调用。
系统可以在不改变模型的情况下学习
Velasco 方法的另一个重要部分是,模型本身并不总是需要变得更强大,整个系统才能得到改进。他将其比作一名经验丰富的员工:
一名资深员工的基本智力可能与刚入职时相同,但经过多年的经验积累,他们熟悉系统、常见的失败模式以及让自己更高效的细节。
对于 Agent 来说,这种经验存在于模型周围的系统中。
更新的上下文可以提供相关知识,更新的技能可以改进工作的执行方式,评测可以检查需要验证的行为。模型权重可能保持不变,而模型周围的系统通过反复执行变得更好。
Velasco 说,成功的运行、失败和人工纠正在这里都有帮助。成功的运行显示应该强化什么,失败显示需要改进什么,人工纠正则揭示 Agent 技能上的差距。随着时间推移,这些模式可以更新记忆、上下文、技能或评测集。
他用一个报税 Agent 展示了这一点:它最初只能完成约 25% 的必填字段,经过六周的反复运行、评测和技能更新后,达到了接近 90%。
工程将成为元软件工程
这改变了工程师的角色。随着更多执行工作被委托给 Agent,工程师会花更多时间设计和改进执行工作的系统。但工程并不会消失,人类仍然设定目标、做出权衡,并决定哪些地方需要人工干预。
这引出了 Velasco 对工程师在 AI 辅助环境下所构建内容的更宽泛定义:
我们可能创造的价值最高的软件产物不是代码库本身,而是意图、约束和评测的系统,代码可以从中以系统化、可重复的方式被生产出来。
他将这一新兴学科称为元软件工程:围绕 AI 构建环境,让 AI Agent 拥有合适的上下文、工具、技能、协作机制和反馈,从而完成工作并不断改进。
软件工程的下一个篇章,是围绕代码构建整个系统。