用 LangGraph 模板解决 ARC-AGI-3 基准测试
我们与 ARC Prize 团队合作,构建并开源了一个 LangGraph 起始 Agent:一个有状态的多 Agent 模板,能够学习解决 ARC-AGI-3 推理基准中的第一个游戏 LS20。它没有硬编码规则,而是在多 Agent 图中结合了记忆、视觉、规划和空间推理,因此能够适应新环境。
作者:Sophia Willows 和 Anusheel Bhushan
基准测试
ARC-AGI-3
游戏
LS20
框架
LangGraph
代码
开源
为什么 ARC-AGI-3 很重要
传统 AI 基准测试是静态的:它们针对固定数据集和预定答案进行测试。ARC-AGI-3 则不同。它是首个大规模交互式推理基准测试,将 Agent 投入一个动态环境,不提供任何先验指令,要求它自己摸索出规则。
为此,Agent 必须展示五项核心能力:
- 探索
- 感知、规划、行动
- 记忆
- 目标获取
- 对齐
该基准测试将涵盖大约 100 个独特环境。成功与否取决于 Agent 获取新技能并泛化到从未见过的任务的速度,而不是死记硬背。
游戏:LS20
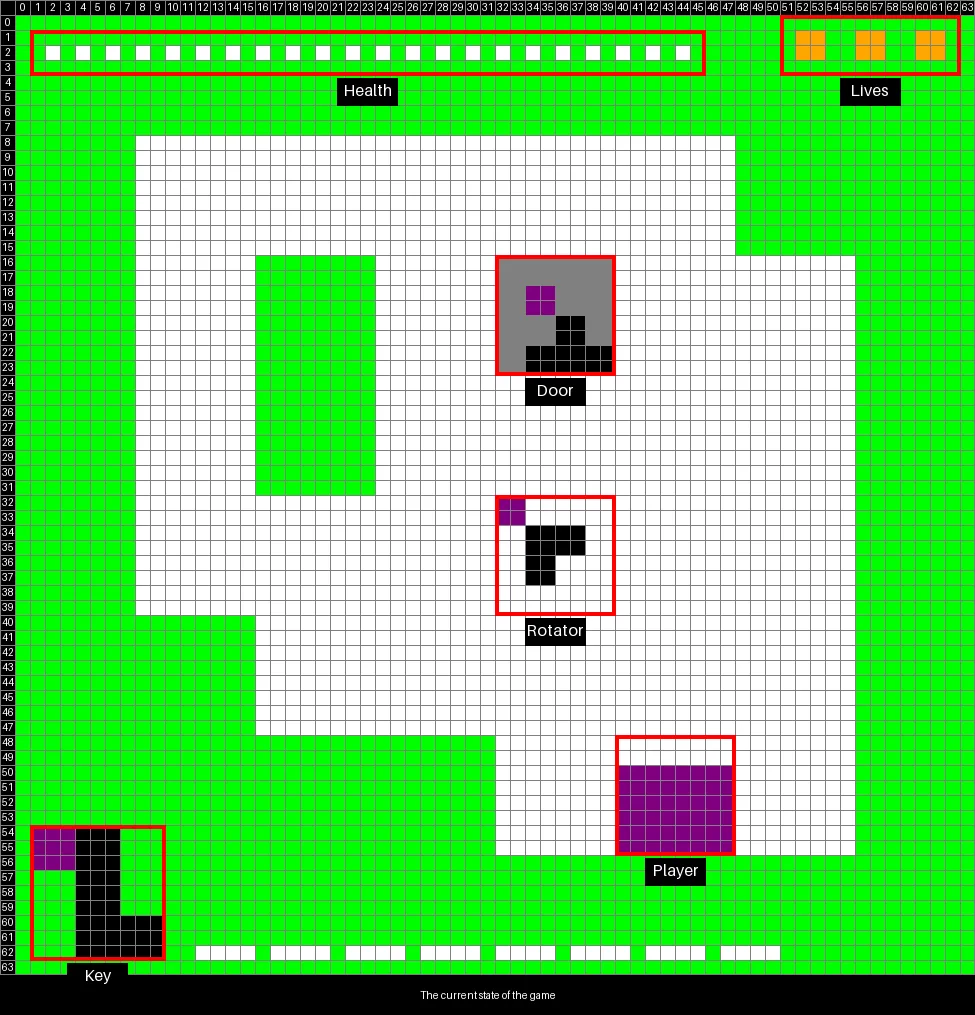
LS20 看似简单,实则不然:
- 一扇锁着的门只有在你持有的钥匙与其形状匹配时才会打开。
- 穿过旋转器会循环切换你手中钥匙的形状。
- 每次移动都要消耗一点生命值,因此探索并非没有代价。
为什么选择 LangGraph
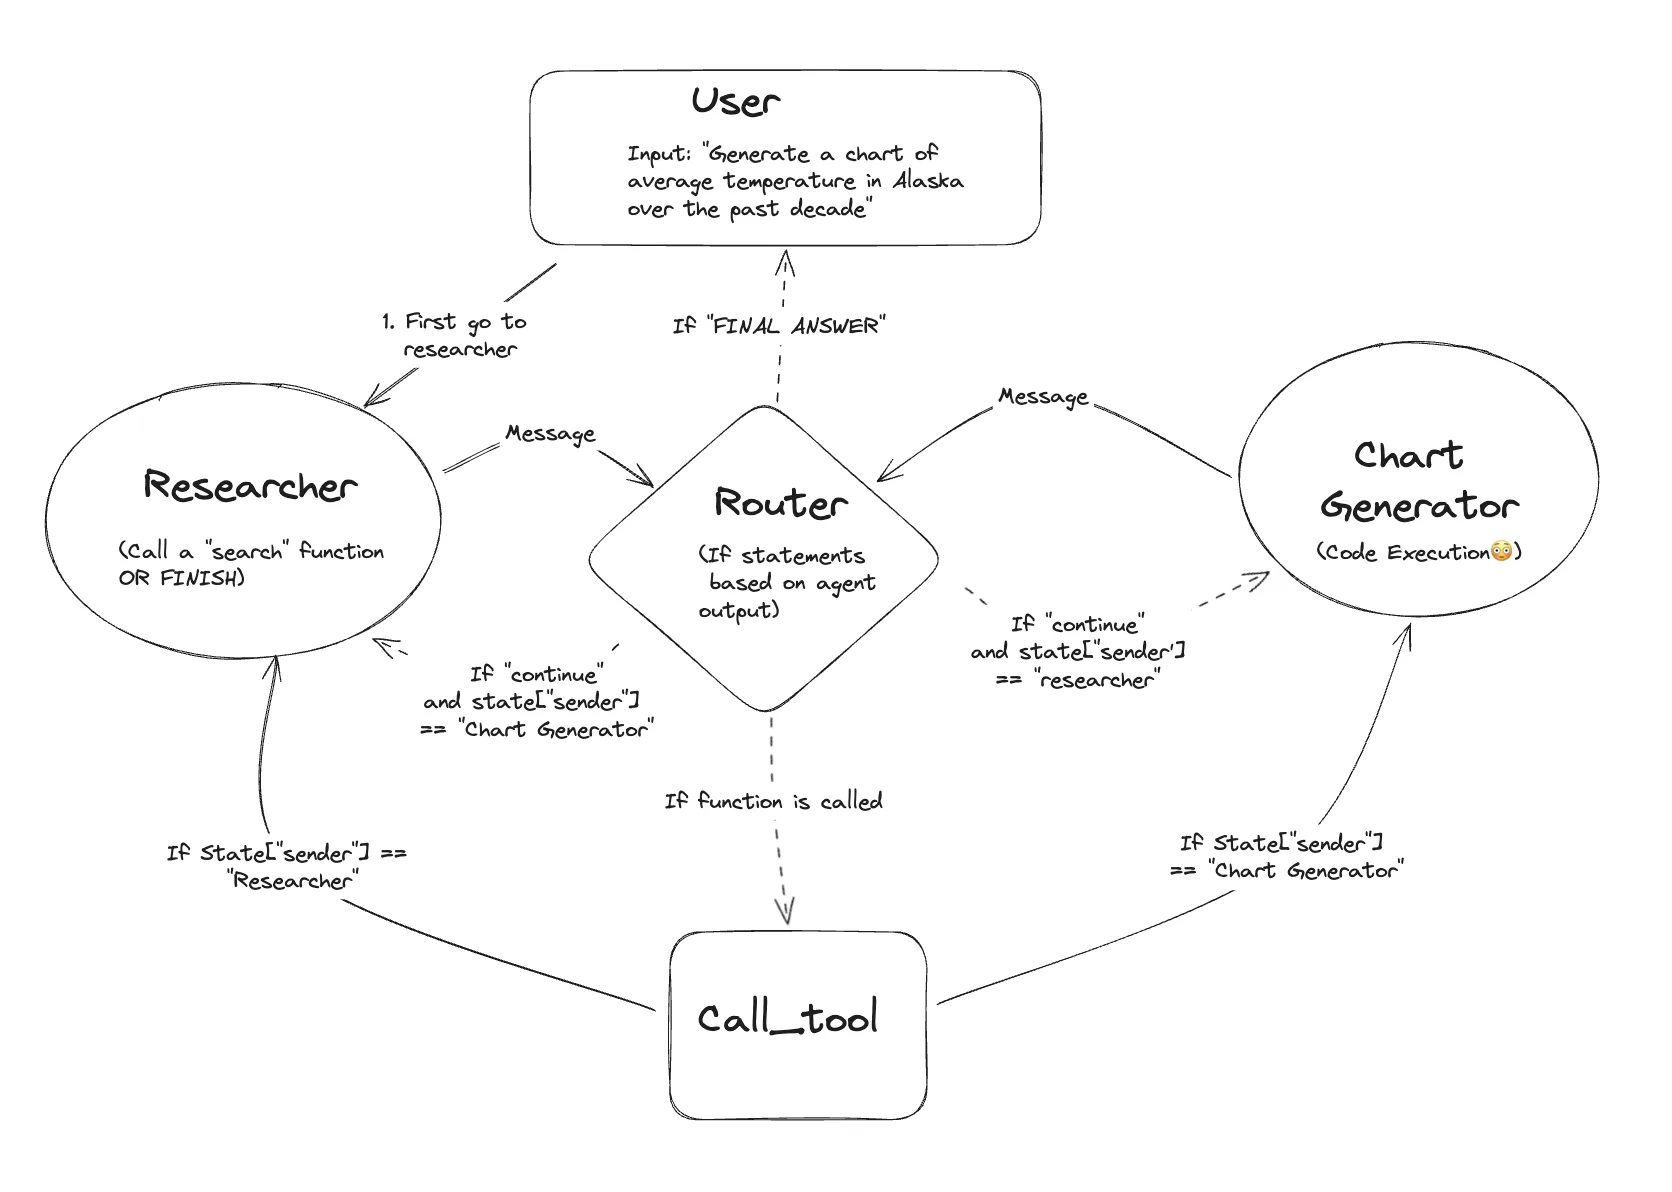
我们选择 LangGraph 是因为它支持有状态的多 Agent 工作流:基于图的系统,Agent 可以动态协作,同时在长时间执行中保持状态。决定性的优势在于 LangGraph 的图就是代码,因此监督 Agent 可以在运行时修改工作流。这正是 ARC-AGI-3 所需的递归自我改进系统的关键。
我们是如何构建的
记忆。该 Agent 使用三层记忆系统。短期记忆受 Claude 的 think 工具启发,让它能够对即时观察进行反思。长期记忆是通过 LangGraph 的 SqliteStore 实现的持久化 SQLite 存储。观察日志保存 Agent 自己关于游戏机制的笔记,并被重新加载到系统提示词中,同时提供思考、观察和删除观察的工具,随着其理解的加深不断更新。
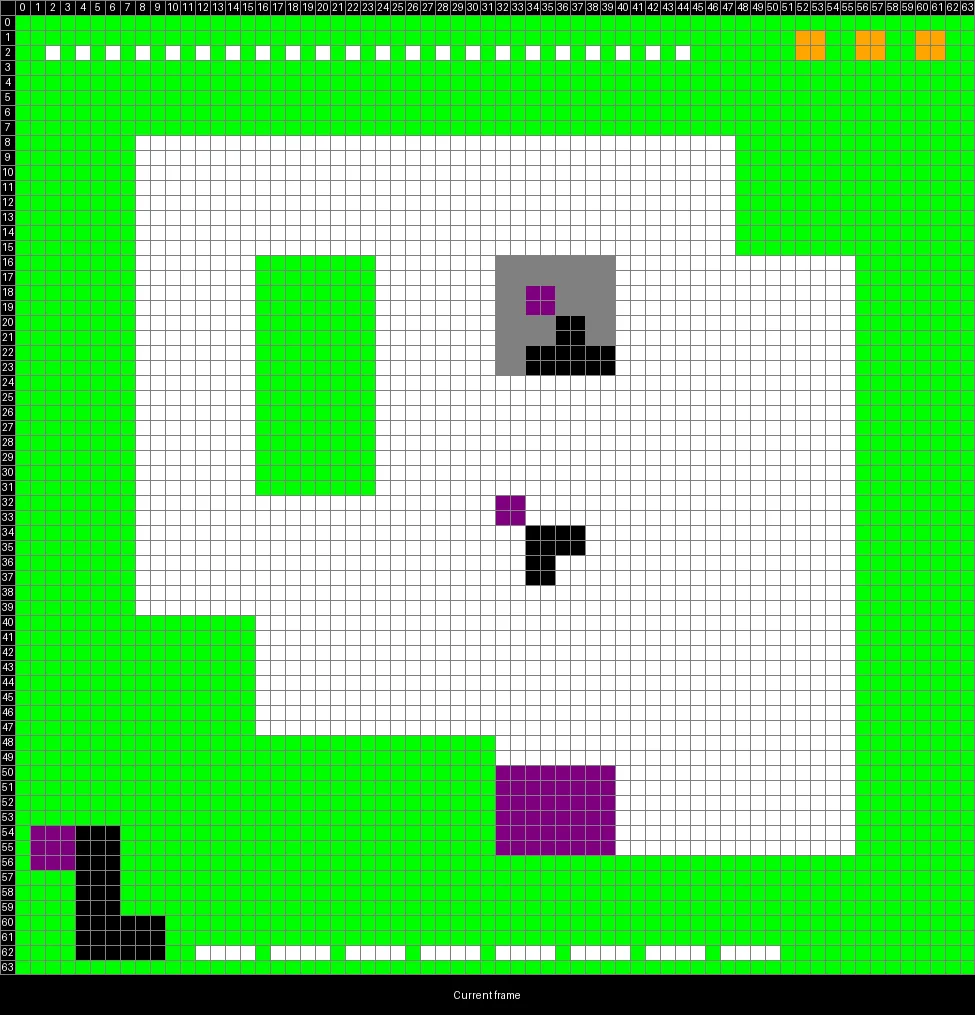
视觉。帧以多维 JSON 数组的形式到达,其中位置是坐标,值是颜色。我们使用 Python 的 Pillow 以更高对比度的调色板进行渲染,将每一帧与前一帧进行比较以检测变化,并突出显示重要元素,这一方法受 Browser Use 启发。这种 Delta 跟踪让 Agent 无需专用寻路器就能识别玩家移动。
规划。 AI Agent 起初难以推断总体目标,因此我们在系统提示词中提供了上下文:
- 在持有正确钥匙的情况下到达门。
- 你持有的钥匙显示在左下角。
- 绿色元素是墙壁。
- 旋转器会在你与其碰撞时改变你的钥匙。
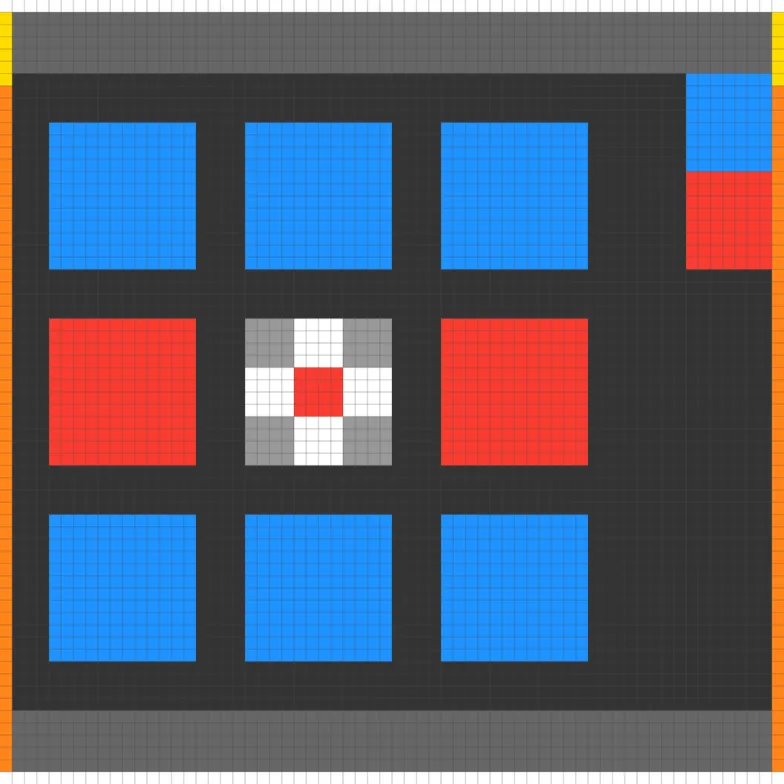
空间推理。 一个专用的 LangGraph 节点将玩家的钥匙形状与门的要求进行比较。寻路最初是硬编码的 A*,后来我们用通用的 Delta 跟踪取代了它,由多模态模型直接读取帧变化。正是这一转变使该模板能够向跨不同游戏泛化的方向发展,例如 FT09——一款机制完全不同的点击方块游戏。
结果
AI Agent 以最优步数解出了 LS20 的第一关。它识别到自己持有错误的钥匙,径直寻路到旋转器进行交换,拿到正确钥匙后再前往门。
第二关需要策略性的生命值管理和多次使用旋转器,目前的模板尚未解开,这是留给社区继续构建的开放扩展点。
结论:空间推理,加上几条关于环境的提示词提示,就足以达到这一步。这种方法在脚手架与习得能力之间取得平衡,而不是追求纯粹的零样本解决方案。
欢迎贡献
构建能够学习并调整自身问题解决方法的系统,是 AI 领域最令人兴奋的前沿之一。我们与 ARC Prize 团队共同构建了这个 AI Agent,并将其开源为 LangGraph thinking agent partner template,社区可以通过 ARC-AGI-3 Agents toolkit 在其基础上进行构建。
参考资料
将嵌入式 AI 团队纳入你的路线图
前沿部署工程师负责部署,AI 原生工程师负责构建,按需 QA 团队负责验证,全部嵌入你的团队,当天即可启动。