在机器学习领域,数据的质量至关重要,因为它是所构建模型的基础。数据清洗(data cleaning),也称为数据清理(data cleansing)或数据净化(data scrubbing),是指识别并纠正数据集中的错误、不一致和不准确之处的过程。这是一个至关重要却常常被低估的步骤,在决定任何机器学习项目的成败方面都发挥着关键作用。
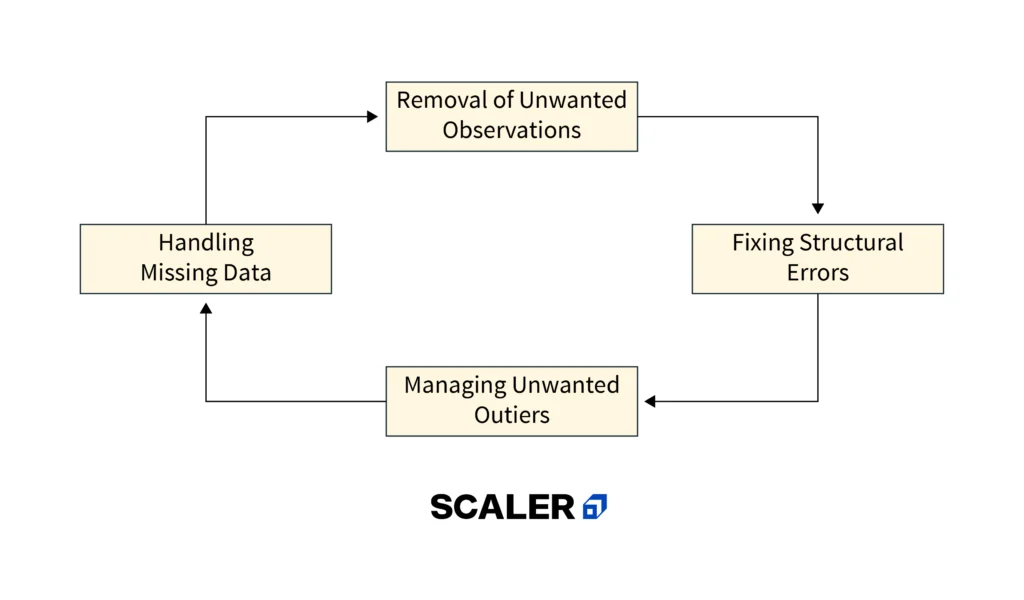
如果您渴望掌握数据清洗的艺术并充分释放机器学习模型的潜力,Scaler 的机器学习课程将深入讲解数据预处理的种种细节,帮助您掌握相关技能和知识,确保您的数据干净无瑕、随时可用于分析。
转变你的职业生涯
从我们行业领先的课程中选择,助你走向职业成功
现代软件与 AI 工程课程
掌握融合 AI 的全栈开发

另有 1000+ 门课程
AI 前沿部署工程师(AI 应用方向)
构建并部署 AI 解决方案,应对真实世界的商业问题
另有 1000+ 门课程
现代数据科学与机器学习(AI 方向)
高级数据科学技术,专注 AI 专业方向
另有 1000+ 门课程
高级 AIML 课程(Agentic AI 方向)
深入学习 AIML,聚焦 Agentic 系统
另有 1000+ 门课程
DevOps、云计算与 AI 平台工程
构建和管理 AI 驱动的云基础设施
另有 1000+ 门课程
IIT-Roorkee AI 工程高级认证
由 IIT-Roorkee 颁发的顶级 AI 工程认证

什么是数据清洗?
数据清洗是识别并纠正数据集中错误、不一致和不准确之处的过程。它涵盖广泛的活动,包括处理异常值、处理缺失值、修正拼写错误、消除重复项以及统一格式。数据清洗的目标是提高数据的质量、可靠性和可用性,以便用于分析和机器学习任务。
尽管数据预处理和数据清洗经常被当作同义词使用,但它们是两个不同却相关的概念:
- 数据清洗: 主要专注于修复或删除错误、损坏或无关的数据点。它解决的是数据录入或收集过程中出现的问题,例如缺失值、重复记录和格式错误。
- 数据预处理: 这个更宽泛的术语既包括数据清洗,也包括为分析做准备的额外转换。它涉及归一化、特征工程、分类变量编码和特征缩放等工作。
从本质上讲,数据清洗是数据预处理的一个子集。数据预处理包括更广泛的方法,用于将数据转换为适合机器学习算法的格式,而数据清洗则侧重于纠正错误并保证数据完整性。
为什么数据清洗很重要?
作为机器学习中默默无闻的英雄,数据清洗对任何使用数据的项目都至关重要,但却经常被忽视。它的重要性在于其对数据质量和机器学习模型性能的深远影响。
对数据质量的影响
数据清洗通过删除无关信息、错误和不一致之处来提高数据集的质量。它确保您的数据准确、可靠,并能真实反映您试图分析的现实世界现象。这反过来又为稳健的分析和建模奠定了坚实的基础。
对模型性能的影响
“垃圾进,垃圾出”这句格言在机器学习中尤为贴切。将脏数据输入模型就像在摇摇欲坠的地基上建造房屋。它会导致结果偏差、预测不准确,并最终导致糟糕的决策。通过细致地清洗数据,您可以消除可能误导算法的噪声和干扰,使其能够学习数据中真正的模式和关系。这意味着更高的准确性、更好的泛化能力,并最终带来更有价值的洞察。
数据清洗在数据科学和机器学习中的重要性
数据清洗不仅仅是一个初步步骤;它是一个贯穿整个数据科学生命周期的持续过程。从数据收集、分析到模型的创建和实施,每个阶段都离不开数据清洗。它确保您的数据处于分析的最佳状态,从而带来更稳健、更可靠的结果。
在机器学习领域,干净的数据是为准确预测和富有洞察力的模型提供动力的燃料。通过在数据清洗上投入时间和精力,您为模型奠定了基础,使其能够很好地泛化到新数据、做出准确预测,并最终为您所在的组织或研究带来更好的决策。
在机器学习中执行数据清洗的步骤
为了保证数据质量和可靠性,数据清洗是一个多方面的过程,需要系统性的方法。让我们来分解其中涉及的关键步骤:
1. 数据检查与探索
首先要彻底了解你的数据集。利用 Python 的 pandas 库中的 df.info() 等工具,快速了解数据类型、缺失值和列名。按类别和数值对列进行排序,然后查看每列中数值的分布情况。统计分类列中的唯一值数量可以发现潜在的不一致或错误。使用直方图或散点图对数据进行可视化,也能为了解数据结构和潜在问题提供有价值的洞察。
2. 删除不需要的观测值
识别并删除与分析无关的列或行。例如,在泰坦尼克号数据集中,“Name”或“Ticket”等列可能对预测生存没有帮助。同样,删除重复行以避免偏差,确保分析的准确性。
3. 处理缺失数据
缺失数据是现实世界数据集中的常见挑战。根据缺失的类型和程度,你有以下几种处理技术可选:
- 删除: 如果缺失值很少且是随机的,可以直接删除相应的行或列。
- 插补: 即用基于其他可用数据估算出的值来替换缺失值。均值、中位数、众数,以及回归或 K 近邻插补等更复杂的方法,都是常见的插补技术。
4. 处理异常值
异常值是明显偏离整体分布的数据点。它们可能扭曲分析结果,导致不可靠的结论。可以使用 z 分数或四分位距(IQR)等统计方法来检测异常值。一旦识别出异常值,你可以根据分析目标选择删除它们,或用更合理的值替换。
5. 数据转换
将数据转换为可用于分析和建模的格式称为数据转换。这可以包括:
- 标准化: 将特征缩放至均值为零、方差为一。
- 归一化: 将特征缩放至 0 到 1 之间。
- 编码: 将分类变量转换为机器学习算法能够理解的数值表示。
6. 数据验证与核查
最后一步是验证清洗后数据的准确性和一致性。这包括查找任何残留的错误或异常值,以及数据类型的不一致和不同数据源之间的不一致。彻底的验证可以确保清洗后的数据集已准备好用于分析和建模。
用 Python 实现数据清洗
Python 拥有 pandas 和 NumPy 等丰富的库生态系统,为数据清洗提供了强大的工具集。让我们通过 Python 代码片段来实际演练数据清洗过程。
示例 CSV 文件:让我们以一个示例 CSV 文件数据来进行代码实现:
"ID","Name","Age","Score","City","Country"
1,"John Doe",25,85,"New York","USA"
2,"Jane Smith",30,90,"Los Angeles","USA"
3,"Bob Johnson",28,78,"Chicago","USA"
4,"Alice Brown",22,92,"Houston","USA"
5,"Mike Davis",35,88,"Philadelphia","USA"
6,"Emily Taylor",29,95,"Phoenix","USA"
7,"Sarah Lee",26,80,"San Antonio","USA"
8,"Kevin White",31,89,"San Diego","USA"
9,"Lisa Hall",27,91,"Dallas","USA"
10,"Tom Harris",33,87,"San Jose","USA"
1. 数据检查与探索
import pandas as pd

# Load your dataset
df = pd.read_csv("your_dataset.csv")

# Display basic information about the dataset
print(df.info())

# Display descriptive statistics for numerical columns
print(df.describe())

# Display the first few rows of the dataset
print(df.head())

# Visualize the distribution of numerical columns
import matplotlib.pyplot as plt
df.hist(bins=30, figsize=(10, 8))
plt.show()
输出:
Kotlin:
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 10 entries, 0 to 9
Data columns (total 6 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   ID      10 non-null     int64
 1   Name    10 non-null     object
 2   Age     10 non-null     int64
 3   Score   10 non-null     int64
 4   City    10 non-null     object
 5   Country 10 non-null     object
dtypes: int64(3), object(3)
memory usage: 608.0+ bytes
Shell:
            ID        Age      Score
count  10.00000  10.000000  10.000000
mean    5.50000  28.600000  87.500000
std     3.02765   3.683748   5.724556
min     1.00000  22.000000  78.000000
25%     3.25000  25.750000  85.250000
50%     5.50000  28.000000  88.500000
75%     7.75000  31.000000  91.000000
max    10.00000  35.000000  95.000000
Mathematica:
    ID    Name         Age    Score   City         Country
0   1     John Doe     25     85      New York     USA
1   2     Jane Smith   30     90      Los Angeles  USA
2   3     Bob Johnson  28     78      Chicago      USA
3   4     Alice Brown  22     92      Houston      USA
4   5     Mike Davis   35     88      Philadelphia USA
2. 删除不需要的观测值
# Drop irrelevant columns (assuming 'ID' is not needed)
df.drop(["ID"], axis=1, inplace=True)

# Remove duplicate rows (if any)
df.drop_duplicates(inplace=True)

# Remove rows based on a condition (example: Age less than 24)
df = df[df['Age'] >= 24]

# Display the cleaned dataframe
print(df.head())
输出:
      Name        Age  Score   City         Country
0     John Doe     25    85    New York     USA
1     Jane Smith   30    90    Los Angeles  USA
2     Bob Johnson  28    78    Chicago      USA
4     Mike Davis   35    88    Philadelphia USA
5     Emily Taylor 29    95    Phoenix      USA
3. 处理缺失数据
# Drop rows with missing values (if appropriate)
df.dropna(inplace=True)

# Impute missing values with mean (for numerical columns)
df["Age"].fillna(df["Age"].mean(), inplace=True)

# Impute missing values with mode (for categorical columns)
df["City"].fillna(df["City"].mode()[0], inplace=True)

# Display the dataframe after handling missing data
print(df.info())
输出:Kotlin
<class 'pandas.core.frame.DataFrame'>
Int64Index: 9 entries, 0 to 9
Data columns (total 5 columns):
#   Column   Non-Null Count  Dtype
---  ------   --------------  -----
0   Name     9 non-null      object
1   Age      9 non-null      int64
2   Score    9 non-null      int64
3   City     9 non-null      object
4   Country  9 non-null      object
dtypes: int64(2), object(3)
memory usage: 432.0+ bytes
4. 处理异常值
import numpy as np
from scipy import stats

# Detect outliers using z-score (for numerical columns)
z_scores = stats.zscore(df["Score"])
abs_z_scores = np.abs(z_scores)
filtered_entries = (abs_z_scores < 3)
df = df[filtered_entries]

# Detect outliers using IQR (Interquartile Range)
Q1 = df['Score'].quantile(0.25)
Q3 = df['Score'].quantile(0.75)
IQR = Q3 - Q1
df = df[~((df['Score'] < (Q1 - 1.5 * IQR)) | (df['Score'] > (Q3 + 1.5 * IQR)))]

# Display the dataframe after handling outliers
print(df.describe())
输出:Shell
 Age   Score
count  9.000000   9.000000
mean  28.555556  88.222222
std    3.709775   5.244044
min   25.000000  78.000000
25%   26.000000  85.000000
50%   29.000000  88.000000
75%   30.000000  91.000000
max   35.000000  95.000000
Scaler 顶级讲师的免费课程
5. 数据转换
from sklearn.preprocessing import StandardScaler, MinMaxScaler

# Standardize numerical columns (zero mean, unit variance)
scaler = StandardScaler()
df[["Age", "Score"]] = scaler.fit_transform(df[["Age", "Score"]])

# Normalize numerical columns (range between 0 and 1)
scaler = MinMaxScaler()
df[["Score"]] = scaler.fit_transform(df[["Score"]])

# Encode categorical columns
df = pd.get_dummies(df, columns=["City"])

# Display the transformed dataframe
print(df.head())
输出:
| 姓名 | 年龄 | 分数 | 国家 | City_Chicago | City_Dallas | City_Houston | City_Los Angeles | City_New York | City_Philadelphia | City_Phoenix | City_San Antonio | City_San Diego | City_San Jose |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| John Doe | -1.014185 | 0.388889 | USA | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 0 |
| Jane Smith | 0.389607 | 0.833333 | USA | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 0 |
| Bob Johnson | -0.149877 | 0 | USA | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| Mike Davis | 1.918889 | 0.666667 | USA | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 0 |
| Emily Taylor | 0.810293 | 1 | USA | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 0 |
请记住:
- 你选择的具体数据清洗步骤和技术将取决于数据集的性质和特征。
- 在应用任何转换之前,务必仔细检查和分析你的数据。
- 数据清洗是一个迭代的过程,你可能需要尝试不同的技术才能获得最佳结果。
加入 Scaler 机器学习课程,拥抱科技革命。掌握在快速发展的机器学习领域中脱颖而出所需的技能。
数据清洗工具
为了构建准确可靠的机器学习模型,拥有合适的数据清洗工具至关重要。为了帮助你选择最符合需求的数据清洗工具,让我们来看几款广泛使用的工具,它们各有优缺点。
1. OpenRefine
OpenRefine(前身为 Google Refine)是一款处理杂乱数据的高效开源工具。它允许你对各种格式的数据进行探索、清洗、转换和核对。
- 优点: 免费、功能多样、可处理大型数据集、支持多种数据格式、提供强大的过滤和转换功能。
- 缺点: 学习曲线较陡;它主要是一款桌面程序,需要一定的技术知识。
2. Trifacta Wrangler
Trifacta Wrangler 是一个可视化数据整理平台,可简化数据的清洗和准备工作。它提供交互式界面,你可以使用各种可视化工具和转换来探索、转换和丰富数据。
- 优点: 直观的可视化界面、易于学习和使用、强大的数据分析和转换功能、支持多种数据源。
- 缺点: 企业使用成本可能较高,处理超大数据集的能力有限,高级功能可能需要额外培训。
3. DataCleaner
DataCleaner 是一款用于数据准备和数据增强的开源程序,面向技术用户和非技术用户。它提供了一系列数据剖析、清洗、验证和丰富功能。
- 优点: 免费、界面友好、自动化的数据剖析和清洗建议、支持多种数据源,并提供可视化工作流设计器。
- 缺点: 特定任务可能需要额外插件,处理超大数据集的能力有限,与商业工具相比社区支持可能不够全面。
4. WinPure Clean & Match
WinPure Clean & Match 提供了一整套数据质量软件工具,包括数据清洗、去重和匹配。它旨在帮助企业提高数据的准确性、完整性和一致性。
- 优点: 界面友好、强大的数据清洗和去重能力、用于识别相似记录的模糊匹配、可自定义的工作流。
- 缺点: 成本可能较高,主要针对客户数据,可能并不适用于所有类型的数据清洗任务。
5. Drake
Drake 是一款 Python 数据工作流工具,可用于创建复杂的数据处理管道。虽然它并非严格意义上的数据清洗工具,但可以在更广泛的工作流中用来自动化数据清洗任务。
- 优点: 基于 Python、灵活且可定制、非常适合自动化重复性的数据清洗任务、与其他 Python 数据科学工具集成良好。
- 缺点: 需要编程知识,对非技术用户来说可能较为复杂,对 Python 新手来说学习曲线可能较陡。
这些只是众多数据清洗工具中的几个例子。选择哪种工具取决于你的需求、预算和技术水平。不妨试用不同的工具,找到最符合你的工作流程、助你成功完成数据清洗的那一款。
Scaler 就业报告与统计数据
Scaler 学员实现了 2.5 倍的薪资增长,从 Scaler 毕业后的平均 CTC 达到 ₹23L。
机器学习中数据清洗的优缺点
在机器学习领域,数据清洗既有优点也有缺点。它带来了巨大的好处,但也带来了一定的挑战。理解这些权衡对于在项目中就如何进行数据清洗做出明智决策至关重要。
优点
- 提升数据质量: 数据清洗最明显的好处就是数据质量的提升。通过消除错误、不一致和多余的信息,你可以得到一个更准确、更可靠、更能真实反映你所研究现象的数据集。
- 提升模型性能: 干净的数据能带来更好的机器学习模型。当你的模型基于高质量数据进行训练时,它更有可能学习到数据中真实的模式和关系,从而做出更准确的预测和更好的决策。
- 更深入的洞察: 干净的数据让你能够挖掘更深入的洞察,发现可能被噪声和错误掩盖的隐藏模式。这可以带来新的发现、对数据更好的理解,并最终获得更好的结果。
- 更高效的分析: 通过删除无关和冗余的信息,数据清洗简化了你的数据集,使其更易于分析和可视化。这样,你就可以腾出宝贵的时间和资源,专注于获取有价值的见解。
缺点
- 耗时: 数据清洗可能是一个耗时的过程,尤其是在处理大型复杂数据集时。它通常需要人工进行数据验证、修正和检查,这可能既耗时又困难。
- 需要专业知识: 有效的数据清洗需要领域知识和专业经验。要识别潜在的错误和不一致、理解数据的细微差别并选择合适的清洗技术,必须对相关主题和数据分析原理有透彻的理解。
- 可能引入偏差: 如果操作不谨慎,数据清洗可能会给你的数据集引入偏差。删除异常值或基于假设对缺失值进行插补,可能会轻微改变数据的底层分布,从而导致结果出现偏差。
- 并非万能方案: 清洗数据没有唯一的“最佳”方法。最佳策略取决于你数据集的独特属性、你的分析目标以及你可用的资源。
要全面了解数据清洗技术和最佳实践,可以考虑报名参加 Scaler 的机器学习课程。该课程由专家授课,包含实战项目和一对一辅导,将帮助你掌握成为数据清洗方面的机器学习专家所需的知识和技能。
Scaler 校友及其成功故事
结论
数据清洗常常被忽视,但它是成功构建机器学习模型的基石。数据清洗通过仔细处理错误、不一致和异常值,确保数据的质量和可靠性。这直接影响模型的准确性以及从数据中得出的洞察的有效性。从数据检查和预处理,到处理缺失值和异常值,数据清洗过程中的每一步对于释放数据的真正潜力都至关重要。
只要投入时间和精力清洗数据,您的机器学习项目就会取得成功。干净的数据能带来更好的模型、更准确的预测,并最终实现更明智的决策。
常见问题
清洗数据是什么意思?
查找并修复数据集中的错误、不一致和不准确之处的流程称为数据清洗,有时也称为数据清理。这包括处理缺失值、纠正拼写错误、删除重复项以及标准化格式等任务,以提高数据质量。
清洗数据的一个例子是什么?
数据清洗的一个例子是纠正数据集中不一致的日期格式。如果有些日期的格式是"dd/mm/yyyy",而另一些是"mm/dd/yyyy",您就需要将它们统一为单一格式,以确保一致性和准确性。
数据清洗(data wash)是什么意思?
数据清洗(data wash)并不是数据科学或机器学习领域的标准术语。它可能是对数据清洗或预处理的一种口语化描述,但在该领域并不常用。
数据清洗是如何进行的?
数据清洗包括多个步骤,例如数据检查与探索、删除不需要的观测值、处理缺失数据和异常值、数据转换以及数据验证。这些工作可以手动完成,也可以借助自动化工具和脚本来完成。
网络安全中的数据清洗是什么?
在网络安全领域,数据清洗的重点是删除或净化敏感数据,以防止其被未经授权地访问或泄露。这可能涉及数据脱敏、令牌化或加密等技术。
如何使用 SQL 清洗数据?
SQL(结构化查询语言)提供了多种用于数据清洗的函数和命令,例如用于去除首尾空格的 TRIM、用于替换特定字符的 REPLACE,以及用于处理不一致情况的 CASE 语句。您还可以使用 SQL 查询来过滤不需要的数据、纠正错误,并通过聚合数据来识别异常值。