上下文工程师 vs 提示词工程师:技能转型(2026年5月)
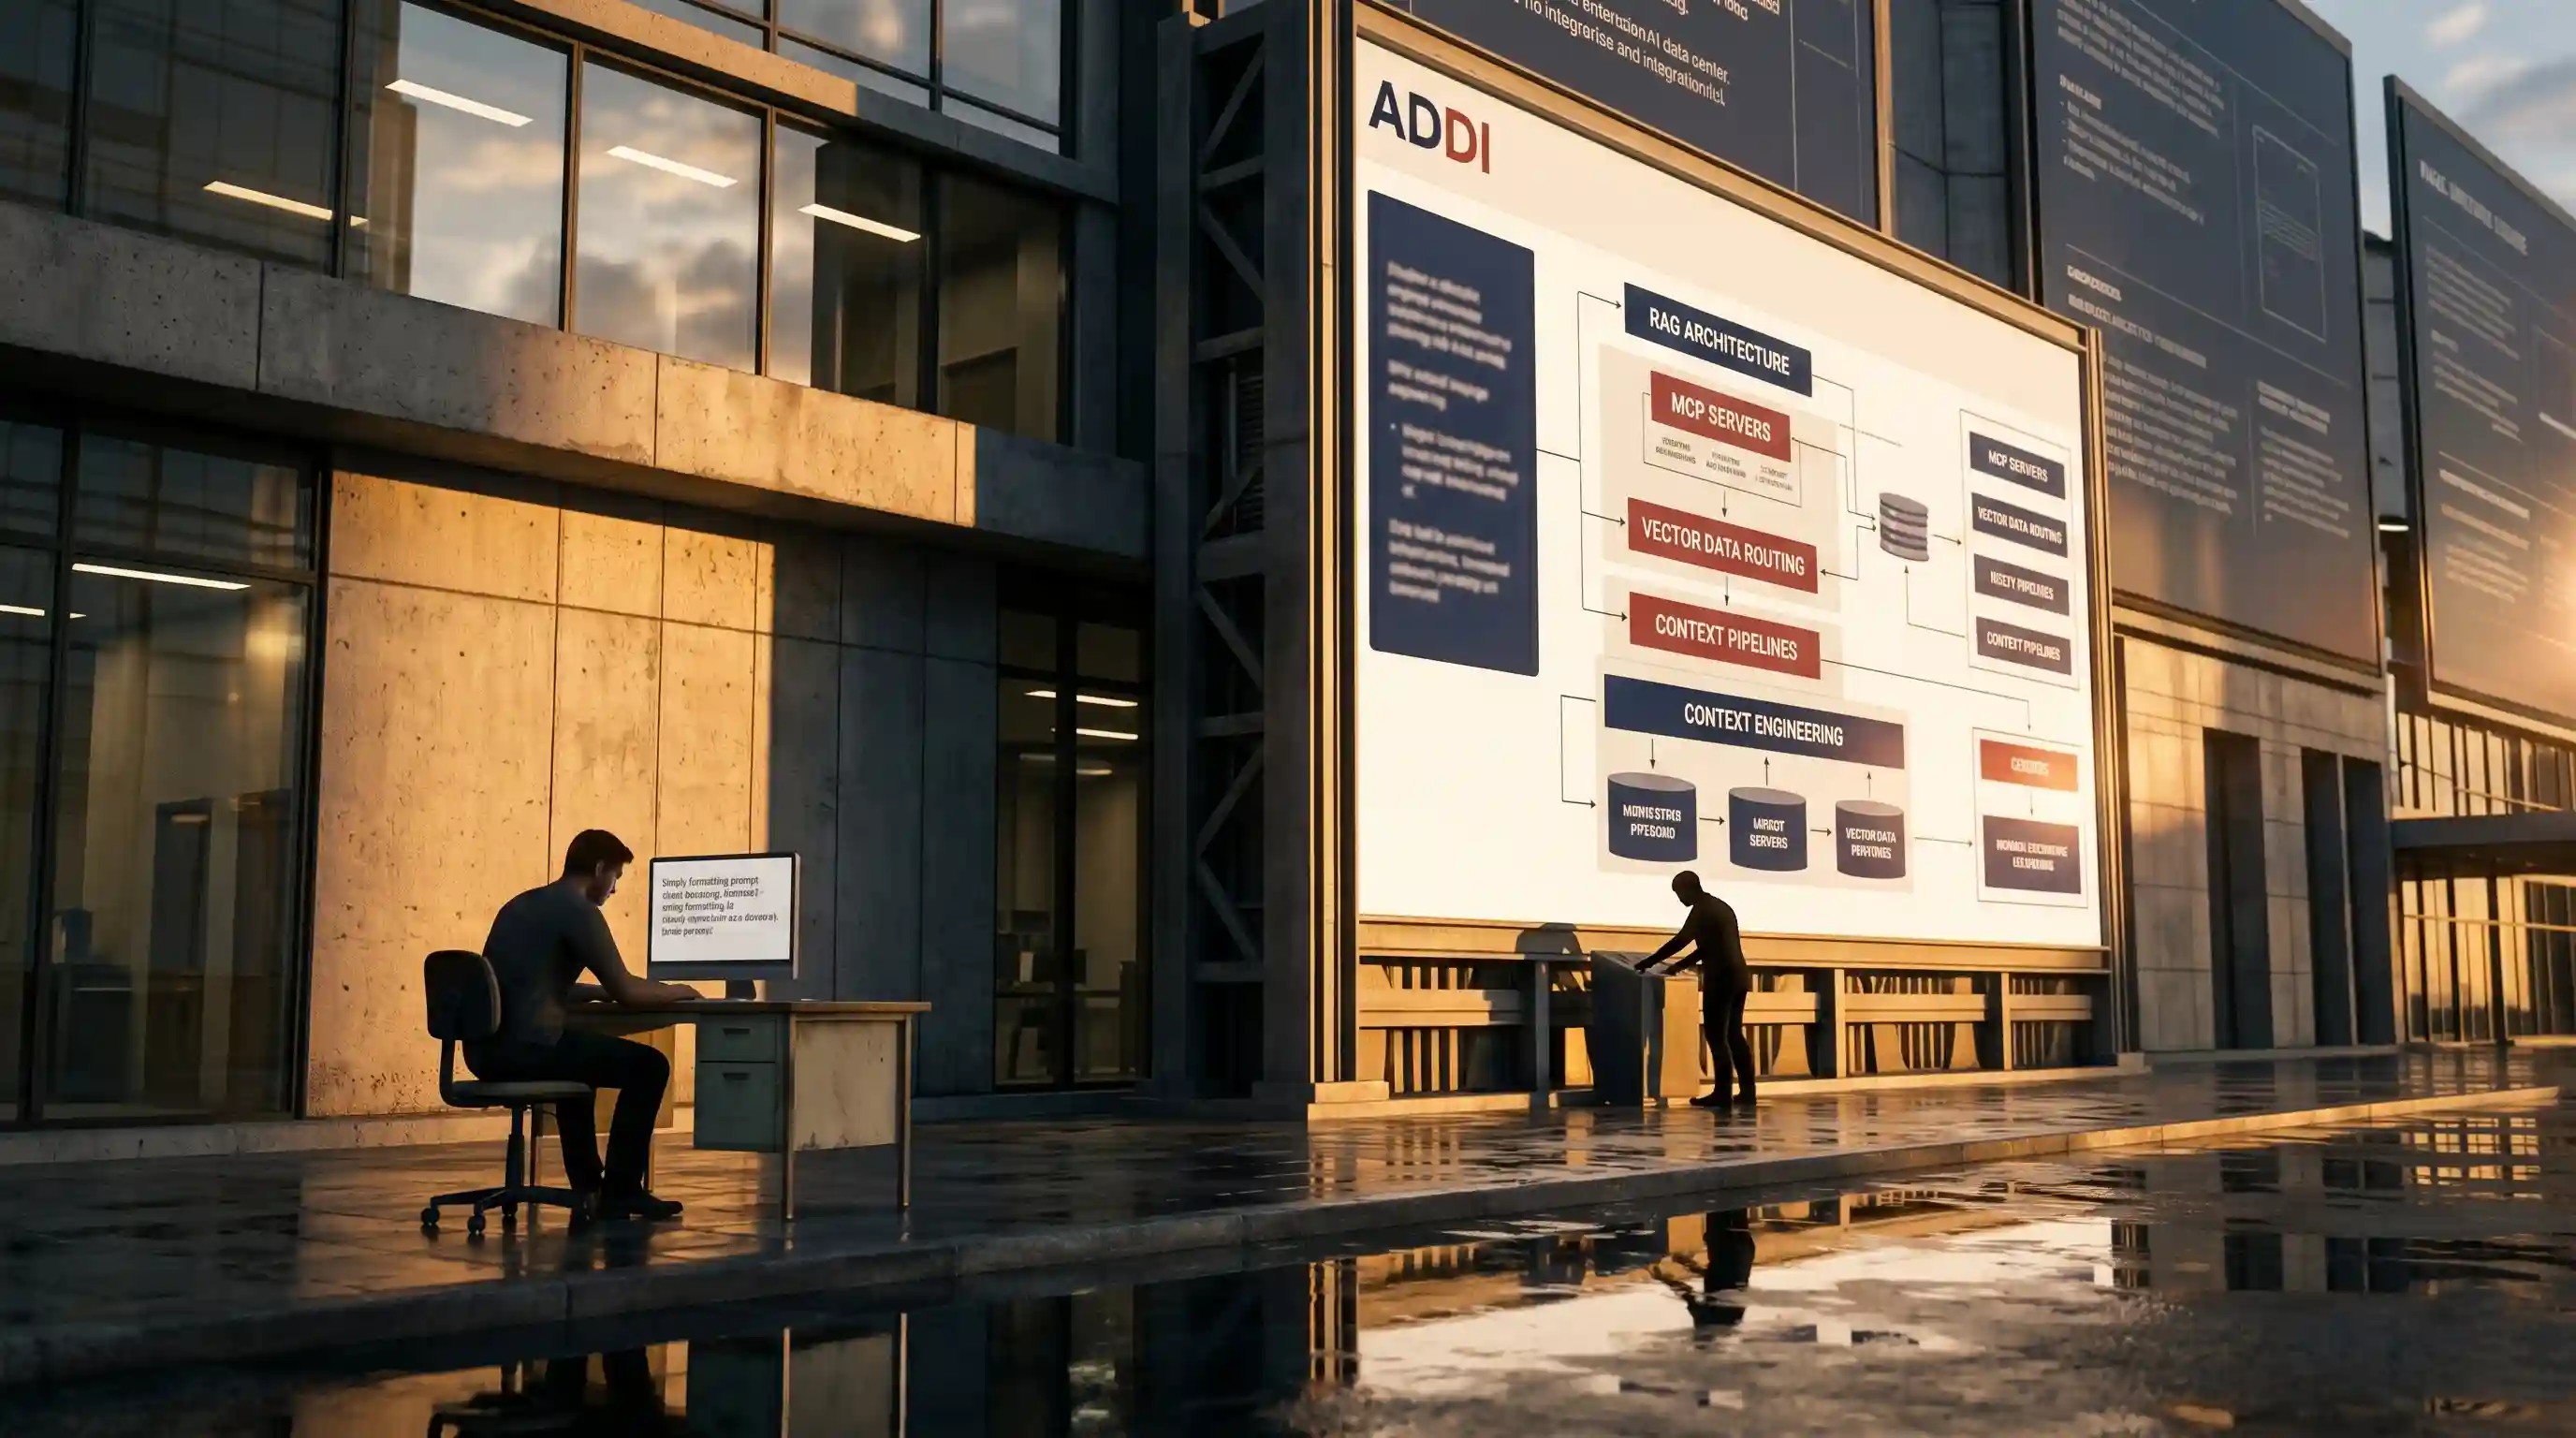
- 提示词的失败: 仅靠提示词工程无法解决企业级需求,因为模型缺乏实时数据支撑和状态协调能力。
- 新标准: 上下文工程建立了一个稳健的、以基础设施为驱动的层级,利用高级检索、内存管理和安全数据路由。
- 薪资溢价: 转型为上下文工程岗位可获得中位数 21 万美元的溢价薪酬区间,远超传统的提示词编写岗位。
- 核心工具集成: 技术栈完全依赖检索增强生成(RAG)指标、向量数据库和模型上下文协议(MCP)服务器。
根据 DataHub 的《2026年上下文管理现状报告》,高达 82% 的数据负责人明确表示,仅靠提示词工程不足以支撑企业级应用。
仅仅通过调整自然语言文本来引导模型行为的时代已达到其商业天花板。随着基础模型日趋同质化,工程领域的终极差异化因素已从“你向模型提出什么”转变为“你如何为其构建数据环境”。
这一核心演变催生了一门高度技术化的软件学科:上下文工程。理解这一转变对于任何在现代执行层附近工作的人都至关重要,包括快速发展的前沿部署 AI 工程师赛道。
提示词工程师将模型边界视为语言学问题,而上下文工程师则将其视为基础设施问题。本指南规划了明确的 12 周技能转型路径,揭示新的薪资区间,并提供在 2026 年获得企业级岗位所需的架构路线图。
架构分歧:语言精炼 vs 基础设施构建
提示词工程的机制剖析
提示词工程将大语言模型视为可以通过字符串操作来引导的黑盒系统。
这项工作依赖于零样本模式、少样本示例以及编码在系统消息中的语言防护机制。虽然这种模式适用于基础原型开发和独立的消费级工具,但在企业系统中却会失效。
仅依赖提示词格式化会使企业系统极易受到上下文窗口漂移、提示词注入和幻觉的影响。
上下文工程的技术层
上下文工程将模型编排视为一项高级的数据路由和系统集成挑战。
上下文工程师不再编写冗长的文本,而是设计自动化数据管道,对模型执行特定任务所需的精确数据片段进行检索、过滤、压缩和排序。
重点从如何表述查询,转向如何构建本地状态、在多轮工作流中管理内存参数以及优化向量数据库。
这一运营层将非确定性模型转变为可预测的企业级基础设施。
工具与方法论:2026 年核心执行技术栈
检索增强生成(RAG)优化
上下文工程师将大部分时间用于构建和验证高级 RAG 应用。
他们不依赖简单的开箱即用方案,而是专注于复杂的分块策略、父子文档关系以及稀疏-稠密混合搜索。
性能通过明确的指标进行数学化评估,而非定性审查。
你必须学会使用精确的评分模式(如 recall@k、平均倒数排名(MRR)和命中率分析)来优化检索管道,以验证系统效率。
模型上下文协议(MCP)实现
2026 年的一项基础性标准是模型上下文协议(MCP)。上下文工程师构建、部署并保护专用 MCP 服务器,使其充当 LLM 与公司安全内部资源之间的标准化翻译层。
这种结构化架构确保基础模型能够安全地查询实时数据库、检查内部代码仓库并访问受保护的企业 API,同时不损害企业合规参数或数据安全规则。
21 万美元的现实:薪酬区间与招聘趋势
从纯提示词调整的经济性转变已从根本上改变了招聘经济学。
由于上下文工程师必须具备核心软件工程技能,其薪资水平体现了直接的技术溢价。
当传统的提示词工程岗位面临严重的薪资压缩和市场萎缩时,上下文工程师在全行业中获得了高达 21 万美元中位数总薪酬的丰厚基准。
在顶级基础模型实验室和高增长企业中,资深上下文工程专业人士的薪酬包足以与核心平台岗位相媲美。
这一差距完全源于企业在产品发布前尽量降低上下文窗口延迟并消除幻觉成本的强烈业务需求。
要了解相邻学科如何匹配这一溢价估值轨迹,请查阅现代产品管理能力的完整概览。
12 周转型框架规划
转入这一高薪领域需要系统性地从自然语言提示词编写过渡到系统软件开发。
第 1–4 周:高级数据基础
首先掌握高级结构化和非结构化数据检索。学习构建生产级 SQL 查询,并深入使用核心企业数据库本体。
接着学习向量索引拓扑,理解 HNSW 与 IVF 算法在 Pgvector、Pinecone 或 Milvus 等向量数据库中的机制差异。
第 5–8 周:编排框架与评测工具
超越基础的应用打包,学习如何构建复杂的智能体编排模式。
掌握上下文窗口优化技术、元数据过滤和语义缓存层。
最重要的是,学习使用 DeepEval 或 LangSmith 等平台构建自动化评测框架,以编程方式对检索准确性进行评分。
第 9–12 周:MCP 服务器开发与作品集架构
用最后一个月来构建和部署功能完备的自定义 MCP 服务器。
构建一个开源 GitHub 仓库,展示一个与实时公共数据源对接的实时上下文管理应用。
确保你的仓库包含一个评测工具,证明高检索率,向技术招聘人员展示真正的企业级就绪能力。
如需更全面地了解这些特定数据能力如何与全球范围内历史开发者发展轨迹相契合,请查看旧版网站上的权威 AI 工程师路线图。
常见问题(FAQ)
提示词工程师优化自然语言指令以引导模型输出。上下文工程师则构建自动化软件系统、流水线和服务器协议,以高效地检索、保护并注入模型所需的确切数据。
是的,作为一个独立的技术岗位,提示词工程已经完全商品化。仅依赖基础的语言调整已无法满足企业需求,价值已完全转向上下文架构和系统工程。
你必须将技术技能栈扩展到生产级软件开发。优先学习后端编程、高级数据查询、向量数据库优化、自动化验证框架,以及模型上下文协议等开源实现标准。
提示词工程薪资面临严重的市场压缩。相比之下,上下文工程师拥有高达 21 万美元的中位数总薪酬区间,在高级平台工程层级还会通过股权分配显著提升。
是的。现代企业团队正在积极淘汰以提示词为中心的头衔,取而代之的是能够编写生产级代码、构建健壮接口并按合规参数管理企业安全的上下文工程师。
专注于掌握向量数据库、Elastic 等企业搜索系统、LangSmith 等框架评测器以及元数据层。此外,还要全面熟练地设计和维护自定义模型上下文协议(MCP)服务器。
检索增强生成(RAG)和模型上下文协议(MCP)是上下文工程师采用的主要方法论。他们使用 RAG 系统性地提取相关文档,并使用 MCP 服务器在内部数据与 API 之间建立安全的转换通道。
不会,因为上下文工程关注的是企业数据系统的物理集成,而非局部的模型逻辑。虽然模型能力会持续扩展,但安全地连接专有的、受保护的信息生态系统仍将是一项必要的工程工作。
大规模招聘主要由大型基础模型实验室、高速增长的初创公司以及 Scale AI 和 Databricks 等专业科技平台推动。大型企业和全球能力中心也在大量招聘,以保障其生产数据落地。
两者是深度结合的。它既要求以数据最小化、降低延迟和精准验证为核心的清晰系统架构方法论,也需要借助先进的编程与数据工具基础设施进行专家级的实现。