你可以在普通 CPU 上用大约两分钟从原始文本训练一个小型语言模型。我们运行了开源的 train-llm-from-scratch 仓库,记录了各项数据,并解释每个阶段(分词器、预训练、SFT、奖励模型、DPO、PPO、GRPO)、各种坑,以及为什么每位 FDE 都应该亲手做一次。
作者:HANNAH BRYANT · FDEINTERVIEWS 编辑部 · 更新于 2026 年 10 月 7 日 · 阅读时间 6 分钟
动手练习:LLM 与 GenAI 问题 · 微调 vs RAG vs 提示词,概念解析 · PPO 与 GRPO,概念解析 · FDE 必知问题
是的,你可以在普通电脑上从零训练一个语言模型:2026 年 10 月 7 日,我们在一颗 8 核桌面 CPU 上,使用开源的 train-llm-from-scratch 仓库,用 111 秒训练了一个 369,024 参数的模型,从原始文本到生成故事。 它达到了 2.78 的验证损失,并写出类似“从前,有一个叫 Sue 的小女孩。Sue 喜欢到处张望。”这样的句子。这个规模适合学习,不适合实际使用:重点在于看清模型构建的每一个阶段,而且代码是可读的纯 PyTorch。该仓库(MIT 许可,截至 2026 年 10 月 7 日约 12,000 个 GitHub stars,作者为 Fareed Khan)现在远不止预训练,还包含监督微调、奖励模型、DPO、PPO 和 GRPO。本文介绍我们运行的内容、每个阶段能学到什么、各种坑,以及为什么前沿部署工程师应该亲手做一次。
仓库包含什么
它手工实现了一个 Transformer,基于《Attention Is All You Need》,然后在其上构建了完整的训练流水线,不使用
trl
,
peft
或
transformers
库。每个算法都是一个可以打开的简短 PyTorch 文件。作者的定位很到位:把文本变成数字,预测下一个 token,然后不断调整数据和损失函数,直到模型做出你想要的行为。
有两种模型架构。经典的是 2017 年设计的 GPT-2 形式,最适合学习。现代版本换上了较新开源模型使用的组件:旋转位置编码(RoPE)、RMSNorm、SwiGLU 前馈层、分组查询注意力、用于生成的 KV cache,以及可选的混合专家。任何脚本都可以接受
--arch modern
。一个值得在你自己的代码中借鉴的设计选择是作者所说的“包装,而非重写”:基础 Transformer 增加一个方法,返回输出层之前的隐藏状态,而奖励头、价值头和对数概率计算都围绕它组合而成。
我们运行了什么,以及数据
我们按照笔记本路线,在 commit
bdd480a
处运行,强制仅使用 CPU(不使用 GPU),硬件为 AMD Ryzen 7 9700X,8 核 16
threads.
| 步骤 | 发生了什么 | 我们的测量结果 |
|---|---|---|
| 准备数据 | 下载 TinyStories,从零训练一个 4,096 词元的 BPE 分词器并进行编码 | 7.6 秒;6,095,088 个训练词元,991,095 个验证词元;每个词元 4.02 个字符 |
| 训练,现代架构 | --preset tiny --arch modern | 369,024 个参数;111 秒;开发损失 2.78;每秒约 65,000 个词元 |
| 训练,经典架构 | --preset tiny --arch classic | 636,288 个参数;116 秒;开发损失 3.38 |
有三点值得注意。首先,现代架构的参数少了 42%,却仍达到了更低的损失(2.78 对 3.38)。README 报告的是 2.78 对 3.30,所以现代架构的数字与我们的完全一致,而经典架构在我们这次运行中结果略差。其次,两次运行的初始损失都在 8.2 到 8.4 之间,接近 ln(4,096) = 8.32,即均匀猜测每个词元的模型的损失。这是机器学习中最有用的合理性检查:如果你的初始损失与 ln(词表大小) 相差甚远,那么在训练开始之前就已经出了问题。第三,大部分学习发生在早期。现代模型的开发损失在前 150 步内减半,其余的训练时间都在艰难地磨掉最后那 1.3。
输出的读感像是一个只学会了儿童故事统计规律、此外一无所知的模型。我们的模型写出了 "Sue saw a big, red ball and asked",有语法、反复出现的角色和模糊的情节。它是一个玩具故事讲述者,而不是通用助手。
每个阶段教会我们什么
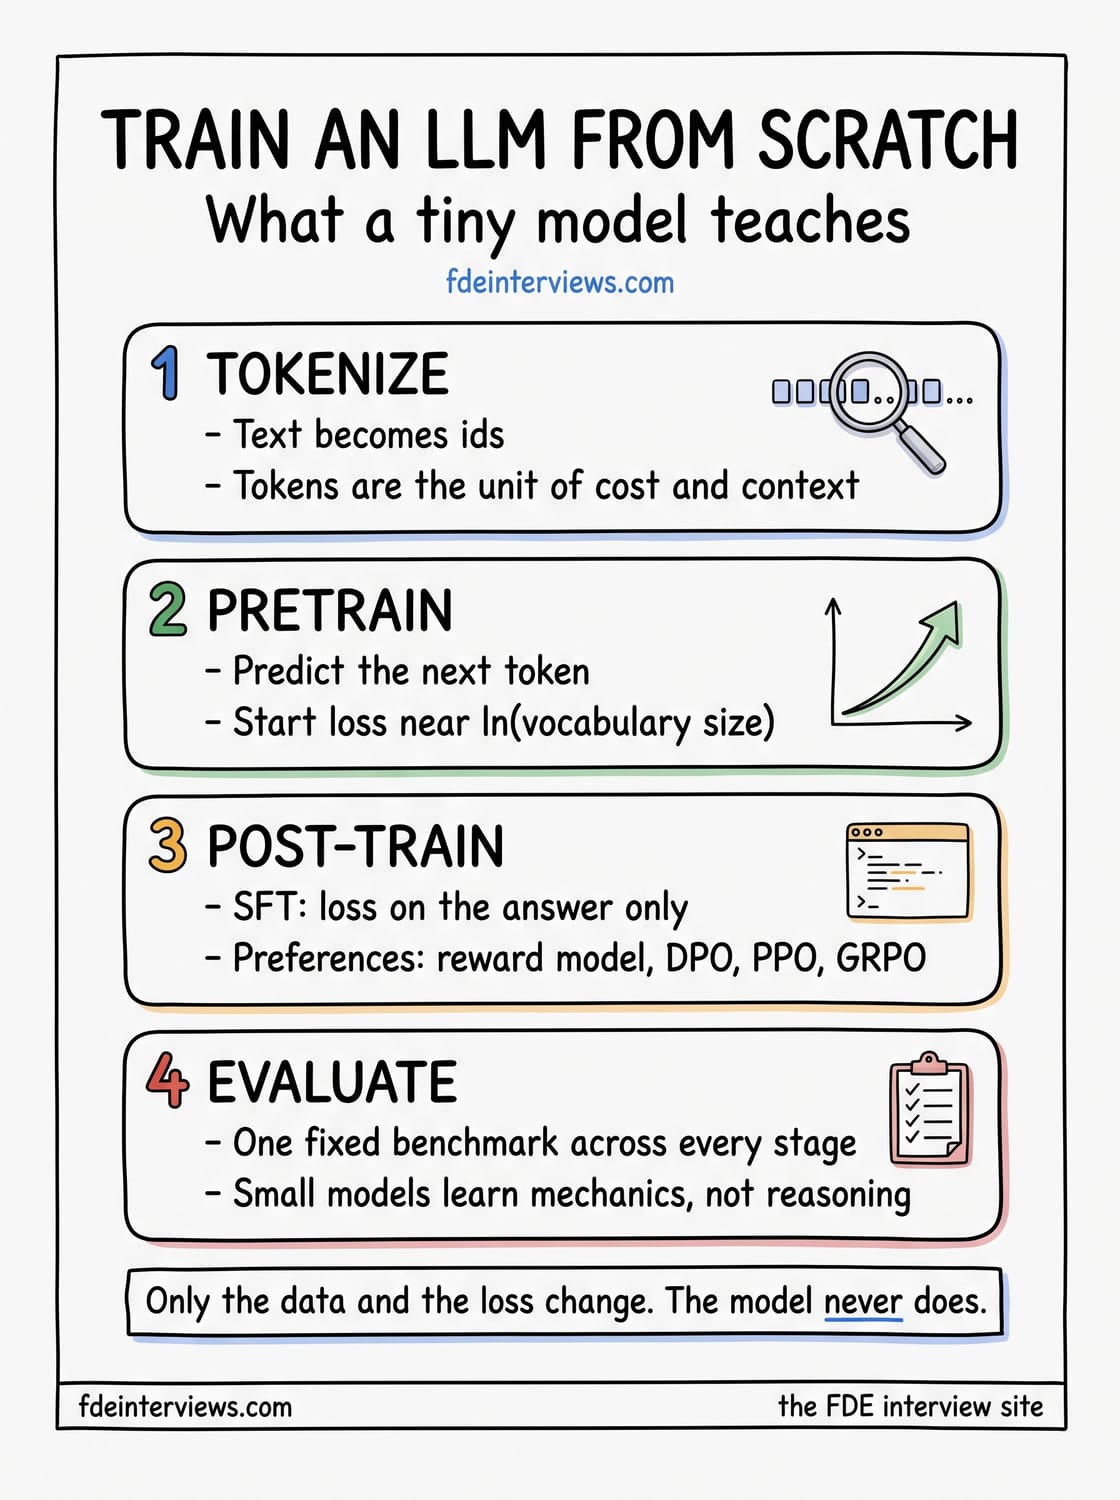
分词。 训练自己的 4,096 词元 BPE 分词器说明了为什么词元而非单词才是成本和上下文的单位。较小的词表能让 嵌入 表保持较小,这正是 tiny 模型速度快的原因。更大的预设切换到 50,304 词元的 GPT-2 风格分词器,其均匀猜测损失为 10.83。README 中在两块 L40 GPU 上运行的 7,700 万参数模型从 11.14 开始,经过 2,000 步后达到约 3.73 训练损失和 3.76 开发损失。
监督微调与损失掩码。 SFT 仍然是 下一词元预测,只是有一个改动:损失只统计助手的词元。代码库在词元 id 之外还构建了一个 0 或 1 的掩码,因此模型学会的是撰写回答而不是复述提示。SFT 之后,模型会在它训练时所用的
<think>
和
<answer>
结构内进行回答,而这正是后续阶段所优化的形状。
奖励模型。 在 SFT 骨干网络上加一个标量头,用 Bradley-Terry 损失训练,使被选中的回答得分高于被拒绝的回答。在 7,974 个真实偏好对上,作者运行中达到了 0.574 的留出偏好准确率,高于 0.5 的随机线,但远未达到实用水平。这一微小的优势就是小型奖励模型的真实写照,也是 奖励模型 成为 RLHF 质量成败关键的原因。
DPO、PPO 和 GRPO。 DPO 跳过奖励模型,直接从偏好对中学习,并与冻结的参考副本进行对比。PPO 是经典的 RLHF 循环,带有价值网络和裁剪更新。GRPO 是由 DeepSeek-R1 推广的方法,它移除了价值网络:为每个提示采样一组答案,并根据其所在组对每个答案进行评分。其核心在仓库中只需五行代码即可实现:
def group_advantages(rewards, group_size, eps=1e-4):
    r = rewards.view(-1, group_size)
    mean = r.mean(dim=1, keepdim=True)
    std = r.std(dim=1, keepdim=True)
    adv = (r - mean) / (std + eps)     # how much better than the rest of my group
    return adv.reshape(-1)
该仓库还实现了 2025 年对 GRPO 的修正(Dr. GRPO、DAPO、GSPO),作为同一训练器上的标志。它先运行一个简短的算术课程,因为小模型在完整的 GSM8K 数学问题上奖励为零,因此学不到任何东西。
我们踩过的坑,以及可以预期的坑
- 按照文档说明的方式安装。 我们在现有的 PyTorch 环境中运行脚本,而不是使用 pip install -e .,结果一个接一个地遇到缺失的导入(先是 tiktoken,然后是 jaxtyping)。可编辑安装会声明这些依赖;请使用它,或使用 uv sync。
- 有两套配置系统。 config/config.py 驱动原始的预训练脚本,而 configs/ 下的 JSON 文件驱动其他所有内容。改错文件不会产生任何变化,也不会报错。
- GPU 表格只是一个粗略指南。 README 列出了每款 GPU 可以训练什么(免费的 T4 可以处理 1300 万参数的模型,8 GB 显卡的上限约为 10 亿参数,20 亿参数的配置需要 24 GB 或更多)。像 --amp、--grad-checkpointing 和 --grad-accum 这样的显存节省选项是可选的,默认不开启。
- 小模型不会推理。 该流水线可以端到端运行 GRPO,但几百万参数的基座模型在 GSM8K 上的得分接近零。这些阶段是为了学习其机制,README 中说明得分会随着基座模型规模和预训练算力的增加而提升。
- 注意大规模路径的数据许可。 预训练路径使用 The Pile 的无版权子集。如果你换成客户的数据或抓取的语料库,许可问题就由你自己承担了。
FDE 视角:如果你是部署模型而非训练模型,为什么要做这件事
前沿部署工程师很少进行预训练。但客户确实会问——通常在第一次会议上——他们是否应该训练自己的模型。答案几乎从来不是从零开始,尝试的顺序是提示工程,然后是检索,然后是对开源模型进行微调,正如微调 vs RAG vs 提示工程概念中所阐述的那样。训练过玩具模型的工程师能够以权威的口吻而非照着幻灯片念来回答,并能解释原因:成本随 token 和参数数量扩展,而客户的数据通常不具备基座模型所需的规模。
动手实践在调试时也会带来回报。当客户的微调模型“忘了怎么遵循指令”时,你会先想到损失掩码和聊天模板,而不是归咎于模型。当奖励模型在纸面上看起来没问题、而 RL 训练却出现退化时,你会记得 0.574 的偏好准确率是什么感觉。当账单按 token 计费时,你已经亲眼见过 2400 万个字符在自己机器上变成 600 万个 token。
它还直接覆盖了一组面试题。训练应该从什么损失值开始,为什么?SFT 期间为什么要对提示词做掩码?GRPO 从 PPO 中去掉了什么,DPO 又从两者中去掉了什么?KV 缓存如何改变生成成本?Transformer 架构和 PPO 与 GRPO的概念讲解更深入,LLM 与 GenAI题库则提供了可供练习的题目。如果你有一个下午的时间,先跑一遍笔记本版流程;它比把这篇文章读两遍花的时间还少。
把它转化为 offer。练习与之对应的真实面试题和概念:
常见问题
是的,一个小模型。使用 train-llm-from-scratch 仓库的 tiny 预设,我们仅用一颗 8 核桌面 CPU,在 111 秒内基于 TinyStories 训练了一个 369,024 参数的模型,达到 2.78 的验证损失,并且它能写出简单、基本符合语法的儿童故事。这教会你完整的流程。它产出的模型并不能用于任何实际用途;有用的助手需要数十亿参数和多得多的算力。
这是 Fareed Khan 开发的一个 MIT 许可的教育性仓库(截至 2026 年 10 月 7 日约有 12,000 个 GitHub star),用纯 PyTorch 从零实现 Transformer,然后进行预训练和后训练:监督微调、Bradley-Terry 奖励模型、DPO、ORPO 和 KTO、PPO 以及 GRPO,不使用 trl、peft 或 transformers 库。它包含一个经典的 GPT-2 风格模型,以及一个采用 RoPE、RMSNorm、SwiGLU 和分组查询注意力的现代变体。
约为词表大小的 ln 值,因为未训练的模型对每个 token 的猜测大致是均匀分布的。对于 4,096 个 token 的词表,这个值是 8.32,我们的小型训练起始损失为 8.21。对于 50,304 个 token 的 GPT-2 风格分词器,这个值是 10.83,仓库的 77M 参数训练起始损失为 11.14。如果初始损失远离 ln(V),通常意味着数据、目标或模型输出层存在 bug。
几乎从不。预训练一个有竞争力的模型需要数百万美元,而且需要大多数公司并不拥有的数据。对客户而言,尝试的顺序是:先提示工程,然后检索(RAG),再微调现有的开源模型,只有在这之后才考虑更重的方案。训练一个玩具模型的价值在于理解模型的行为,而不是作为产品策略。
PPO 是经典的 RLHF 流程:生成答案,用奖励模型打分,然后通过带裁剪目标和价值网络来更新策略。DPO 跳过奖励模型和强化学习循环,直接从偏好数据对中学习,并与冻结的参考模型进行对比。GRPO 则去掉了价值网络:它为每个提示采样一组答案,用可验证的奖励打分,并将每个答案的得分相对于其所在组的均值作为优势值。
讨论 (5)
第零步的损失检查是我教给每位新工程师的第一课。如果你的微调一开始的损失值与预期相差甚远,先停下来检查数据,别浪费一整天的 GPU 时间。有一次它帮我在不到一分钟内发现了一个标签错位的 bug。
同样的习惯,损失掩码是第二项检查。如果 SFT 损失把提示词的 token 也算进去,模型就会学会重复问题。打印一条编码后的样本并把掩码对齐显示在下方,是整个流程中最省钱的调试步骤。
读者提问:我不是机器学习工程师。如果我的工作是为客户部署 AI Agent,这值得花一个周末去学吗?
值得,至少笔记本那条路线值得。当你亲眼看过损失曲线趋于平缓,也见过一个 369K 参数的小模型凭空编出一个叫 Sue 的角色之后,你就不会再把模型当成魔法了。当客户问为什么他们的微调忘了怎么遵循指令,或者为什么账单按 token 计费时,这种理解就会体现出来。
值得补充的是:他们实验中的奖励模型偏好准确率只有 0.574,而随机猜测是 0.5。这么小的差距就是小模型在 8,000 对数据上的真实水平,这也说明了为什么在弱奖励模型之上做强化学习,学到的多半只是奖励模型的怪癖。