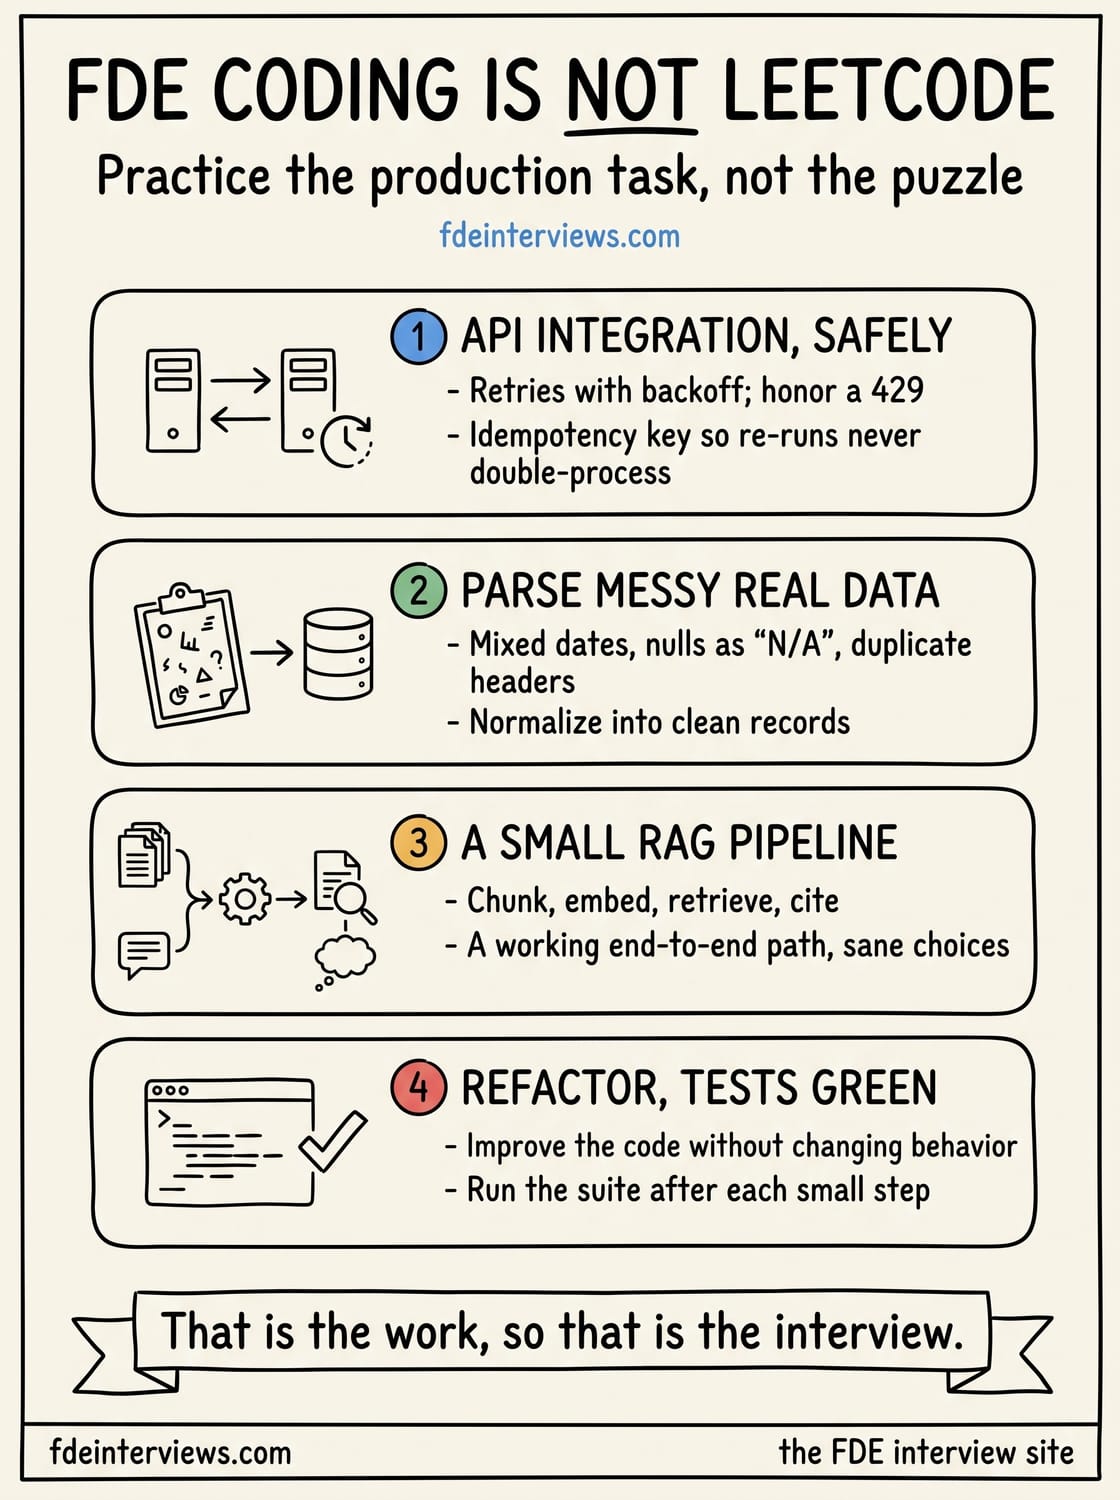
FDE 编程环节不考算法谜题,而是考察生产级工作:带重试和幂等性的 API 集成、解析杂乱的真实数据、搭建小型 RAG pipeline,以及在测试保持通过的前提下重构“能用但很乱”的代码。以下是需要重点练习的内容。
作者:MEI LIN · FDEINTERVIEWS 编辑部 · 更新于 2026 年 6 月 21 日 · 阅读时间 10 分钟
练习这些:编程与 DSA 题目 · 必知的 FDE 题目 · 该岗位真正考察的技能 · RAG 与 Agent 设计题
FDE 编程面试考察的是你能否针对混乱的现实交付正确、生产级的代码,而不是你能否解出算法谜题。决定面试成败的环节看起来就像真实工作:集成一个不稳定的第三方 API,加入重试、退避和幂等性,确保重复运行是安全的;解析不一致且充满边界情况的真实数据;端到端搭建一个小型 RAG pipeline;以及在保持测试通过的同时重构“能用但纠缠不清”的代码。有些初筛仍会包含一道简单的算法题,所以也要保留一点这方面的练习。但如果你把所有准备时间都花在刷 LeetCode 上,那你就是在为错误的考试做准备。以下才是应该练习的内容,以及面试官真正关注的信号。
为什么形式不同
前沿部署工程师编写的代码运行在客户环境中,对接的是没有任何人完整记录过的系统。数据是脏的,上游服务不可靠,一次重复运行导致记录被重复处理就是真实的生产事故,而不是单元测试失败。因此编程环节筛选的是能在这种环境中生存的技能:处理异常路径、防御性解析、幂等性,以及在修改代码时保持测试套件通过的纪律。
这与编程和 DSA 题库直接对应——在 FDE 轨道中,题库偏向生产任务而非竞赛编程谜题。下面四种模式覆盖了你将看到的大部分内容。
模式 1:带重试、退避和幂等性的 API 集成
经典的 FDE 编程任务:为一个会间歇性失败的第三方 API 编写客户端,并确保其安全。初级的版本直接调用接口,遇到第一个超时就崩溃。资深的版本会用指数退避加抖动来重试失败的调用,遇到 429 时遵循 retry-after 响应头,并使用幂等键,确保重复运行任务不会产生重复记录或重复扣款。 import time, random, requests
import time, random, requests

def post_with_retry(url, payload, idem_key, max_attempts=5):
    """POST that is safe to re-run: idempotency key + backoff on transient errors."""
    headers = {"Idempotency-Key": idem_key}
    for attempt in range(max_attempts):
        resp = requests.post(url, json=payload, headers=headers, timeout=5)
        if resp.status_code < 500 and resp.status_code != 429:
            return resp  # success or a real client error; do not retry
        if attempt == max_attempts - 1:
            resp.raise_for_status()
        retry_after = resp.headers.get("Retry-After")
        delay = float(retry_after) if retry_after else (2 ** attempt) + random.random()
        time.sleep(delay)
``` 面试官关注的信号:你能否区分暂时性的 500 或 429(应重试)与 400(不应重试,重试也永远会失败)?你是否限制了重试次数,避免一个失效的端点卡住整个任务?你是否加入了抖动(jitter),避免大量客户端同步重试造成“惊群效应”?而决定成败的一个问题是:该操作是否幂等,即把整个摄取流程跑两遍后系统状态是否保持一致?基于记录自然标识派生的幂等键(idempotency key)是正确做法。带退避的重试、限流和幂等性是这项任务的核心,所以要能讨论其中的权衡,而不只是把循环写出来。
模式 2:解析混乱的真实世界数据
客户数据从来都不干净。一个贴近实际的任务会给你一份 CSV 导出文件,其中日期格式混杂、大小写不一致、字段缺失、空值以空字符串或 "N/A" 或 "null" 表示、存在尾部空白,甚至中间还混入了一行重复的表头。你的任务是把它规范化为干净的数据记录。
陷阱在于假设输入是干净的。强有力的做法是对每一种脏数据情况都显式处理:防御性地解析,针对每个字段判断坏值是可丢弃还是致命的,并且绝不让一行格式错误的数据毁掉整个运行。 ```python
from datetime import datetime

NULLS = {"", "n/a", "null", "none", "-"}

def parse_date(raw):
    s = (raw or "").strip()
    if s.lower() in NULLS:
        return None
    for fmt in ("%Y-%m-%d", "%m/%d/%Y", "%d-%b-%Y"):
        try:
            return datetime.strptime(s, fmt).date()
        except ValueError:
            continue
    raise ValueError(f"unparseable date: {raw!r}")

def clean_rows(rows):
    cleaned, errors = [], []
    for i, row in enumerate(rows):
        try:
            cleaned.append({"id": row["id"].strip(), "date": parse_date(row.get("date"))})
        except (ValueError, KeyError) as e:
            errors.append((i, str(e)))  # collect, do not crash
    return cleaned, errors
能赢得好评的点:你收集错误而不是在第一条就崩溃,你对缺失字段是跳过还是硬失败做出了明确决策,并且你能向客户解释这个决策。把错误列表与干净数据一并返回,正是 FDE 在一线实际做的事,因为客户需要知道哪些记录没有加载成功以及原因。
模式 3:端到端的小型 RAG 流水线
你可能会被要求在少量文档上构建一个极简的检索流水线:对文本分块(chunk)、对分块做向量化(embed)、存储它们、针对查询检索最匹配的结果,并把它们连同引用一起填入提示词(prompt)。没人指望你在 45 分钟内做出生产级系统。他们期望的是一条能跑通的端到端路径和合理的技术选择。
他们关注的是:合理的分块大小并带少量重叠,以免把一个句子从思路中间切开;检索较小的 top-k,而不是把所有内容都塞进上下文;以及返回引用,让答案可验证。如果有时间,可以谈谈你会如何评估它,因为评测是把演示变成客户信任的产品关键。更深入的版本体现在 RAG 和 Agent 设计工作中,哪怕只是简单提一句你会如何衡量检索质量,也能让你与那些止步于“它返回了结果”的候选人区分开来。
模式 4:重构能运行但很丑陋的代码,测试保持通过
这一轮你会拿到一个能运行且有测试的混乱函数,并被要求将其清理。核心要点是在不改变行为的前提下改进代码。先运行测试确认全部通过。小步重构,每一步之后都运行测试套件。如果发现测试未覆盖的行为,先添加一个测试将其固定,再去改动那条路径。绝不要在重构后让测试套件挂掉,也绝不要重构尚未用测试锁定保护的代码。
这是四种模式中最贴近实际的一轮,因为大部分 FDE 工作是修改客户现有的系统,而不是从零开始写新代码。把测试当作契约、全程保持测试通过的候选人,会在整个面试流程中发出最清晰的高级工程师信号。而那些为了优雅而重写代码、留下三个测试失败的候选人,无论结果看起来多干净,都会挂掉这一轮。
如何准备
构建小型、真实的项目,而不是刷题。写一个幂等的 API 客户端,能处理 429 错误并按键去重。拿一个故意做得很乱的 CSV,写一个能扛住它的解析器。用几份 PDF 搭建一个小型 RAG 流水线。在测试套件的保护下重构你自己的旧脚本。为电面保留轻量的算法练习,但把大部分时间花在异常路径上,因为这一轮的胜负就在那里。刷编码和 DSA 题库,学习该岗位考察的技能,并对照必知清单进行校准。
一句话版本
别再为算法谜题优化,开始练习生产任务:安全地集成不稳定的 API、解析不配合的数据、端到端搭建检索,以及在不破坏测试的前提下重构。这就是实际工作,所以这就是面试。
把它变成 offer。刷与上述内容对应的真实面试题和概念:
FAQ
有时电面会包含一道简单或中等难度的题目,以确认你能在轻度压力下写出正确的代码,所以不要完全跳过练习。但决定整个流程的轮次看起来像真实工作:集成不稳定的 API、解析混乱的文件、搭建小型检索流水线,或者在不破坏功能的前提下清理代码。优化动态规划解法很少是让一位优秀工程师被录用或被拒的原因。
一项开放式、贴近生产环境的任务,通常在 IDE 中完成,并可能提供联网条件。例如:为某个第三方 API 编写客户端,该 API 会间歇性失败,且重试时绝不能重复扣费;规范化一个充满不一致日期格式和缺失字段的 CSV;基于少量文档构建一个最小化的 RAG 流水线;或者重构一个能运行但结构混乱的函数,同时保持其测试通过。评判标准是你的判断力和健壮性,而不是聪明程度。
非常重要。在改变行为之前先写测试,或者添加一个测试来固定你刚处理的边界情况,这是你能发出的最明确的高级工程师信号之一。尤其是在重构任务中,核心要点就是在改进代码的同时保持现有测试通过。那些重构后破坏了测试、或者根本不运行测试的候选人,即使代码看起来更整洁,也会在这一轮被淘汰。
只有部分作用。保留一些算法练习以应对技术初筛,但把大部分时间转移到构建小型、贴近实际的项目上:一个幂等的 API 客户端、一个脏数据解析器、一个小型 RAG 流水线。你要锻炼的能力是干净地处理不顺利的路径(超时、重试、错误输入、部分失败),而标准的 LeetCode 刷题永远不会训练到这一点。
讨论(5)
刷两个月的 LeetCode 对于真正决定这一轮成败的环节来说,是很糟糕的准备。实际任务更像是:“这里有一个 API,大约每十次调用就有一次超时,请编写一个客户端,在不重复处理任何记录的前提下导入所有数据。”这考察的是幂等键和指数退避,而不是图遍历,刷二叉树题帮不了你。
这是整个流程中最常见的意外。解决办法是有意去构建不顺利的路径:一个能处理 429、带退避和抖动进行重试、按键去重、并且可以安全地重复运行的客户端。如果你能凭记忆做到这一点,你就已经领先于大多数候选人了。
在给定的时间内,代码需要打磨到什么程度?我总是因为想做到完美而时间不够,最后只完成了一半。
能运行且诚实胜过精致但不完整。先让端到端的路径跑起来,哪怕很丑,然后处理明显的失败情况,并留一条注释说明如果有更多时间你会加固哪些地方。面试官会奖励那些交付了正确成果、并清楚认识自身不足的候选人。
被低估的技能:解析垃圾数据。真实的客户导出文件中混杂着各种日期格式、尾部空格、以五种不同方式编码的空值,还有偶尔出现的重复表头行。那些假设输入是干净的候选人,一旦面试官递给他们真实文件就会崩溃。