# 评测技能鸿沟:2026 年 70% 的 FDE 候选人栽在这里
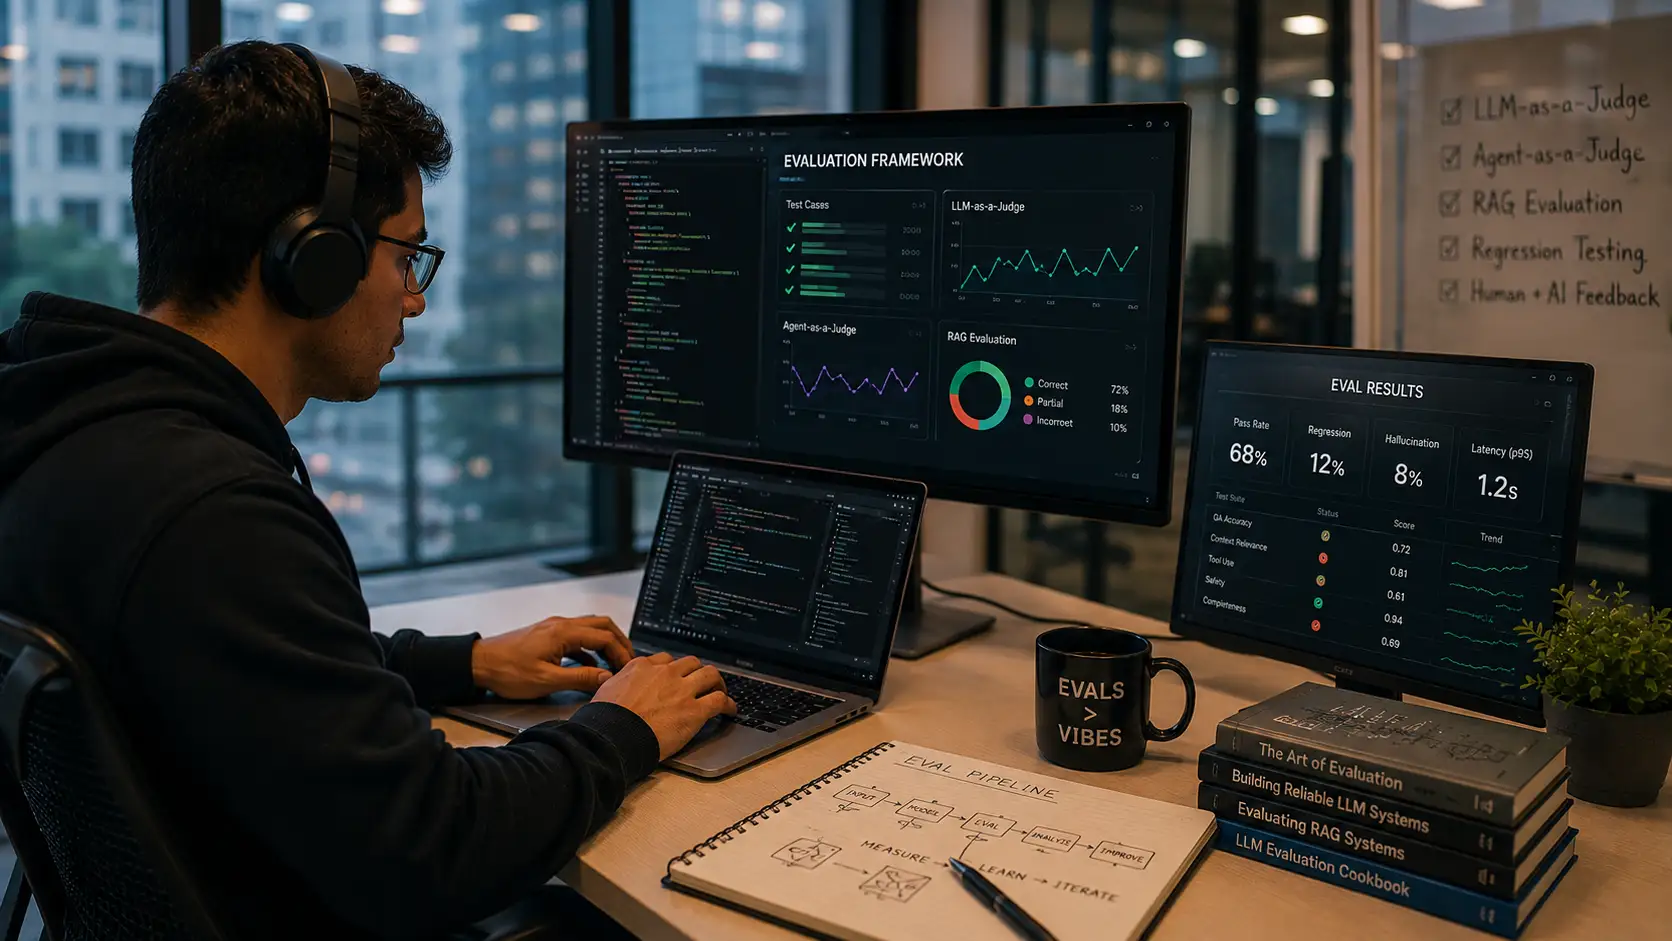
- 终极筛选器:缺乏评测工程知识是候选人在顶级实验室终面中被淘汰的最常见原因。
- 概率性测试:标准单元测试对 LLM 无效。你必须精通 LLM-as-a-Judge 和 Agent-as-Judge 架构。
- 回归纪律:候选人必须能够在白板上设计出完整的回归评测套件,包括黄金数据集和漂移检测。
- 工具熟练度:理解如何为 Braintrust、Langfuse 或 DeepEval 等可观测性框架进行埋点,如今已是基本要求。
前沿部署工程师的评测工程技能如今已成为 OpenAI 和 Anthropic 面试的门槛——了解大多数简历都忽略的 LLM-as-Judge 技能缺口。
如果你以为掌握构建标准检索增强生成(RAG)流水线的能力就足以拿到 50 万美元的 offer,那你正走进一个陷阱。
正如我们在《前沿部署工程师 2026 全景指南》中确立的,瓶颈不再是部署模型,而是证明模型可以安全地投入生产。
顶级 AI 实验室拒绝优秀的软件工程师,不是因为他们不会写代码,而是因为他们不知道如何定量评估概率性输出。
## 前沿部署工程师的核心评测工程技能
当你将一个 AI Agent 部署到财富 500 强公司的遗留系统中时,确定性的单元测试就变得毫无用处。
You cannot write a standard
assert()
function when the output changes based on temperature, token limits, and contextual drift. This is where
evals engineeringbecomes critical.
要通过严格的 OpenAI FDE 面试问题,你必须展示一套系统性的方法来衡量非确定性行为。
面试官想看的是你如何在大规模场景下处理幻觉率、毒性约束和上下文相关性。
## LLM-as-a-Judge 与 Agent-as-Judge
你必须掌握的基础概念是 LLM-as-a-Judge 框架。
它是指使用一个能力强大的模型(如 GPT-4o 或 Claude 3.5 Sonnet),依据特定的评分标准来评估你部署的、通常规模较小的生产模型的输出。
然而,现代面试会进一步深入 Agent-as-Judge 评估。
简单的 judge 只检查单个输出,而 agent-as-judge 会遍历多轮对话轨迹。它评估的是被部署的 Agent 是否采取了正确的中间步骤、是否调用了合适的工具,以及是否在长时间任务中成功从外部 API 错误中恢复。
## 构建回归评测套件
在企业级 AI 中,一次成功的提示词毫无意义。你必须构建一个回归评测套件。
每当你更新提示词、更换嵌入模型或调整分块策略时,都必须运行这个套件,以确保没有在边缘场景中造成性能退化。
未能实现这些防护栏的工程师,正是当客户的客服机器人幻觉出法律建议时要承担责任的人。
这与健壮的系统设计以及实现严格的 AgentOps 可观测性熔断机制密切相关。
DeepEval、Langfuse 还是 Braintrust:如何选择你的框架
在面试中,你不可能完全从零开始构建这些系统。你需要展现出你对行业标准可观测性和评测平台的熟练掌握。
DeepEval 与 Braintrust 与 Langfuse 的对比是 FDE 系统设计环节中常见的主题。
- Braintrust:深受顶尖 AI 实验室青睐,因其严谨的企业级评分和无缝的提示词 playground 集成。
- Langfuse:在开源链路追踪可观测性方面表现出色,让你能够可视化地调试复杂的多步骤 Agent 链。
- DeepEval:为 RAG 应用提供了出色的开箱即用指标,包括上下文精确度和答案相关性。
知道该向高度受监管的企业客户推荐哪种工具,体现了你在技术约束下的关键客户同理心。
为你的作品集构建黄金数据集
为了在面试前证明你具备这些技能,你必须创建一个黄金数据集。
黄金数据集是一套精心策划的输入和完美的预期输出集合,用作你评测中无可争议的基准真值。
在构建你的 FDE 作品集项目时,不要只是把一个 RAG 应用推送到 GitHub。请包含一个存放你的黄金数据集的目录(哪怕只有 50 个高质量的问答对),以及一个自动化的 GitHub Action,在每次提交 pull request 时对其运行评测套件。
对于内部企业战略而言,这类似于搭建一个内部聊天机器人竞技场,从领域专家那里众包基准真值数据。你还可以通过印度最好的 AI 领导力课程进一步打磨这种组织知识。
FDE 评测工作流与研究工作的区别
最后,要明白你是在做部署,而不是做研究。
研究团队的评测工作流侧重于 MMLU 或 HumanEval 等宽泛基准,以证明模型的通用智能。
FDE 评测工作流则完全聚焦于客户的具体业务逻辑。你的评测必须衡量延迟预算、每次查询的 token 成本上限,以及严格的监管合规准则。
如果你能在白板上设计出一个系统,在模型回归波及客户生产服务器之前将其捕获,同时保持在 API 预算之内,你就能拿下这份 offer。
常见问题(FAQ)
FDE 需要精通 LLM-as-a-Judge 框架、多轮 Agent 链路评测,以及回归评测套件的构建。他们还必须知道如何策划黄金数据集,以及如何为可观测性平台埋点,以捕获生产环境中的概率性模型漂移。
是的,这是必考内容。两家实验室都将评测工程作为主要的把关环节。面试官会刻意考察你是否理解为什么朴素的 LLM-as-Judge 设置在复杂的 Agent 链路上会失效,并期望你能够设计出健壮的变通方案。
LLM-as-Judge 通常针对特定的评分标准评估单个静态的输入-输出对。Agent-as-Judge 则复杂得多,它需要评估多轮交互、工具调用准确性,以及整个自主 Agent 工作流中的错误恢复行为。
这三者都非常相关。Braintrust 在企业级评分方面表现出色,Langfuse 擅长为复杂的 Agent 链提供可视化追踪可观测性,而 DeepEval 则提供了专为 RAG 流水线评估量身定制的、开箱即用的卓越指标。
首先,手动整理 50 到 100 个与你的项目领域高度相关的具体边界情况输入和完美的预期输出。这个数据集将作为回归测试套件在自动化测试中进行评分的不可变基准真值。
当然。你必须能够在白板上完整画出包含黄金数据集和自动化漂移检测的回归评测套件。如果未能将这些评测关卡纳入你的系统设计架构,会立即被淘汰。
构建一个简单的 RAG 流水线,并搭配一个包含 50 个问题的黄金数据集。编写一个自动化脚本,利用 LLM-as-Judge 框架对流水线的输出进行幻觉和上下文相关性评分,并将指标输出到仪表板。
研究团队评估的是宽泛的智能基准(如 MMLU)。而 FDE 构建的是高度具体、以客户为中心的工作流,专注于严格的业务逻辑、延迟预算、Token 成本,以及在遗留环境中严苛的监管合规约束。
大多数候选人来自传统的确定性软件背景。他们试图为概率模型编写标准的单元测试,并且缺乏设计能够优雅处理非确定性幻觉和上下文漂移的架构所需的概念词汇。
虽然了解 Galileo 这类专有企业工具是加分项,但精通 Langfuse、Braintrust 或 DeepEval 等开源或易于获取的框架就完全足够了。评测的底层方法论远比特定的厂商工具重要得多。