为什么 AI 创业公司需要前沿部署工程师:Palantir 手册
了解为什么 AI 创业公司必须招聘前沿部署工程师,以弥合从试点到生产的鸿沟、掌握企业级集成,并保护毛利率。
Key Takeaways
- Enterprise AI cannot close or retain six-figure contracts through self-serve product-led growth because enterprise data lives behind firewalls, custom security perimeters, and dirty legacy schemas.
- Enterprise founders evaluating why hire forward deployed engineers discover that embedded technical talent prevents pilot failure and turns customer friction into reusable platform code.
- The primary reason to adopt a forward deployed engineering strategy is trading short-term gross margin for a long-term enterprise moat that prevents pilot churn.
- Successful startups enforce the “Rule of Three” to avoid the agency trap, ensuring customer-specific code is systematically abstracted into reusable platform modules.
企业软件行业经历了一场深刻的结构性错位。在传统 SaaS 领域,创业公司通过产品驱动增长(PLG)将收入规模扩大到数千万美元。最终用户刷公司信用卡、通过浏览器仪表板集成 webhook,无需与任何人交谈就能采用应用程序。
对于企业级生成式和智能体系统而言,这套打法已经失效。当创始人向财富 500 强企业推销自主 AI Agent、企业级 LLM 编排或自动化决策流水线时,他们会立即撞上一堵运营高墙。企业买家并不缺预算;他们缺的是将实验性 AI 系统集成到拥有三十年历史的内部系统中的工程能力。
这种摩擦造成了臭名昭著的“试点到生产鸿沟”。超过 80% 的企业 AI 概念验证在进入生产部署之前就停滞了。潜在客户会签署名义上的评估合同,但软件无法与物理隔离的数据中心、遗留 ERP 数据库或定制身份边界对接。
理解为什么要招聘前沿部署工程师,如今已成为在财富 500 强销售周期中摸索前行的 AI 创始人所面临的核心战略问题。为了弥合这一鸿沟,顶尖的 AI 创业公司正在复兴并现代化由 Palantir Technologies 推广的一种组织模式:前沿部署工程师(FDE)。正如我们的《前沿部署工程师综合指南》中详细介绍的,这些嵌入客户现场的软件开发人员直接在客户环境中编写生产级代码。
本指南为创始人、首席技术官和工程负责人提供采用 FDE 模式的权威手册。我们分析了前沿部署工程策略的单位经济效益,建立了严格的架构护栏以防止你的创业公司沦为 IT 咨询公司,并演示了如何搭建你的创始现场工程团队。
1. The Death of Pure Self-Serve PLG in Enterprise AI
产品驱动增长(PLG)之所以成功,是因为 Web2 软件运行在标准化的 Web 协议之上。像 Figma、Slack 或 Notion 这样的 SaaS 产品只需要浏览器运行时和标准 REST API。最终客户在自己工作流程中承担了采用产品的运营负担。
企业级人工智能系统则在完全不同的物理和组织约束下运行。AI 系统不仅仅是展示数据;它们会对企业关键记录进行处理、转换并生成操作。
| 步骤 | 试点到生产的鸿沟 |
|---|---|
| 1 | [ 企业级 AI 演示 ] - → [ 签署 POC 合同 ] - → [ 鸿沟 ] |
| 2 | 精美的 UI - 5 万美元评估费 - 物理隔离的 VPC |
| 3 | 合成数据 - 90 天倒计时 - 脏乱的 Schema |
| 4 | 独立沙箱 - RBAC 故障 |
| 5 | PII 数据清洗 |
| 6 | WITHOUT FDEs | WITH FDEs |
| 7 | (试点死亡)v |
| 8 | [ 合同取消 ] [ 100 万美元以上生产环境 ARR] |
企业级 AI 的三大结构性障碍
试图部署企业级 AI 的组织会遇到三大结构性障碍,而自助式上手流程无法解决这些问题:
- 非结构化和脏乱的数据基础设施:企业数据并非存放在干净的 JSON 表格中。它们存在于本地部署的 Oracle 实例、未建立索引的 SAP 关系表、包含扫描版 PDF 的网络文件共享,以及碎片化的 Salesforce 自定义对象中。如果没有定制的 ETL 管道,前沿模型无法在脏乱的源 Schema 上执行可靠的 Agent 推理。
- 严格的物理隔离安全边界:银行、医疗、航空航天和国防等受监管机构禁止使用公共 SaaS API 路由。它们要求部署在私有虚拟云(AWS GovCloud、Azure 机密计算)中,或部署在企业 VPC 防火墙之后,且不允许任何出站访问。
- 幻觉与风险边界:传统软件的 Bug 会产生可预测的错误代码。相比之下,非确定性的模型失效会产生看似合理的幻觉、合规违规或未经授权的数据泄露。企业在授予生产数据库访问权限之前,要求严格的确定性评测轨道和持续的延迟监控。
为什么传统售前工程师力不从心
在评估为什么要招聘前沿部署工程师而不是传统售前人员时,创始人必须审视遗留数据的结构性摩擦。传统的解决方案架构师(SA)或售前工程师(SE)由于角色定位的根本错位,始终难以挽救陷入停滞的客户。
正如我们在“前沿部署工程师 vs 解决方案架构师 vs 售前工程师”对比中所解释的,售前工程师是商业演示者。他们制作幻灯片、演示架构蓝图、配置预打包的产品连接器。他们既没有接受过培训,也没有获得授权去重构客户端代码库、编写自定义异步 token 流式传输服务,或调试底层的 Kubernetes ingress 配置。
当企业客户说“我们的数据仓库使用带有自定义 Kerberos token 的专有二进制协议”时,售前工程师会向内部产品管理部门提交功能请求。而前沿部署工程师则会打开终端,检查客户的网络流量,并在四十八小时内编写出生产级适配器。
| 维度 | 纯自助式 PLG | 企业现场部署(FDE) |
|---|---|---|
| 目标客户 | 个人贡献者与中小企业 | 财富 500 强、全球 2000 强、国防部门 |
| 平均合同价值(ACV) | 1,200 美元至 15,000 美元 | 150,000 美元至 2,500,000 美元以上 |
| 销售周期时长 | 数天至数周(即时成交) | 3 至 9 个月(从试点到多年合作) |
| 主要部署障碍 | 产品认知与上手引导 | 遗留基础设施与数据质量 |
| 客户留存要素 | 功能实用性与界面简洁性 | 深度运营集成(高护城河) |
| 毛利率(第一年) | 80% 至 85% | 55% 至 65% |
| 毛利率(第三年及以后) | 80% 至 85% | 82% 至 88%(产品化之后) |
这一对比凸显了企业级创业者必须转变视角的原因。执行 palantir playbook enterprise ai deployment 并非辅助性的客户支持成本。对于高价值企业合同而言,它是获取和留存客户的核心引擎。
2. The “Absorb Pain, Excrete Product” Flywheel
Palantir 工程组织的核心理念浓缩在一句标志性的运营格言中:“吸收痛苦,产出产品。”对于人工智能初创公司而言,这一原则是实现真正产品市场契合(PMF)的最快途径。
在早期公司中,创始人和产品经理与客户现实之间存在认知距离。客户顾问委员会和产品调研的可靠性众所周知地低下。企业高管会告诉供应商他们自认为想要的东西;而他们实际的软件系统才揭示出他们真正迫切需要的东西。
这个飞轮回答了为什么在从零到一的产品验证阶段要招聘前沿部署工程师:他们将真实的客户痛点转化为可扩展的软件模块。
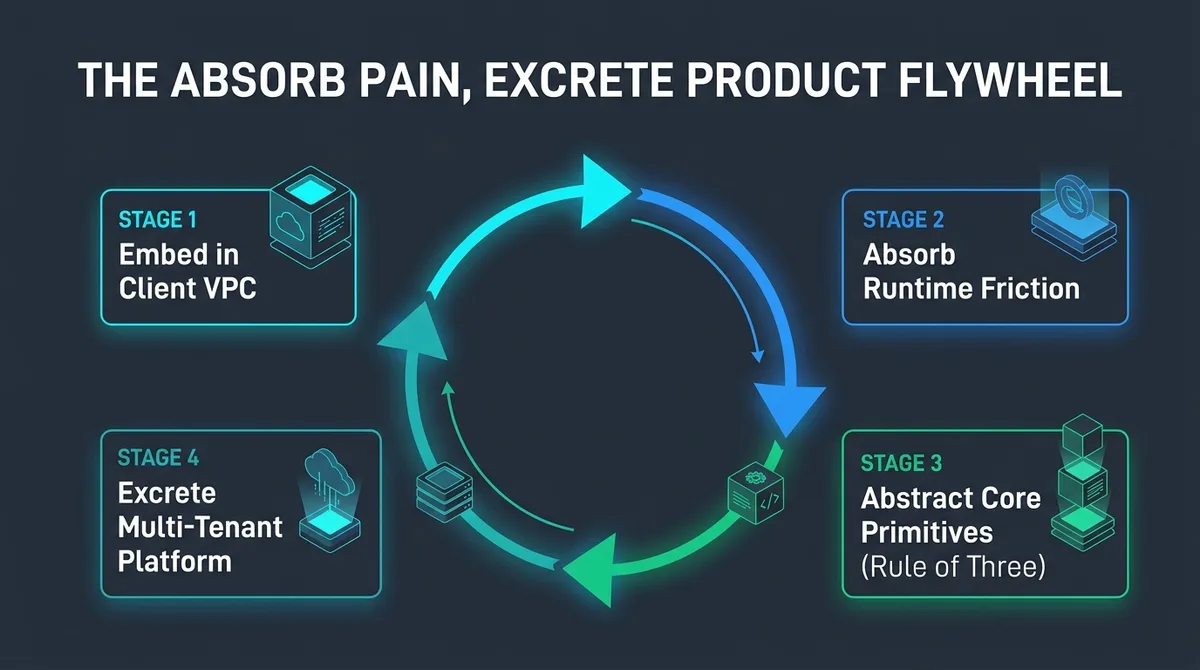
飞轮在实践中如何运转
前沿部署工程师如同直接嵌入客户基础设施中的高带宽产品探索探针。飞轮经历四个不同的阶段:
- 直接暴露于生产环境痛点:FDE 驻扎在客户的开发环境中,亲眼观察初创公司平台为何失败。他们发现客户的 Postgres 数据库在并发向量搜索下超时,或者其企业代理剥离了必要的 bearer token。
- 立即进行定制化修复:FDE 无需等待长达六周的产品路线图周期,而是在现场立即编写一个解耦的软件适配器。试点得以延续,高管层保持信心,企业也能立即看到业务价值。
- 跨部署的模式识别:当两三个不同的企业客户遇到相同的故障点时,FDE 会将这种摩擦标记为系统性的企业级模式,而非孤立的异常现象。
- 平台产品化:核心软件工程团队将现场工程师开发的经过实战检验的适配器逻辑进行重构,转化为原生的、可扩展的平台能力。接下来的十个企业客户即可开箱即用地获得该功能。
部署这一架构需要与前沿部署 AI 工程的企业部署架构保持严格的同步。当工程团队将现场摩擦视为核心产品开发的原始燃料时,产品迭代周期将呈数量级加速。
Palantir Foundry:诞生于客户部署的泥泞之中
Palantir 的旗舰企业平台 Foundry,并非由坐在帕洛阿尔托办公室里的产品经理构想出来。Foundry 直接源自前沿部署工程师在嵌入跨国航空航天制造商、全球金融机构和政府国防部门时所遇到的运营挑战。
Palantir 的早期工程师花费数千小时手动编写数据集成脚本、构建自定义实体本体,并解决跨客户数据集的分支合并冲突。由于现场工程师是拥有修改产品代码完全权限的资深开发者,他们构建了标准化工具来自动化解决自身的运营痛点。
这些内部自动化工具经过打磨、统一和封装,最终成为 Palantir Foundry。对初创公司执行这一 FDE 模式,将批评者口中“美化了的咨询公司”转变为一家拥有数十亿美元收入的平台型企业软件公司。
3. The Financial Calculus: Gross Margins vs. Enterprise Moats
对前沿部署工程模式最常见的反对声音来自风险投资人和财务纯粹主义者:“现场工程难道不会摧毁软件的毛利率吗?”
传统 SaaS 业务的毛利率目标在 75% 到 85% 之间。由于标准 SaaS 的销货成本(COGS)主要由云托管费用和第三方 API 成本构成,新增用户所需的增量人力支出极少。
当初创公司引入前沿部署工程师时,部署人力成本会计入销货成本。在企业合同的最初几个月,毛利率可能压缩至 55% 或 60%。
分析毛利率的变化轨迹,可以说明为什么企业初创公司应在商业化生命周期早期聘用前沿部署工程师:短期的部署成本能够保障多年期合同的扩展。
a16z 的论点:“用毛利率换取护城河”
风险投资公司 Andreessen Horowitz 在其关于“用毛利率换取护城河”的企业研究中,直接回应了这一数学上的矛盾。
其战略洞察十分直白:拒绝牺牲短期毛利率的初创公司,是在以牺牲客户合同为代价来保住财务指标。一家在纸面上拥有漂亮 85% 毛利率、却在客户入驻阶段流失 70% 企业试点的初创公司,构建的是一个不可持续的业务。
| 步骤 | 毛利率扩张轨迹 |
|---|---|
| 1 | 毛利率 % |
| 2 | 90% | ========================= |
| 3 | 80% | ========= (High-Margin Platform) |
| 4 | 70% | ========= |
| 5 | 60% | ========= |
| 6 | 50% | ================== (Initial Field Embedding) |
| 7 | +––––––––––––––––––––––––––––––––––– → |
| 8 | 第 1 年(试点) 第 2 年(扩展) 第 3 年及以后(成熟 SaaS) |
通过部署前沿部署工程师,人工智能初创公司在第 1 年接受较低的毛利率,以换取两个决定性的商业成果:
- 接近于零的试点流失率:通过指派顶尖工程人才攻克企业内部障碍,试点转化率通常可超过 90%。
- 高额净收入留存率(NRR):一旦 FDE 将 AI 系统集成到企业核心数据流中,切换成本将变得难以逾越。初创公司由此嵌入企业的运营体系之中。
Palantir 的毛利率先例
历史财务披露证实了这一经济曲线的可行性。在 Palantir 向美国证券交易委员会提交的公开文件中,公司披露在其早期运营阶段,高接触度的部署运营导致毛利率受到压缩。
然而,随着 Palantir 的核心平台日趋成熟、自动化集成能力不断扩展,其毛利率实现了持续、复利式的扩张。在近年的运营中,Palantir 持续报告超过 80% 至 82% 的毛利率,可与纯云 SaaS 提供商相媲美,同时保持着显著更高的合同价值。
理解这一岗位的职业取舍对于人才保留同样至关重要,正如我们在“前沿部署工程师与软件工程师的取舍分析”中所探讨的。当初创公司为现场工程师提供合理薪酬,并将其激励与企业扩展挂钩时,部署人员编制所带来的财务回报是相当可观的。
4. Avoiding the “Agency Trap”: Consultative Death Spirals
虽然前沿部署工程的商业优势令人信服,但这种模式也潜藏着一个严重、甚至可能是致命的风险:代理化陷阱(The Agency Trap)。
代理化陷阱是指早期创业公司对定制化的企业收入产生依赖。公司没有把客户项目当作构建标准化平台功能的临时探针,而是对每一个定制功能需求都说“好”。
当创始人追问为什么要招聘前沿部署工程师而不是外包给外部实施机构时,他们会发现现场工程师具备保护平台模块化的架构纪律。
在十二个月内,缺乏纪律的创业公司就不再是具备风险投资规模的软件平台。它们会蜕变为外包专业服务机构。人员编制必须随收入线性扩张,产品路线图碎裂成一个个客户专属的分叉,估值倍数也从 20 倍 ARR 崩塌至 2 倍 EBITDA。
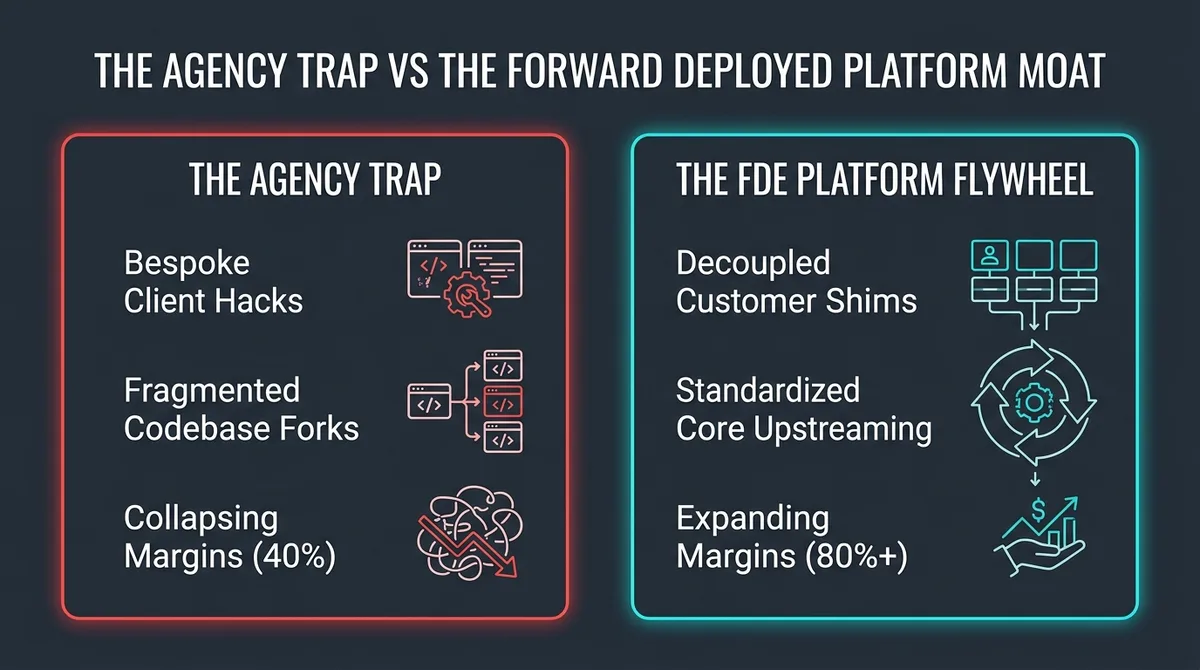
“三的法则”治理模型
为了保护产品架构和企业估值,高管团队必须建立严格的运营治理机制。最有效的框架就是“三的法则”:
- 单一客户需求:如果仅有一家企业客户要求定制 schema 解析器或遗留系统连接器,FDE 会将这段逻辑写成一个外部的、解耦的集成垫片(shim)。代码严格存放在核心 monorepo 之外。
- 两个客户需求:如果第二家独立企业提出类似功能需求,FDE 团队会创建一个实验性的模块化插件。核心产品工程团队会收到通知,并起草一个共享接口。
- 三个客户需求:当三家不同的企业客户需要相同的底层能力时,该需求会被归类为基础平台功能。核心平台工程团队接手所有权,对逻辑进行抽象,并将其发布到核心产品 SDK 中。
通过强制执行这一节奏,前沿部署工程师永远不会用一次性的客户补丁污染核心代码库。相反,他们在标准化的扩展点内工作,例如 Model Context Protocol 规范以及将定制业务逻辑与中央推理引擎隔离的企业级 Agentic AI 框架。
5. Production Code: The Decoupled Enterprise Ingestion Shim
为了防止客户特定的数据格式污染核心软件平台,前沿部署工程师会构建解耦的集成垫片。这些垫片在客户边界内运行,将专有数据模式转换为干净、标准化的内部模型,然后再将遥测数据发送到中央平台。
以下是一个基于 Python 和 FastAPI 框架构建的企业级生产实现。它展示了 FDE 如何将客户的遗留数据库记录解耦,清除敏感的个人身份信息(PII),并将标准化的数据负载路由回核心 AI 平台。
"""
Decoupled Enterprise Data Ingestion Shim
Author: Forward Deployed Engineering Team
Purpose: Normalize client-specific data schemas and stream telemetry to core platform.
"""

from typing import Dict, Any, Optional
from datetime import datetime, timezone
import hashlib
import httpx
from fastapi import FastAPI, HTTPException, Header, status
from pydantic import BaseModel, Field, EmailStr

app = FastAPI(
    title="FDE Enterprise Ingestion Bridge",
    description="Customer-edge adapter isolating legacy schemas from core AI platform.",
    version="1.2.0"
)

# -----------------------------------------------------------------------------
# Standardized Core Platform Schema (Immutable Across All Customers)
# -----------------------------------------------------------------------------
class CoreIngestionPayload(BaseModel):
    account_id: str = Field(..., description="Unique enterprise customer identifier")
    session_id: str = Field(..., description="Traceable user execution context")
    anonymized_actor_hash: str = Field(..., description="SHA-256 hashed identity token")
    normalized_content: str = Field(..., description="Sanitized text ready for vector embeddings")
    metadata: Dict[str, Any] = Field(default_factory=dict)
    ingested_at: datetime = Field(default_factory=lambda: datetime.now(timezone.utc))

# -----------------------------------------------------------------------------
# Customer-Specific Legacy Schema (Varies By Client Deployment)
# -----------------------------------------------------------------------------
class AcmeCorpLegacyRecord(BaseModel):
    EmployeeID: str
    InternalEmail: EmailStr
    DepartmentCode: str
    RawInternalTicketText: str
    ClientSecurityClearance: Optional[str] = "Standard"

class TelemetryResponse(BaseModel):
    status: str
    core_dispatch_id: str
    latency_ms: float

# -----------------------------------------------------------------------------
# Transformation & Redaction Logic (Maintained by FDE in Client VPC)
# -----------------------------------------------------------------------------
def sanitize_and_normalize(record: AcmeCorpLegacyRecord, account_id: str) -> CoreIngestionPayload:
    # Deterministic PII hashing to preserve auditability without exposing identities
    salt = "enterprise-vllm-perimeter-salt"
    actor_string = f"{record.EmployeeID}:{record.InternalEmail}:{salt}"
    actor_hash = hashlib.sha256(actor_string.encode('utf-8')).hexdigest()

    # Normalize unstructured legacy field into standardized platform prompt input
    clean_text = record.RawInternalTicketText.strip()

    return CoreIngestionPayload(
        account_id=account_id,
        session_id=f"sess_{hashlib.md5(clean_text[:50].encode('utf-8')).hexdigest()[:12]}",
        anonymized_actor_hash=actor_hash,
        normalized_content=clean_text,
        metadata={
            "department": record.DepartmentCode,
            "security_tier": record.ClientSecurityClearance,
            "bridge_version": "1.2.0"
        }
    )

# -----------------------------------------------------------------------------
# Edge Ingestion Endpoint
# -----------------------------------------------------------------------------
@app.post(
    "/v1/ingest/acme",
    response_model=TelemetryResponse,
    status_code=status.HTTP_200_OK
)
async def ingest_acme_record(
    record: AcmeCorpLegacyRecord,
    x_customer_token: str = Header(..., alias="X-Customer-Token")
):
    start_time = datetime.now(timezone.utc)

    # Validate client token against local secure vault
    if not x_customer_token.startswith("acme_prod_"):
        raise HTTPException(
            status_code=status.HTTP_401_UNAUTHORIZED,
            detail="Invalid customer deployment credentials."
        )

    # Transform bespoke enterprise format into core platform schema
    core_payload = sanitize_and_normalize(record, account_id="cust_acme_corp_global")

    # Forward to centralized core platform API via secure mutual TLS tunnel
    core_platform_url = "https://core-platform.internal.aiagentskit.com/v1/telemetry/events"

    async with httpx.AsyncClient(timeout=5.0) as client:
        try:
            response = await client.post(
                core_platform_url,
                json=core_payload.model_dump(mode="json"),
                headers={"Authorization": "Bearer fde_internal_edge_gateway_token"}
            )
            response.raise_for_status()
            dispatch_id = response.json().get("event_id", "evt_simulated_dispatch")
        except httpx.HTTPError:
            # Fallback: Cache locally in client VPC SQLite database during network blips
            dispatch_id = "evt_cached_locally_due_to_vpc_egress_drop"

    duration = (datetime.now(timezone.utc) - start_time).total_seconds() * 1000.0

    return TelemetryResponse(
        status="processed_and_dispatched",
        core_dispatch_id=dispatch_id,
        latency_ms=round(duration, 2)
    )
这种解耦的企业级 AI 部署策略带来两大关键商业优势。第一,客户特有的 schema 和 PII 约束在本地即可解决,不会泄露内部记录。第二,核心软件平台保持干净的多租户架构,从而保护公司的估值指标和 SaaS 毛利率。
6. When and How to Hire Your First Forward Deployed Engineer
过早采用前沿部署工程模式可能与过晚采用同样有害。在公司仅有早期最小可行产品(MVP)时就招聘高接触度的现场工程师,会导致毫无方向的咨询式工作。
反之,等到大型企业试点纷纷失败时才行动,则会造成客户流失和品牌受损。创始人必须依据具体的商业触发点来把握招聘时机。
招聘前沿部署工程师的触发点主要围绕交易规模和部署复杂度,尤其是当年度合同金额超过六位数时。
| 步骤 | FDE 招聘触发点清单 |
|---|---|
| 1 | [ ] 平均合同价值(ACV)超过每年 10 万美元 |
| 2 | [ ] 至少有 3 个企业试点正在积极协商部署日期 |
| 3 | [ ] 核心工程团队超过 30% 的迭代产能用于修复客户集成问题 |
| 4 | [ ] 客户要求本地部署 VPC 或物理隔离(air-gapped)安装 |
| 5 | [ ] 合同续签取决于能否通过企业信息安全合规审计 |
“创始现场工程师”画像
你的第一位前沿部署工程师的画像与标准软件工程岗位的招聘截然不同。在传统工程岗位中,技术卓越和算法能力在评估标准中占据主导地位。
对于创始现场工程师而言,技术能力仅仅是基本门槛。候选人必须具备高管气场、情绪韧性和深厚的商业直觉。
对于正在评估这一转型的软件开发者,我们关于如何成为前沿部署工程师的指南详细列出了在这一领域取得成功所需的确切作品集和技术里程碑。
| 评估维度 | 传统软件工程师 | 创始现场工程师(FDE) |
|---|---|---|
| 主要代码方向 | 内部服务、算法、测试 | 客户 VPC 适配器、SDK、ETL 管道 |
| 模糊性容忍度 | 中等(需要清晰的迭代需求说明) | 极高(调试无文档的遗留系统) |
| 客户接触 | 零至极少(由产品经理隔离) | 每天与 CIO 和 IT 团队直接互动 |
| 情绪稳定性 | 常规的同事协作 | 在高风险故障期间保持高度韧性 |
| 商业敏锐度 | 功能交付速度 | 理解合同扩展与净收入留存率(NRR) |
| 理想背景 | FAANG/规模化初创公司的后端开发者 | 曾任技术创始人、精英咨询公司负责人 |
薪酬结构与汇报关系设计
创始人常常为如何为前沿部署工程师定薪而苦恼。一个常见的错误是给 FDE 分配销售提成或可变的业绩奖金,把他们当作售前工程师来对待。
这种激励结构是灾难性的。如果 FDE 的薪酬取决于能否在季度内成交,他们就会答应客户提出的每一个定制功能需求,直接触发代理陷阱。
前沿部署工程师的薪酬应与核心软件工程的薪酬原则保持一致。
现场工程薪酬方案应优先考虑三个基础要素:
- 有竞争力的基本工资:与资深工程师的市场薪酬层级对齐(基本工资 175,000 至 240,000 美元)。
- 充足的股权:授予与基础平台架构师相当的股权份额,以奖励其对企业估值增长的贡献。
- 工程汇报线:直接向 CTO 或工程副总裁汇报,以防止销售驱动的代码技术债。
7. Organizational Architecture: Interfacing FDEs with Core Engineering & Sales
一旦初创公司招聘了多名前沿部署工程师,现场团队、核心产品工程部门和企业销售部门之间不可避免地会产生组织摩擦。
客户经理希望 FDE 编写定制代码以快速促成交易。核心平台工程师则希望 FDE 停止为单个客户请求架构修改。管理这种三方张力需要结构化的运营机制。
组织领导者理解为什么要聘请前沿部署工程师,从而在现场开发人员与核心工程总监之间建立直接的反馈机制。
| 步骤 | 企业级销售 |
|---|---|
| 1 | (客户经理) |
| 2 | 成交 |
| 3 | 前沿部署 |
| 4 | 工程 |
| 5 | 上游遥测数据 |
| 6 | 与三法则 |
| 7 | 核心平台 |
| 8 | 工程 |
每周“痛点复盘”机制
为了保持客户部署与核心平台路线图之间的紧密协同,工程管理层必须设立强制性的每周痛点复盘会议。
在这六十分钟的会议中,前沿部署工程师展示从活跃客户环境中提取的具体运营遥测数据:
- 哪些内部 SDK 方法在客户运行期间产生了未处理的异常?
- 客户的网络防火墙在哪些位置拦截了 AI Agent 的工具调用?
- 本周有哪些专有企业数据连接器需要定制适配层?
如果某个特定的集成障碍出现在多个客户部署中,核心工程负责人会创建一个专门的冲刺史诗任务(sprint epic),在平台层面解决该问题。这一做法将客户摩擦转化为平台防御力。
在评估这些高要求运营岗位的候选人时,工程管理层应参考我们的前沿部署工程师面试评分标准,以确保候选人经过真实客户危机场景的严格审查。
8. Frequently Asked Questions About the FDE Model for Startups
为什么聘请前沿部署工程师而不是传统软件工程师?
初创公司聘请前沿部署工程师,是因为企业级 AI 系统的失败发生在物理集成层,而非算法层。传统软件工程师基于结构化的产品需求构建内部平台功能。前沿部署工程师则直接嵌入企业客户环境中,调试脏数据模式、解决物理隔离(air-gapped)安全障碍,并确保关键任务系统从试点评测顺利过渡到数百万美元的生产合同。
执行前沿部署工程战略会损害初创公司的毛利率吗?
虽然前沿部署工程会引入部署人力成本,可能将第一年的毛利率压缩至 55% 到 65% 之间,但它保护了企业合同价值并消除了试点流失。随着定制化集成逻辑被抽象为核心软件能力,毛利率在后续合同年度会提升至 80% 以上,从而构建起可与传统 SaaS 单位经济效益相媲美的防御性平台护城河。
初创公司如何防止前沿部署工程师变成咨询机构?
初创公司执行“三次规则”治理框架。如果有一个客户请求定制功能,FDE 会在核心代码库之外编写一个解耦的集成垫片。如果有两个客户请求该功能,则会开发一个实验性插件。如果有三个客户需要相同的能力,所有权将移交给核心平台工程团队,以构建标准化、可复用的产品功能。
一家早期初创公司需要多少前沿部署工程师?
大多数早期企业级 AI 初创公司只需要一到两名“创始现场工程师”来支持其最初的三到五个企业试点项目。随着公司规模扩大,组织通常保持每两到三个活跃企业客户部署配备一名前沿部署工程师的比例,并随着平台自动化自助集成成熟度的提高而逐渐降低这一比例。
前沿部署工程师应向销售部门还是工程部门汇报?
前沿部署工程师必须始终隶属于工程组织,通常向工程副总裁或首席技术官汇报。将 FDE 置于销售部门之下会造成错位的商业激励,促使工程师为了完成单个季度销售指标而编写不可持续的定制代码,而不是抽象出可扩展的平台能力。
创始前沿部署工程师的理想背景是什么?
理想的创始现场工程师应曾是技术创始人、经验丰富的全栈系统工程师,或来自顶尖技术咨询公司的高级技术负责人。候选人必须兼具深厚的系统编程能力(Python、Kubernetes、分布式数据库)、高管沟通技巧,以及在高风险客户场景中的情绪韧性。