如何成为前沿部署工程师:2026 年完整路线图、技能与作品集
掌握成为前沿部署工程师的路线图。了解核心技能、基础设施要求、作品集项目以及面试准备。
企业对人工智能模型的采用,催生了对能够在前沿研究与遗留企业基础设施之间开展工作的软件开发者的旺盛市场需求。前沿部署工程师已成为现代科技公司中最具价值、影响力最大的工程专业方向之一。
在各大科技公司,前沿部署工程师的总薪酬基准在 22 万美元至 48 万美元之间。在这些岗位上,典型的企业部署要求服务延迟低于 500 毫秒,运营可用性达到 99.9%。
转入这一领域面临独特的挑战,因为标准的软件工程训练营和算法面试准备无法应对真实的现场动态。有志于成为候选人的工程师不仅要掌握生产级后端工程,还要精通企业网络安全以及与高管利益相关者的沟通协调。
这份实用职业指南通过拆解所需的四层技能架构、作品集策略和面试流程,讲解如何成为前沿部署工程师。遵循这条结构化路径,将帮助你为在前沿人工智能实验室部署关键任务系统做好准备。有关现场工程职责的基础性介绍,请阅读我们的前沿部署工程师综合指南。
核心要点 四层技能栈: 成为一名 FDE 需要掌握四个不同的层次:核心分布式系统(Python、Go、SQL)、企业云基础设施(Kubernetes、VPC、SOC2)、应用 AI(RAG、Agent 编排、评测框架)以及现场沟通协调。作品集胜过 LeetCode: 顶级 AI 实验室更看重实际的系统集成能力,而非抽象的算法谜题。高含金量的作品集必须展示具备韧性的数据管道、模式校验以及自动化评测框架。拆解面试: FDE 的招聘流程强调标志性的“拆解环节”,候选人必须将模糊的业务痛点转化为结构化、可交付的软件架构。经验前提: 前沿部署工程很少是入门级岗位;候选人通常需要 2 至 4 年的软件开发、后端工程或 DevOps 实战经验。
成为一名前沿部署工程师需要具备什么条件?
成为一名前沿部署工程师需要掌握全栈系统工程、容器化云基础设施、应用人工智能工作流以及咨询式问题分解。成功的候选人应展现出克隆客户代码库、解决混乱的集成摩擦,以及在隔离的企业环境中部署生产级软件的能力。
与传统的核心软件工程师在公司防火墙后为数百万匿名用户构建功能不同,前沿部署工程师直接在前线工作。你需要深入复杂的客户环境——那里的数据库缺乏文档、网络策略屏蔽标准包管理器,而企业高管要求立竿见影的投资回报。
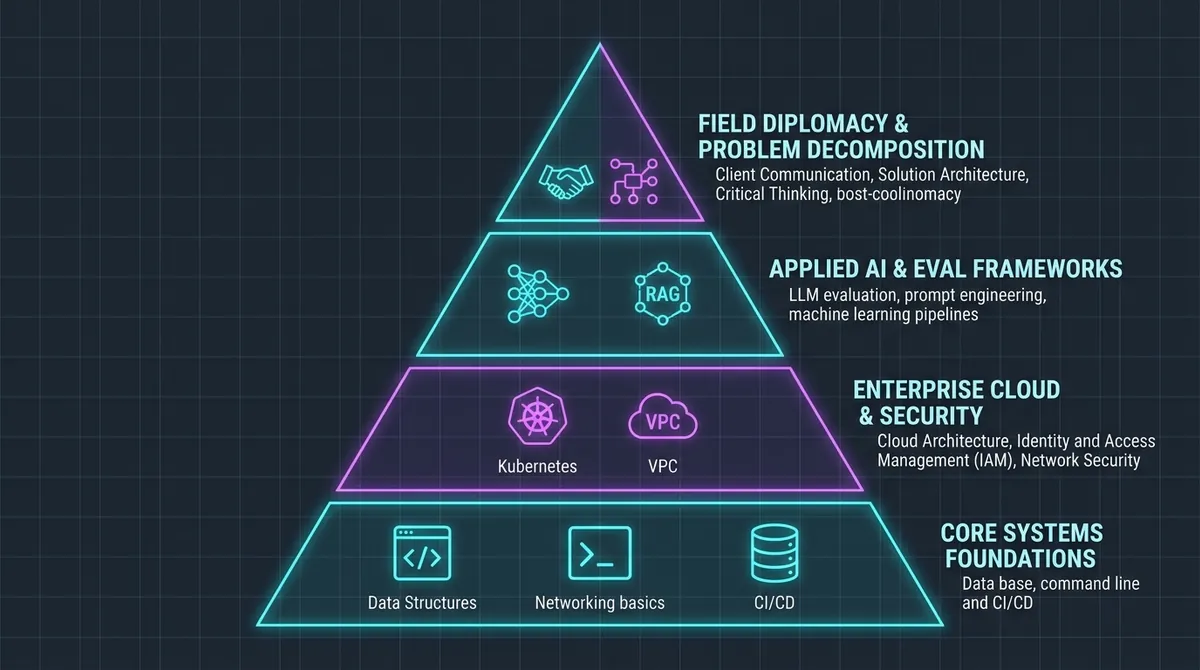 图 1:企业前沿部署工程岗位所需的四层技术技能金字塔。
理解完整的前沿部署工程师技能架构,需要透过表面化的职位描述去看本质。培养这些基础的 FDE 技能,使工程师能够在紧迫的交付期限内适应多样化的企业架构。最优秀的从业者将他们的技术发展划分为四个不同的层次:
- 第一层:核心软件系统基础: 生产级 Python、TypeScript 和 Go;模式校验;分布式 SQL;以及 API 契约设计。
- 第二层:企业云基础设施与安全: 多云 Kubernetes 部署、Helm 打包、VPC 对等连接、TLS 终止以及 SOC2 合规。
- 第三层:应用 AI 与生产级评测: 检索增强生成、Agent 状态机、工具协议以及自动化评测框架。
- 第四层:现场沟通与问题分解: 管理客户期望、将模糊的需求转化为工程里程碑,以及向上游提交产品修复。
工程组织很少招聘应届毕业生担任前沿部署岗位。招聘经理更青睐那些已有两到四年管理后端微服务、维护云基础设施或主导技术型客户合作经验的候选人。
第一层:核心软件工程与分布式系统基础
任何现场部署岗位的基石都是世界级的软件工程。当你嵌入客户环境中时,你无法提交内部支持工单,也无法将 bug 升级给其他团队。你必须独立诊断内存泄漏、解析陌生的代码库,并编写整洁、可维护的拉取请求。
Python 是企业 AI 集成的主要语言。你必须使用 Python 3.11 或更新版本编写现代化、异步、带类型标注的 Python 代码。这包括深入熟悉异步事件循环、Pydantic 数据建模以及性能分析。
除 Python 之外,生产环境还要求精通其他后端语言:
- TypeScript 和 Node.js: 对于构建企业级 Web 界面、客户门户集成以及全栈管理控制台至关重要。
- Go 或 Rust: 越来越多地被用于构建高吞吐量数据处理 sidecar、自定义反向代理和低延迟 API 网关。
- 高级 SQL 与数据规范化: 编写复杂的分析窗口查询、设计事务性数据库模式,并在 PostgreSQL、Snowflake 和 BigQuery 上优化数据库索引。
数据契约是企业部署中的主要故障点。客户数据库经常输出格式错误的 JSON、缺失的时间戳和未转义的字符串。FDE 通过使用 Protocol Buffers、gRPC 以及开放的 Model Context Protocol 服务器架构 实现严格的序列化边界,来保护核心平台。
第 2 层:企业云基础设施、安全与合规
即使是最先进的人工智能模型,如果安全架构师拒绝部署它,也无法为企业带来任何价值。银行、医疗保健和国防领域的企业客户要求软件在其私有虚拟私有云(VPC)或完全物理隔离(air-gapped)的数据中心内运行。
一名前沿部署工程师必须是一位经验丰富的系统运维人员,能够在不同的云服务商之间打包和编排分布式应用程序:
- 容器化与编排: 构建精简的多阶段 Docker 镜像、配置 Kubernetes 部署清单,以及为客户 DevOps 团队创建可复用的 Helm charts。
- 私有网络与 VPC 拓扑: 在 AWS、Azure 和 Google Cloud Platform 上配置子网、路由表、NAT 网关、VPC 对等连接和私有端点。
- 身份验证与身份联合: 使用 SAML 2.0、OpenID Connect(OIDC)以及 Okta 和 Microsoft Entra ID 等企业身份提供商集成单点登录(SSO)系统。
- 零信任安全与合规: 实施双向 TLS(mTLS)、通过 HashiCorp Vault 进行密钥轮换,以及静态和传输中的数据加密。
在物理隔离环境中运行会带来独特的限制。公共软件包仓库、基础容器镜像仓库和互联网端点完全不可用。你必须配置本地容器镜像源、将 Python wheel 打包成离线 tarball,并管理物理隔离的制品仓库。
FDE 与企业合规团队紧密合作,确保软件符合 SOC2 Type II、HIPAA 和 ISO 27001 审计标准。熟悉 Kubernetes 架构文档 为在严格的企业防火墙下配置高可用集群提供了必要的基础。
在部署自主模型时,保护客户数据管道同样至关重要。有关加固企业 Agent 部署的详细技术解析,请查阅我们的指南《企业 AI Agent 安全最佳实践》。
第三层:应用人工智能与生产环境评测
虽然核心工程和基础设施提供了交付机制,但现代 FDE 职位要求具备应用人工智能方面的深厚专业知识。你不需要机器学习理论方向的博士学位,也不需要从零开始训练基础模型的经验。相反,你必须掌握让预训练模型在杂乱的企业数据上可靠运行的实操模式。
生产级检索增强生成(RAG)是许多企业 AI 部署的核心。在现代企业环境中,处理管道常常需要摄取超过 128k token 的上下文窗口,因此需要语义缓存来将响应时间缩短 400 毫秒,并将 token 成本降低 45%。要超越简单的教程脚本,就需要实现复杂的检索架构:
- 混合搜索管道: 将稠密语义向量搜索与稀疏关键词搜索(BM25)以及交叉编码器重排序算法相结合。
- 高级文档分块: 开发尊重文档表格、视觉层级和结构化元数据的语义分块策略。
- 嵌入与上下文缓存: 利用 Redis 或专用向量数据库(Pinecone、Qdrant、Milvus)来最小化 token 消耗并降低推理延迟。
为了验证模型在客户管道中的可靠性,前沿部署工程师会构建自动化评测框架。这些测试套件针对精心整理的客户测试集执行回归测试,衡量语义精确度、上下文召回率和延迟上限。
下面的 Python 实现展示了一个生产级评测套件,用于根据延迟约束和严格的模式校验对模型输出进行基准测试:
# ==============================================================================
# FORWARD DEPLOYED ENGINEER: Enterprise Model Evaluation Suite
# Purpose: Automated regression test verifying JSON schema adherence & latency SLA.
# Dependencies: pydantic, time, typing
# ==============================================================================
import time
import logging
from typing import Dict, Any, List, Optional
from pydantic import BaseModel, Field, ValidationError

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")
logger = logging.getLogger("FDE.EvalSuite")

class ExtractionResult(BaseModel):
    """Schema contract for enterprise document extraction pipeline."""
    document_id: str = Field(..., pattern=r"^DOC-[0-9]{6}$")
    risk_score: float = Field(..., ge=0.0, le=1.0)
    entities: List[str] = Field(..., min_items=1)
    confidence_level: str = Field(..., pattern=r"^(LOW|MEDIUM|HIGH)$")

class ModelEvaluationRunner:
    """Evaluates customer-facing model endpoints against operational SLAs."""

    def __init__(self, latency_threshold_ms: float = 800.0, min_confidence: str = "MEDIUM"):
        self.latency_threshold_ms = latency_threshold_ms
        self.min_confidence = min_confidence

    def evaluate_test_case(self, raw_model_response: Dict[str, Any], elapsed_ms: float) -> Dict[str, Any]:
        eval_metrics = {
            "latency_pass": elapsed_ms <= self.latency_threshold_ms,
            "schema_pass": False,
            "business_rule_pass": False,
            "latency_ms": elapsed_ms,
            "error_detail": None
        }

        # 1. Enforce strict schema validation
        try:
            validated = ExtractionResult(**raw_model_response)
            eval_metrics["schema_pass"] = True
        except ValidationError as err:
            eval_metrics["error_detail"] = f"Schema validation error: {err.errors()}"
            logger.error("Test case failed schema validation: %s", err.json())
            return eval_metrics

        # 2. Enforce enterprise business logic assertions
        if validated.confidence_level in ["MEDIUM", "HIGH"] and validated.risk_score < 0.85:
            eval_metrics["business_rule_pass"] = True
        else:
            eval_metrics["error_detail"] = "Confidence score below enterprise threshold or risk score elevated."

        logger.info("Test case evaluated: Latency: %.2fms, Schema: %s, Rule: %s",
                    elapsed_ms, eval_metrics["schema_pass"], eval_metrics["business_rule_pass"])
        return eval_metrics

# Simulation of a production test execution
if __name__ == "__main__":
    runner = ModelEvaluationRunner(latency_threshold_ms=500.0)

    # Mocking real-time model extraction output
    sample_payload = {
        "document_id": "DOC-883921",
        "risk_score": 0.24,
        "entities": ["Acme Corp", "General Fund", "Subsea Holdings"],
        "confidence_level": "HIGH"
    }

    start_time = time.perf_counter()
    time.sleep(0.08)  # Simulated inference overhead
    duration_ms = (time.perf_counter() - start_time) * 1000

    result = runner.evaluate_test_case(sample_payload, duration_ms)
    print("Evaluation Summary:", result)
想深化应用 AI 技能的工程师应查阅 Pydantic 官方文档,以掌握数据校验契约。要了解完整的端到端检索架构,请参阅我们的实用指南《构建生产级 RAG 管道》。
第四层:现场沟通、问题拆解与客户沟通艺术
将资深前沿部署工程师与孤立的后端开发人员区分开来的素质,是咨询式的问题拆解能力。在传统工程岗位中,产品经理会将业务需求转化为附带验收标准的详细 Jira 工单。而在现场工程中,你面对的是直接来自客户高管的模糊且带有情绪色彩的问题描述。
一位首席运营官可能会说,他们的合规审计需要三周时间,分析师们不堪重负。FDE 无法向客户索要架构规范文档,而是必须将这种运营层面的痛点分解为具体的技术需求:
- 满足审计清单需要哪些结构化数据点?
- 哪些遗留数据库存储着历史审计决策?
- 提取管道必须达到怎样的吞吐量和延迟基准?
- 对于低置信度的分类结果,需要什么样的人工审核工作流?
客户关系维护需要应对企业软件中的社交动态。客户的开发人员往往对厂商工程师持怀疑态度,担心外部软件会取代他们的工作或带来维护噩梦。成功的 FDE 通过编写整洁的代码、记录每一个集成点以及与内部工程师结对协作来建立信任。
此外,前沿部署工程师通过“吸收摩擦、反哺产品”的循环来推动母平台的路线图。当 FDE 为特定客户构建自定义连接器时,他们会把适配器写得干净利落,然后将其抽象为可复用的平台模块,反馈给总部的产品团队。
在规划职业道路时,理解这种咨询式职责与销售岗位的区别至关重要。关于组织激励和薪酬分配的详细分析,请参阅我们的前沿部署工程师 vs 解决方案架构师 vs 售前工程师对比。
3 个能赢得 FDE 面试的高含金量作品集项目
工程类招聘经理每天要审阅数百份包含平庸 AI 套壳应用的简历。用通用的 OpenAI API 密钥构建一个基础聊天机器人,完全无法体现企业级能力。在选择你的 fde 作品集项目时,应优先考虑真实世界的故障模式、数据契约和生产部署架构。
在生产部署中,企业适配器通常需要处理超过 1000 万条记录,并满足 100 毫秒以内的查询要求。请专注于构建以下三个高含金量的作品集项目:
项目 1:企业遗留数据集成适配器
构建一条生产级数据管道,从遗留端点摄取脏乱的非结构化 CSV 或 JSON 数据,依据严格的模式校验记录,并将其分发到模拟的数据仓库。
你的 GitHub 仓库的关键技术要求:
- 使用 Pydantic 强制执行模式契约,处理类型转换、日期标准化和缺失字段。
- 实现指数退避和抖动算法,以应对速率限制和间歇性网络中断。
- 将损坏或无法解析的记录路由到死信队列(DLQ),并记录结构化错误日志以便审计。
- 提供完整的 Dockerfile 和本地容器环境,启动 PostgreSQL、Redis 和 worker 容器。
项目 2:具备自动化评测框架的生产级多模态 RAG
构建一个端到端的文档处理管道,解析包含表格和图表的复杂多栏 PDF,执行混合语义搜索,并评估答案准确性。
你的 GitHub 仓库的关键技术要求:
- 使用混合分块策略导入文档,保留表格格式和章节层级。
- 将文档向量存储在自托管的向量数据库(如 Qdrant 或 Milvus)中,并配套词法 BM25 索引。
- 构建自动化评测套件,衡量答案相关性、上下文精确度和延迟百分位(P95 和 P99)。
- 在项目 README 中记录成本-延迟分析,比较不同的分块大小和嵌入模型。
项目 3:安全的模型上下文协议(MCP)工具服务器
基于开放的 Anthropic Model Context Protocol Documentation 实现一个企业级工具服务器,让自主运行的 AI Agent 能够安全地查询企业数据。
你的 GitHub 仓库的关键技术要求:
- 通过标准化的 MCP 服务器接口暴露安全的数据库搜索和分析工具。
- 实施基于角色的访问控制(RBAC),防止在敏感表上未经授权执行工具。
- 添加结构化的 Prometheus 指标,跟踪工具调用率、失败次数和执行延迟。
- 提供清晰的架构图,详细说明网络边界和凭证处理方式。
用清晰的架构图、可复现的安装脚本和自动化测试套件来组织这些仓库,能证明你具备生产工程师的思维方式。如需更多关于设计符合招聘要求的系统的灵感,请参阅我们的符合招聘要求的 AI 工程作品集项目指南。
五阶段职业转型路线图
转型进入前沿部署工程需要在四到六个月内进行有纪律的执行。这份结构化的 20 周前沿部署工程师路线图将整个旅程分解为可管理的里程碑:
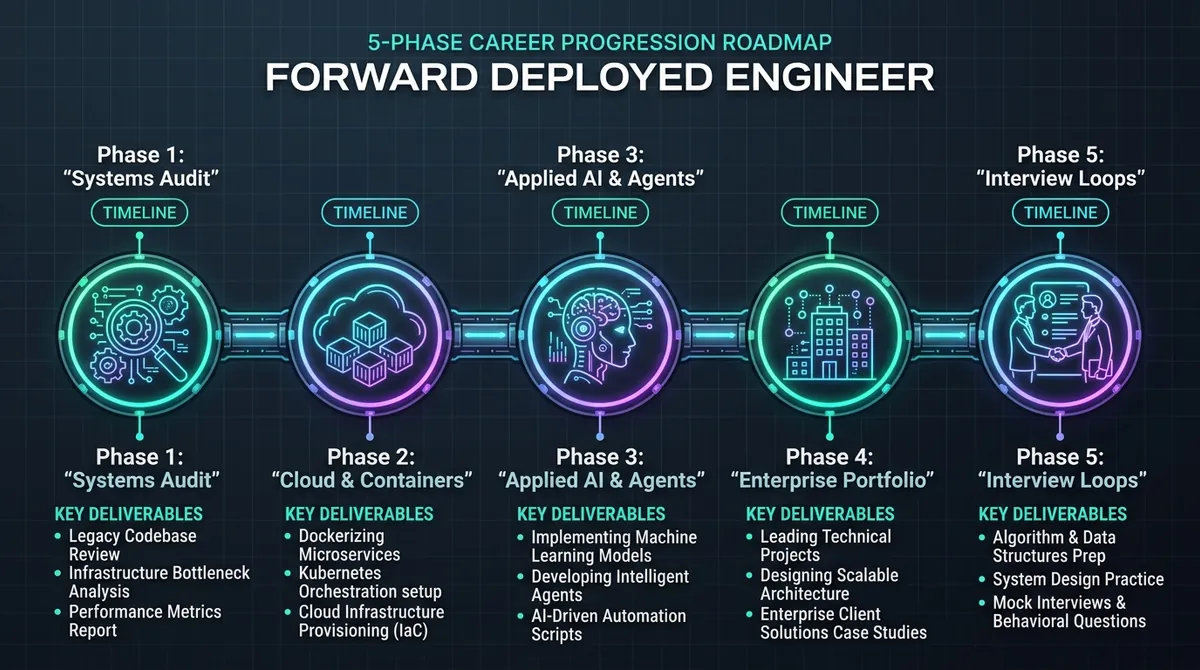 图 2:转型进入前沿部署工程的五阶段职业进阶路线图。
阶段 1:系统工程审计(第 1 至 4 周)
对你的后端编程深度进行一次诚实的评估。如果你的背景主要是前端开发,请在这个阶段专注于掌握后端系统:
- 加深对现代异步 Python、数据结构和类型注解的熟练程度。
- 练习构建干净的 RESTful API 和 gRPC 微服务,并配备自动化的单元测试和集成测试。
- 掌握关系型数据库设计、索引策略和复杂的 SQL 连接。
阶段 2:云基础设施与容器精通(第 5 至 8 周)
将你的基础设施技能从基础云托管提升到企业级容器编排:
- 使用多阶段 Docker 构建将你现有的后端服务容器化。
- 使用 Minikube 或 k3s 搭建本地多节点 Kubernetes 集群。
- 编写 Helm charts,将环境配置、密钥引用和资源配额参数化。
- 学习企业级 VPC 路由、子网隔离和 TLS 证书管理的基础知识。
第 3 阶段:应用 AI 与 Agent 编排(第 9 至 12 周)
将应用人工智能融入你的系统工程工具箱:
- 掌握混合检索流水线、嵌入缓存和语义文档处理。
- 使用 LangGraph 或 PydanticAI 等框架构建多步骤状态机。
- 开发自定义评测套件,量化模型准确性、延迟和 token 开销。
第 4 阶段:生产级作品集构建(第 13 至 16 周)
构建、记录并发布你的两个旗舰作品集系统:
- 在采用开源许可证的公开 GitHub 仓库中编写整洁且经过充分测试的代码。
- 撰写详尽的 README 文件,说明系统架构、运维权衡和部署说明。
- 录制三分钟的视频演示,展示实时部署、错误处理和测试套件执行。
第 5 阶段:针对性投递与面试执行(第 17 至 20 周)
锁定招聘前沿部署工程师的公司,并为其独特的面试流程做好准备:
- 锁定企业级 AI 公司、基础模型实验室(OpenAI、Anthropic、Scale AI)和数据平台(Palantir、Databricks)。
- 调整你的简历,突出系统集成、生产部署和对客户的直接影响。
- 与工程同行一起练习实时问题拆解和利益相关者角色扮演场景。
- 通过阅读 为什么 AI 创业公司需要前沿部署工程师,了解推动企业招聘的商业动机,以转化复杂的试点项目。
攻克前沿部署工程师面试流程
前沿部署工程师职位的面试与标准大型科技公司的软件工程面试流程有很大不同。传统的软件工程面试高度侧重于抽象的 LeetCode 算法,而 FDE 面试流程则评估实际的系统构建能力和客户沟通能力。
企业科技公司通常将招聘流程分为五个不同的轮次:
第 1 轮:招聘人员与工程筛选(45 分钟)
初次交谈会评估你的技术背景以及从事面向客户工程的动机。面试官寻找的是真正乐于解决混乱的现实世界问题的候选人,而不是那些将客户工作视为对纯算法研究干扰的工程师。
第 2 轮:标志性拆解轮(60 分钟)
拆解轮(decomposition round)起源于 Palantir Technologies,是 FDE 候选人最具决定性的考核环节。面试官会给出一个高层次、模糊且没有明确技术规格的运营场景。
例如,面试官可能会问:你将如何为一家业务覆盖 40 个海港的全球物流承运商设计并部署一条自动化报关单据流水线。
要在这一轮中脱颖而出:
- 厘清约束条件: 就数据格式、网络可靠性、吞吐量和监管限制提出深入的问题。
- 定义系统里程碑: 将庞大的项目拆解为初始概念验证、试点部署和生产上线。
- 设计数据流水线架构: 规划数据摄取、校验边界、存储层级和模型推理服务。
- 处理边界情况: 说明你的系统如何应对网络断连、格式错误的报关清单以及人工异常审核。
第 3 轮:实战系统集成编码(60 分钟)
这场现场编码环节考察你在时间限制下编写实用、可上生产环境的软件的能力。面试不会让你实现二叉树遍历,而是要求你解析混乱的 JSON 载荷、实现带重试逻辑的 API 客户端,或用 Python 构建异步队列工作器。
面试官会评估代码整洁度、错误处理、类型注解和单元测试覆盖率。
第 4 轮:客户模拟与利益相关者演示(45 分钟)
这一行为面试环节考察你的情绪稳定性和顾问式沟通能力。面试官会扮演一位不满的企业利益相关者,其迁移项目被延误,或其安全团队标记了一个部署问题。
你将被评估以下能力:积极倾听、缓和紧张气氛、在不使用防御性行话的前提下解释技术权衡,以及提出建设性的后续步骤。
第 5 轮:系统架构与可扩展性(60 分钟)
最后一轮技术面试考察你对分布式云基础设施的理解。你将设计具备弹性与安全性的架构,能够处理多区域故障转移、企业 VPC 对等连接以及高并发模型推理。
Levels.fyi 工程师薪酬数据集中记录的行业薪酬基准表明,掌握这些综合性面试环节的候选人能够获得顶级工程师薪资。要打磨你在基础技术问题上的回答,请参阅我们专门整理的前沿部署工程师面试题解析。
关于成为 FDE 的常见问题
转型到前沿部署工程师岗位需要多长时间?
对于中级软件开发人员来说,转型为前沿部署工程师通常需要四到六个月的专注准备。已经具备扎实后端编程和容器化技能的候选人,可以通过构建应用 AI 作品集项目以及练习咨询式问题拆解面试来缩短这一时间。
应届毕业生能成为前沿部署工程师吗?
虽然少数大型科技公司会通过结构化的轮岗项目招聘初级 FDE,但绝大多数公司要求两到四年的专业软件工程经验。在客户基础设施中工作所需的自主性,使得先前的生产环境经验不可或缺。
前沿部署工程师最重要的编程语言是什么?
Python 是人工智能领域前沿部署工程师不可或缺的语言。它是基础模型 API、数据处理管道和 Agent 框架的主要生态系统。将 Python 与用于全栈集成的 TypeScript 以及用于高性能微服务的 Go 相结合,能带来理想的竞争优势。
FDE 面试与标准软件工程面试有何不同?
标准软件工程面试侧重于抽象的算法谜题、动态规划和孤立的数据结构。FDE 面试流程则优先考察实际的系统集成、现场调试、端到端数据管道构建,以及标志性的问题拆解环节——候选人需要在其中解决模糊的业务挑战。
什么是 FDE 面试中的标志性拆解环节?
拆解环节评估的是候选人将一个混乱、界定不清的企业业务问题,系统地拆分为结构化的工程里程碑、数据契约和架构组件的能力。它考察咨询式判断力、风险评估能力和务实的系统设计能力。
前沿部署工程师需要深厚的机器学习理论吗?
不需要,前沿部署工程师不需要深厚的机器学习理论、数学优化证明或深度神经网络训练方面的专业知识。FDE 专注于应用 AI,这意味着他们必须掌握模型编排、检索增强生成、工具调用协议、评测框架以及安全的基础设施部署。
如何在工程简历中展示咨询能力?
突出你与外部客户协作、主持技术需求调研会议、将模糊的产品需求转化为技术路线图,或培训客户开发人员的具体事例。在技术成就之外,强调业务影响,例如合同续约或节省的运营时间。
对于有志成为前沿部署工程师的人来说,最好的作品集项目有哪些?
最有效的作品集项目应展示端到端的生产工程能力:一个带模式校验和死信队列的企业数据集成适配器、一个带自动化评测指标的生产级多模态 RAG 系统,以及一个带基于角色访问控制的安全 Model Context Protocol 工具服务器。
总结与后续步骤
前沿部署工程师处于高层业务战略与动手软件构建这一至关重要的交汇点上。随着企业人工智能日趋成熟,组织不再需要泛泛的建议;他们需要的是能够深入其代码库、让复杂系统可靠运行的顶尖技术构建者。
通过系统地掌握系统工程、容器化云基础设施、应用 AI 流水线以及现场沟通,你将把自己置于现代技术职业的最前沿。
如果你已准备好将这份路线图付诸实践,并探索全球团队中的灵活机会,请查阅我们关于寻找高薪远程 AI 工程工作的实战指南。