前沿部署工程师面试全解析:问题、评分标准与问题分解指南
掌握前沿部署工程师面试全流程。为 Palantir 问题分解题、混乱代码库编程、现场系统设计以及角色扮演做好准备。
前沿部署类职位的技术面试考察的能力与标准软件工程面试不同。候选人不是在白板上解决抽象的算法优化问题,而是要理清混乱的企业级架构,并与苛刻的业务利益相关者沟通。
顶尖科技公司和人工智能创新企业会评估你处理模糊技术需求的能力。如果你即将参加前沿部署软件工程师面试,或正在研究 Palantir FDSE 面试问题,本指南将介绍成功所需的评分标准和策略。
有关日常工作职责和职业发展的全面概述,请阅读我们的前沿部署工程师综合指南。
核心要点 前沿部署工程面试流程用问题分解轮、混乱代码库导航和客户角色扮演模拟取代了纯算法谜题。掌握问题分解需要将模糊的企业问题拆解为五个结构层次:使命约束、用户画像、数据契约、核心服务和交付里程碑。集成编程评估考察你阅读无文档代码、处理脏数据格式以及实现健壮重试机制的能力。客户角色扮演轮考察你在面对持怀疑态度的高管发起人时的商业同理心、积极倾听和技术权威性。
1. 现代前沿部署工程师面试流程剖析
企业软件公司设计前沿部署面试流程,以评估候选人在技术深度和商业表现力两方面的能力。传统后端工程面试优先考察算法时间复杂度,而现场工程面试则优先考察生产环境实用主义和快速问题界定能力。
Palantir、Databricks、C3.ai 等公司以及企业级人工智能基础实验室会评估你在客户环境中直接构建生产级软件的能力。整个招聘流程通常包含五个综合评估阶段。
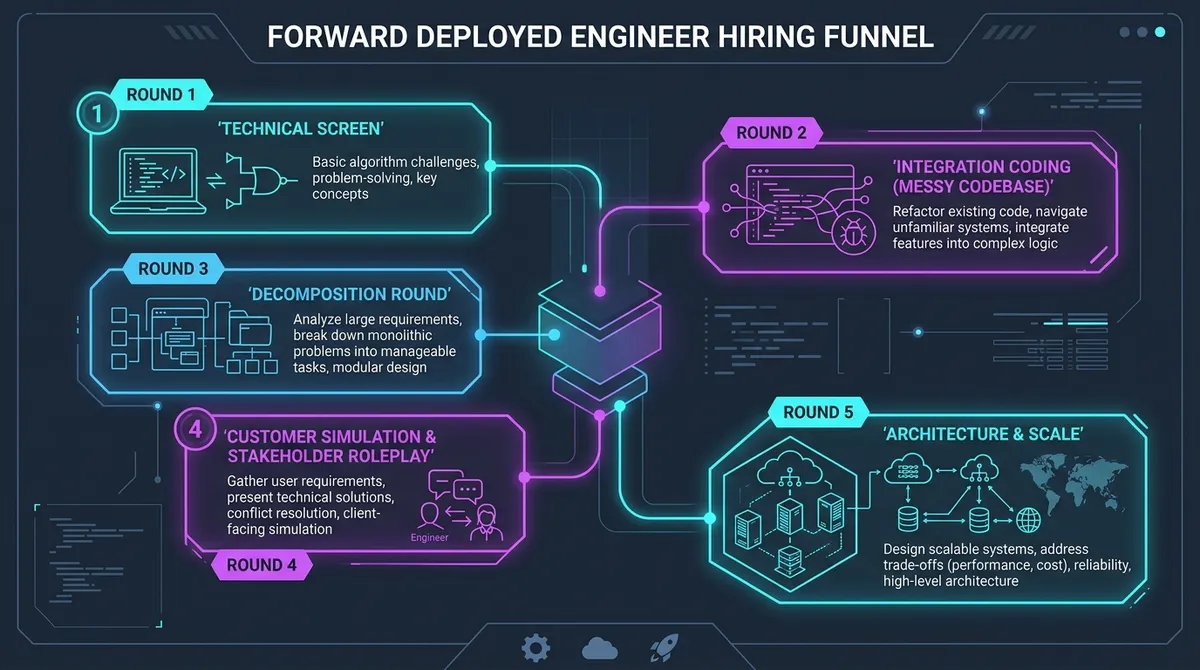 图 2:顶级企业级人工智能雇主端到端的面试流程结构。
了解每一轮面试的独特目标,能确保你在面试官的校准会议中突出他们所寻找的确切能力。如果你正在规划向现场工程的整体转型,请查阅我们详细的前沿部署工程师路线图与技能栈。
阶段 1:技术电话初筛(45 至 60 分钟)
技术初筛由一位资深工程师或工程经理主持。面试官会考察你的工程背景、生产环境调试事故的经历,以及此前接触企业客户部署的经验。
面试通常包含一个 30 分钟的实操现场编程练习。面试题不会要求你做图遍历或位运算,而是测试你处理 JSON 载荷、解析 CSV 数据流,或使用 Python、TypeScript 或 Go 转换嵌套数据结构的熟练程度。
第二阶段:集成与调试编程(60 至 90 分钟)
在这一轮中,你会获得一个陌生的、包含多个文件的代码仓库,它模拟了真实世界的企业代码库。该代码库刻意包含一些小 bug、未完成的 API 客户端集成、缺失的错误处理以及过时的文档。
你的任务是审查现有代码、定位失败的单元测试、实现一个新的功能端点,并添加防御性错误处理。面试官会评估你能否快速在陌生代码库中建立心智模型,而不被无关文件所干扰。
第三阶段:问题拆解轮(60 至 90 分钟)
这一轮最初由 Palantir 开创,如今已成为前沿部署工程招聘的标志性环节。你会收到一个刻意设置得宽泛、定义模糊的运营挑战,它来自某个真实组织。
面试官期望你主导对话。你必须提出澄清性问题、识别业务约束、区分数据的生产方与消费方,并从零构建一个模块化的技术架构。
第四阶段:客户模拟与利益相关者角色扮演(45 至 60 分钟)
在这场行为模拟中,面试官会扮演客户方的利益相关者,例如持怀疑态度的首席信息官、压力很大的数据库管理员,或非技术背景的产品经理。
场景涉及一个真实的运营摩擦点,例如意外的生产环境宕机,或一个无法满足的安全要求。面试官会评估你的积极倾听、专业的冲突化解、清晰的权衡协商能力,以及在不显得居高临下的前提下解释复杂技术约束的能力。
第五阶段:现场系统设计与企业架构(60 分钟)
标准的系统设计轮聚焦于拥有数十亿日活用户的消费级规模,而现场系统设计则聚焦于企业级复杂性。题目涉及多地区合规、严格的数据治理、本地部署的虚拟私有云、网络物理隔离以及批量数据同步。
面试官会考察你对 SAML 和 OpenID Connect 等企业认证协议、事件队列、数据库联邦以及零外联网络拓扑的熟悉程度。
| 维度 | 标准软件工程师(SDE) | 前沿部署工程师(FDE) | 解决方案架构师(SA) |
|---|---|---|---|
| 核心编程指标 | 算法效率与 Big-O 复杂度 | 务实的代码集成、重构与数据处理 | 高层脚本、示例代码与原型粘合 |
| 系统设计重点 | 消费级规模、高吞吐量、分片 | 企业治理、安全边界与物理隔离 | 参考架构与云厂商服务 |
| 核心问题解决 | 范围明确的工程任务单 | 模糊的运营问题分解 | 将产品功能转化为业务能力 |
| 利益相关者接触面 | 内部团队与产品经理 | 外部高管、现场团队与客户工程师 | 客户企业架构师与采购团队 |
| 考核核心 | 算法数据结构与谜题 | 分解环节与混乱代码库集成 | 架构演示与需求发现研讨会 |
2. 掌握分解环节(Palantir 标志性面试)
分解面试考察的是工程师如何应对极端的模糊性。在实际生产中,客户很少会向前沿部署团队提供清晰的工程规格说明。相反,他们提出的是宽泛的运营痛点,例如供应链延迟或医疗记录碎片化。
在分解面试中,你不需要编写代码。相反,你要扮演主持企业需求发现研讨会的首席技术架构师。你的目标是将一个混乱的运营需求拆解为清晰、可组合的技术组件。
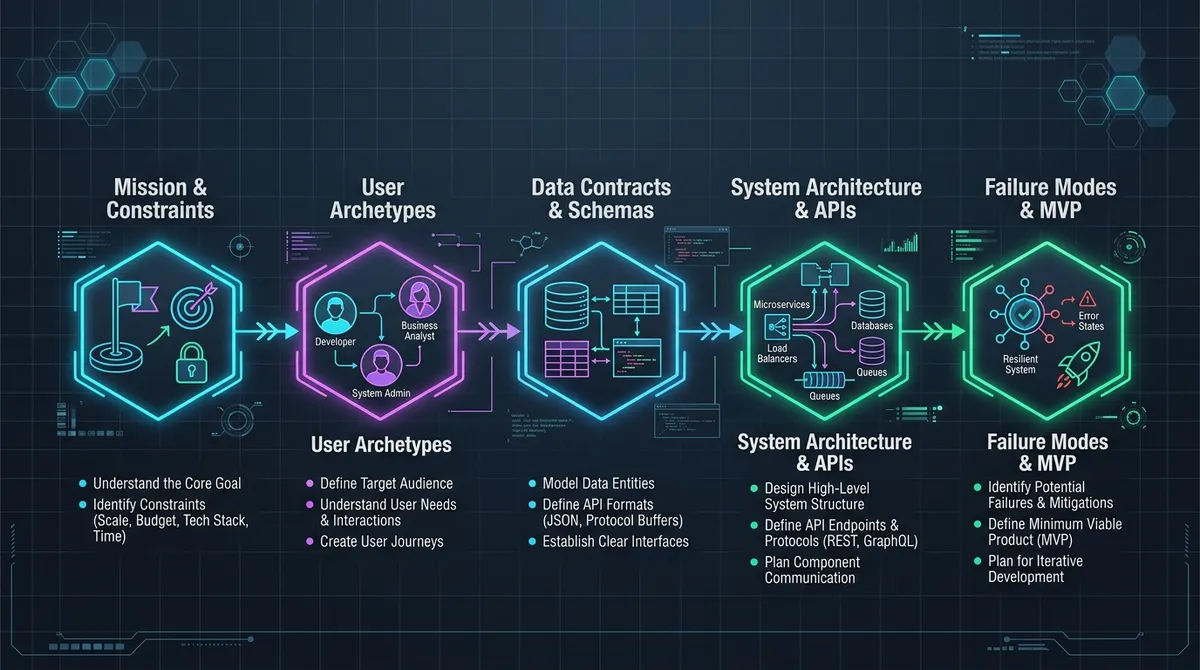 图 1:面向技术现场工程面试的五阶段问题分解框架。
想了解这种咨询式思维与纯技术售前的区别,请查看我们的前沿部署工程师 vs 解决方案架构师 vs 售前工程师对比。
五阶段问题分解框架
面对模糊的场景时,切勿直接跳到技术选型或数据库选择。请遵循这个结构化的五阶段框架,以展示系统化的工程成熟度。
阶段 1:使命与运营约束
在接触技术之前,先明确核心业务成果。针对交付时间线、监管边界、数据分类级别和系统正常运行时间目标提出有针对性的问题。确定哪些指标定义项目成功。
阶段 2:用户原型与访问边界
梳理谁将与系统交互。区分数据贡献者、高管决策者、外部审计员和管理操作员。为每类角色定义权限、界面需求和延迟预期。
阶段 3:数据契约、模式与数据摄取路径
确定源数据的来源及其如何进入系统。判断数据源是实时流式传输,还是通过定期批处理文件导出。定义实体关系、唯一标识符、数据保留策略和模式校验规则。
阶段 4:系统架构与 API 边界
勾勒处理流水线、消息中间件、应用微服务和存储层。在组件之间建立清晰的 API 契约,使工程团队能够独立并行开发各模块。
阶段 5:故障模式、边缘情况与最小可行产品(MVP)
识别生产环境中可能出问题的地方。分析系统如何应对间歇性网络连接、损坏的记录、速率限制和局部故障。最后,规划一个分阶段的部署策略,在数周而非数月内交付初始客户价值。
分步演练:全球物流分解提示词
要看这个框架的实际运用,可以看一个经典的企业分解提示词:
提示词:“一家全球海运企业运营着 450 艘货轮,航行于国际贸易航线。该公司面临燃油消耗预测不准确、发动机意外故障以及海关单证延误等问题。请设计一个自动化船队健康监控与预测性航线平台。”
下面是一位出色的候选人如何按照五个框架阶段来分解这一挑战:
第 1 步:界定约束条件与使命目标
首先提出有针对性的澄清问题:
- 连接性:“这些船上的卫星上行链路可用性如何?连接是持续的,还是高延迟、高丢包的间歇性连接?”(面试官:船只配备低带宽卫星链路,每天会中断数小时)。
- 遥测频率:“目前安装了哪些传感器,它们以什么频率发送读数?”(面试官:每台发动机每 5 秒发送一次温度、压力和转速遥测数据)。
- 成功标准:“试点部署的首要运营目标是什么?”(面试官:将计划外发动机停机减少 15%,并在船只到港前 24 小时自动生成海关舱单)。
第 2 步:用户原型与用户画像
识别核心运营用户:
- 船舶轮机长:需要在船上使用离线优先的仪表盘,在不依赖云连接的情况下查看即时发动机健康警报。
- 港口运营协调员:需要提前 24 小时获得准确的预计到达时间和预先清关的海关单证,以便安排吊机操作员和码头工人。
- 船队技术总监:需要对比各航线船舶效率的全球分析数据,以谈判批量燃油合同。
第 3 步:数据契约与存储模式
构建核心数据实体和摄取流水线:
- Telemetry Event Contract: Define a compact binary protocol or compressed JSON schema for sensor events:
- vessel_id(UUID)、timestamp(UTC 时间戳)、engine_subsystem(字符串)、metric_type(枚举)、metric_value(浮点数)、checksum(字符串)。
- 边缘存储与云端存储对比: 使用嵌入式时序数据库,将原始的 5 秒级指标数据存储在船舶工业 PC 本地。在排队等待卫星传输之前,将遥测数据聚合为 5 分钟滚动平均值和异常标志。
- 数据去重: 实现幂等的消息序列号,确保断线重连时不会产生重复的遥测记录。
第 4 步:系统架构与数据流
概述端到端处理流水线:
- 边缘节点(船上本地部署): 本地传感器采集器将数据输入嵌入式消息队列。本地推理容器根据预先训练的异常阈值评估实时振动特征。
- 同步网关: 双向同步代理监控卫星链路质量。当连接建立时,它通过双向 TLS 将压缩后的遥测增量数据批量上传。
- 云端摄取引擎: API 网关将传入的船舶数据批次路由到事件流主题。遥测数据流入云端数据湖,用于全船队范围的模型训练。
- 海关文件生成器: 文档组装服务监控船舶地理围栏。当船舶距离港口 200 海里以内时,该服务将货物舱单和提单汇编为标准化的海关格式。
第 5 步:故障模式与 MVP 交付计划
强调边缘情况和分阶段上线计划:
- 网络分区: 确保在卫星通信中断期间船舶运营可以无限期持续。当存储接近容量上限时,队列必须将遥测数据缓冲到本地磁盘,并遵循明确的 FIFO 淘汰策略。
- 传感器漂移与误报: 在向船员发出警报之前,实现滚动中位数平滑处理,以消除瞬时的电气噪声尖峰。
- 试点交付里程碑: 在 6 周内交付初始 MVP,先为 5 艘高流量船舶配备只读边缘仪表盘和自动化云端邮件告警,再构建复杂的预测性航线模型。
3. 集成编码:在遗留代码和不熟悉的代码库中工作
前沿部署工程师会花费大量时间处理缺乏文档、包含技术债务、并与脆弱的企业 API 集成的客户代码库。因此,现场编码环节重点考察代码阅读理解能力、错误处理能力和集成模式。
在这项评估中,你会得到一个包含多个相互关联文件的现有代码仓库。你需要快速掌握数据流,编写简洁的适配器逻辑,校验入站数据模式,并构建容错的网络重试机制。
标准协议和接口是企业集成的核心。如果你在构建现代 AI Agent 连接器,研读 Model Context Protocol 服务器规范 能为你打下现代集成范式的坚实基础。
企业数据接入适配器代码示例
以下可执行的 Python 实现展示了 FDE 集成环节所期望的代码质量。它使用 Pydantic 实现防御性模式校验,采用带抖动的指数退避重试,并为无法处理的企业数据载荷提供死信队列路由。
"""
Enterprise Ingestion Adapter with Schema Validation, Retries, and Dead-Letter Queue.
Demonstrates production-grade resilience patterns required in FDE coding interviews.
"""

from typing import Dict, Any, List, Optional
import time
import random
import logging
from pydantic import BaseModel, Field, ValidationError

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")
logger = logging.getLogger("EnterpriseAdapter")


class EnterpriseTelemetryRecord(BaseModel):
    """Defines strict schema validation for incoming client telemetry records."""
    record_id: str = Field(..., min_length=5, description="Unique client transaction identifier")
    organization_id: str = Field(..., min_length=3)
    metric_value: float = Field(..., ge=0.0, le=10000.0)
    status_code: str = Field(..., pattern=r"^(ACTIVE|DEGRADED|OFFLINE)$")
    timestamp_epoch: int = Field(..., gt=1577836800)  # Valid unix timestamp check


class MockUpstreamClientError(Exception):
    """Raised when upstream enterprise service experiences a transient network fault."""
    pass


class IngestionPipeline:
    """Manages parsing, validation, retries, and dead-letter queuing."""

    def __init__(self, max_retries: int = 3, base_backoff_sec: float = 0.5):
        self.max_retries = max_retries
        self.base_backoff_sec = base_backoff_sec
        self.dead_letter_queue: List[Dict[str, Any]] = []
        self.processed_records: List[EnterpriseTelemetryRecord] = []

    def validate_raw_payload(self, raw_data: Dict[str, Any]) -> Optional[EnterpriseTelemetryRecord]:
        """Validates payload against schema contract, isolating malformed records."""
        try:
            return EnterpriseTelemetryRecord(**raw_data)
        except ValidationError as err:
            logger.warning("Validation failed for record %s: %s", raw_data.get("record_id", "UNKNOWN"), err.errors())
            self._route_to_dead_letter(raw_data, reason=f"ValidationError: {str(err)}")
            return None

    def _route_to_dead_letter(self, payload: Dict[str, Any], reason: str) -> None:
        """Stores unprocessable payloads with diagnostic metadata for manual replay."""
        dead_record = {
            "payload": payload,
            "failed_at": time.time(),
            "reason": reason
        }
        self.dead_letter_queue.append(dead_record)
        logger.error("Payload routed to Dead-Letter Queue. Total DLQ count: %d", len(self.dead_letter_queue))

    def dispatch_to_upstream(self, record: EnterpriseTelemetryRecord) -> bool:
        """Simulates network dispatch to an upstream enterprise system with intermittent failures."""
        for attempt in range(1, self.max_retries + 1):
            try:
                # Simulate 30% transient network failure rate
                if random.random() < 0.30:
                    raise MockUpstreamClientError("503 Service Unavailable: Network socket timeout")

                logger.info("Successfully dispatched record %s on attempt %d", record.record_id, attempt)
                return True

            except MockUpstreamClientError as exc:
                if attempt == self.max_retries:
                    logger.error("Exhausted all %d retries for record %s", self.max_retries, record.record_id)
                    self._route_to_dead_letter(record.model_dump(), reason=str(exc))
                    return False

                # Full jitter exponential backoff calculation
                sleep_duration = self.base_backoff_sec * (2 ** (attempt - 1)) + random.uniform(0, 0.1)
                logger.warning("Attempt %d failed. Retrying in %.2f seconds...", attempt, sleep_duration)
                time.sleep(sleep_duration)

        return False

    def ingest_batch(self, batch: List[Dict[str, Any]]) -> Dict[str, int]:
        """Processes an incoming enterprise batch, tracking overall system metrics."""
        summary = {"processed": 0, "failed_validation": 0, "failed_dispatch": 0}

        for item in batch:
            record = self.validate_raw_payload(item)
            if not record:
                summary["failed_validation"] += 1
                continue

            success = self.dispatch_to_upstream(record)
            if success:
                self.processed_records.append(record)
                summary["processed"] += 1
            else:
                summary["failed_dispatch"] += 1

        return summary


# Demonstration run
if __name__ == "__main__":
    sample_records = [
        {"record_id": "REC-1001", "organization_id": "ORG-ALPHA", "metric_value": 45.2, "status_code": "ACTIVE", "timestamp_epoch": 1740000000},
        {"record_id": "REC-1002", "organization_id": "ORG-BETA", "metric_value": -12.0, "status_code": "INVALID", "timestamp_epoch": 1740000000},  # Schema Failure
        {"record_id": "REC-1003", "organization_id": "ORG-GAMMA", "metric_value": 182.9, "status_code": "DEGRADED", "timestamp_epoch": 1740000000},
    ]

    pipeline = IngestionPipeline(max_retries=2, base_backoff_sec=0.1)
    results = pipeline.ingest_batch(sample_records)
    print("\nIngestion Results:", results)
面试官在集成环节中关注什么
- 系统性调试而非反复试错: 当单元测试失败时,你是仔细阅读堆栈跟踪并追踪变量状态,还是随意改动代码行,指望测试通过?
- 防御性编程标准: 你是否校验外部输入、优雅地处理缺失的字典键,并清理意外的空值?
- 清晰的代码组织: 你是否将业务逻辑与数据访问和网络传输分离?干净的抽象表明你能够管理大规模代码库。
- 测试覆盖意识: 在告诉面试官你完成之前,你是否编写了覆盖边界条件、网络超时和畸形输入的单元测试?
4. 现场系统设计 vs. 大厂系统设计
具有消费互联网系统设计面试经验的候选人,在现场系统设计面试中常常感到吃力。标准的大厂面试强调横向扩展、全球缓存层级以及每秒处理数百万次查询。
相比之下,企业现场系统设计更注重治理、组织复杂性和多租户安全边界。前沿部署系统通常需要在严格的监管标准下运行,例如 HIPAA、FedRAMP 或 SOC 2 Type II 合规。
在设计企业级流水线时,保障模型交互和数据流水线的安全至关重要。请查阅我们关于 企业 AI Agent 安全最佳实践 的综合指南,深入了解架构模式。
企业设计 vs. 消费者设计对比
| 评估指标 | 消费互联网系统设计 | 企业现场系统设计 |
|---|---|---|
| 主要瓶颈 | 原始网络吞吐量和数据量 | 数据治理、数据孤岛和合规隔离 |
| 数据拓扑 | 统一的多区域云数据湖 | 混合本地部署、多云和物理隔离的 VPC |
| 身份验证 | OAuth2、会话令牌、社交登录 | SAML 2.0、Okta、Active Directory 和 Kerberos |
| 数据一致性 | 最终一致性、异步传播 | 强 ACID 事务、审计日志和血缘追踪 |
| 部署模式 | 中心化多租户 SaaS | 单租户客户 VPC 和本地部署集群 |
| 集成接口 | REST 和 GraphQL API | 旧版 SOAP、大型机队列、ODBC 和平面文件投递 |
实战现场提示:物理隔离的金融 LLM 检索系统
提示词:“一家全球投资银行需要一个本地部署的检索系统,用于查询内部研究备忘录、投资组合交易和合规记录。该系统不得产生任何出站互联网流量,必须与现有的 Active Directory 角色层级集成,并且必须为每份生成的摘要提供可验证的文档溯源。”
要给出顶尖的回答,请将你的架构蓝图按以下四个核心层面组织:
| 步骤 | 工作流 / 架构阶段 |
|---|---|
| 1 | [ Active Directory / LDAP 身份提供方 ] |
| 2 | (双向 TLS / SAML 断言) |
| 3 | [ 企业 API 网关与策略执行点 ] |
| 4 | [ 检索与排序引擎 ] [ 文档摄取工作器 ] |
| 5 | [ 本地向量数据库 ] [ 文档存储 ] [ 本地 LLM 推理 ] |
| 6 | (行级安全) (静态加密) (vLLM / Triton 服务器) |
| 7 | [ 仅追加审计账本 ] |
1. 身份、访问与行级安全
系统不得存储独立的凭据。通过 SAML 2.0 或 Kerberos 将 API 网关连接到银行的 Active Directory。
在检索层实现基于属性的访问控制(ABAC)过滤器。当用户执行查询时,向量搜索引擎会根据用户的安全许可标签、团队标识符和地区管辖范围对向量嵌入进行过滤。伦敦的初级分析师绝不能收到来自纽约财富管理投资组合的文档片段。
2. 物理隔离的文档处理管道
文档摄取完全在银行的私有子网内运行。文档解析器从加密的 PDF、DOCX 和彭博终端导出文件中提取文本。
文本块传递给在容器化集群内运行的本地嵌入服务。嵌入存储在具有加密持久卷的本地向量数据库中。零遥测数据、崩溃报告或向量嵌入离开边界。
3. 本地推理与溯源生成
使用 vLLM 或 NVIDIA Triton 等优化的推理引擎,在专用的本地 GPU 节点上托管自托管的开源权重模型。候选人可以查看 vLLM 开源推理引擎仓库 以了解生产级服务架构。
检索引擎将相关文档摘录连同确定性的引用标注一起注入提示词模板。模型响应必须包含指向源文档 ID、页码和段落偏移的直接指针,以便合规团队可以手动核实陈述。
4. 密码学审计与出站验证
所有提示词输入、检索到的文档片段、系统提示词和模型补全都写入一个只可追加、具备防篡改特性的审计数据库。网络安全规则在 Kubernetes 网络策略层阻止出站流量,确保数据完全被隔离在内。
5. 客户模拟与利益相关者角色扮演环节
客户模拟环节考察的是情商、压力下的沉着冷静以及商业直觉。面试官想看到的是,当你面对沮丧的、非技术背景的、或维护自己组织地盘的客户时,你会如何表现。
在准备期间构建切实的案例研究和客户项目,能让你拥有真实的故事可以引用。如果你想扩展自己的技术演示,可以探索这些面向求职的 AI 工程作品集项目。
以下是三个常见的客户角色扮演场景,详细说明面试官在考察什么,以及如何组织你的回答。
场景 A:戒备心强的副总裁
情境:“你正在与一家企业保险客户进行现场启动会议。数据工程副总裁打断你的演示,说道:‘我们已经有 40 名工程师在构建内部分析平台。为什么领导层要花数百万美元请你们来做我的团队已经在做的事情?’”
面试官在考察什么
面试官在寻找戒备、居高临下或尴尬迎合的表现。经验不足的工程师往往会反驳说自己的软件更优越,这会立刻疏远一位有影响力的内部利益相关者。
示范性回答策略
- 认可并缓和局势:承认这位副总裁的专业能力,以及其内部工程团队所完成的大量工作。
- 重新定义关系:澄清你不是来取代他们的团队或与内部项目竞争的。你是来提供一个加速器,消除底层的繁琐管道工作。
- 提出协作对齐方案:提议一种合作模式,由内部工程师保留核心数据模式的所有权,而你负责复杂的管道同步。
示例逐字回答:“这个顾虑完全合理。自建内部平台能让您的团队获得完全的架构控制权,而四十名工程师的投入也体现了贵司对数据基础设施现代化的巨大承诺。我们的目标从来不是取代或重建您的工程师所创造的成果。在我们以往的部署中,内部团队在冲刺周期中有多达 70% 的时间用于编写重复性的数据连接器以及应对供应商 API 格式变更。我们将我们的平台视为您工程师的效率倍增器。我们接管底层的连接器维护和气隙部署的繁琐工作,让您的工程师能够专注于专有风险模型和客户分析。我很期待今天下午能与贵司的首席架构师坐下来,一起审视你们的路线图,确保我们构建的一切都能直接契合贵司的架构愿景。”
情景 B:范围蔓延与时间线不一致
情境:“在一个为期四周的部署试点进行到第二周时,客户项目发起人坚持要为三个新的遗留支付渠道增加实时欺诈评分功能。他们警告说,如果不包含这些渠道,他们将无法建议高管续签合同。”
面试官在考察什么
面试官想看的是,你究竟是会做出危及项目交付的不切实际的承诺,还是会变得僵化、轻视对方,从而损害商业关系。
示范性回答策略
- 对业务驱动因素表达共情:理解新需求为何对他们的高管利益相关者如此重要。
- 清晰地沟通技术权衡:说明增加复杂的遗留系统集成会如何立即影响已商定的交付日期。
- 提供可执行的阶段性解决方案:在保护核心试点里程碑的同时,为新范围创建一条有据可查的路径。
示例逐字回答:“我完全理解为什么这三个渠道的实时欺诈评分对高管审批至关重要。欺诈防范正是贵司能够立即获得财务回报的领域。看看我们剩下的两周时间,集成那三个遗留渠道需要编写自定义适配器并验证交易吞吐量。如果我们将这些渠道加入当前冲刺,我们将错过主欺诈检测管线的生产上线截止日期,导致所有渠道都未经验证。我的建议是:我们保持下周五主支付管线的原定生产截止日期,让贵司高管看到经过验证的实时结果。与此同时,我明天会花时间梳理那三个遗留渠道的架构(schema)需求,并起草集成蓝图作为第二阶段。这样,您下周就能向领导层展示具体的指标,同时还有一份明确的遗留系统全覆盖路线图。”
情景 C:现场演示期间出现生产环境 Bug
情境:“你正在一个坐满客户董事的会议室里进行平台现场演示。演示进行到一半时,数据管道崩溃了,仪表盘显示 HTTP 500 内部服务器错误。”
面试官在考察什么
面试官想看你是否会僵住、慌乱、把责任推给客户的网络基础设施,或者在领导层面前失去镇定。
示范性回答策略
- 保持镇定: 绝不责怪客户的 WiFi,也不试图掩盖故障。
- 透明排查: 冷静说明发生了什么,快速进行诊断,如果无法立即解决,就平稳地切换方案。
- 展示系统化的根因分析: 表明你以严谨的工程纪律对待技术问题。
示范回答原文:“看起来我们的数据摄取服务刚刚抛出了一个内部服务器错误。线上软件部署总会带来意外,让我们一起来看看。检查我们的应用日志流后,发现是两分钟前发送的测试批次中某个空的税号字段触发了校验异常。这是我们的预发布环境解析器没有覆盖到的边缘情况。与其让大家在大屏幕上看我调试代码,我准备切换到我们的备用预发布集群,那里已经运行着预先计算好的校验结果。这样我们就能继续完成对决策分析的评审。本次会议结束后,我会立即修复该解析器的校验逻辑,并将事后日志分享给你们的工程团队。”
6. 前沿部署工程师面试 15 个高频问题及参考答案
备战前沿部署工程师面试,需要在练习技术深度的同时兼顾简洁的表达。以下是 15 个常见的面试问题,按四个关键考察维度分类整理。
类别 A:系统、集成与数据架构
问题 1:在从第三方企业数据库消费数据时,你如何应对 schema 漂移?
- 面试意图: 考察你的防御性工程实践,以及对那些会毫无预警更新 schema 的上游客户系统的熟悉程度。
- 关键能力: Schema 注册中心、向后兼容性、死信队列以及自动化告警。
- 参考答案:“处理模式漂移需要将外部企业系统视为不可信的数据生产方。我使用 Pydantic 模型或 Protocol Buffers 等契约定义来实现严格的校验边界。当传入记录包含无法识别的字段时,摄取层会记录该差异,但如果必填字段匹配,则继续处理。如果缺少必填字段或数据类型不匹配,该记录会连同原始载荷和解析堆栈跟踪一起被送入死信队列。这样可以防止单条损坏的记录中断整个批处理管道。关键在于,自动化告警会同时通知我们的现场团队和客户数据库管理员,使我们能够在不丢失数据的情况下检查新的模式版本并更新校验规则。”
问题 2:在连接位于物理隔离、无互联网的零信任网络中的客户数据库时,你会采用哪些策略?
- 考察意图: 测试你在国防、银行或医疗合规边界方面的实际经验。
- 核心能力: 堡垒跳板机、双向 TLS、VPN 隧道、容器物理隔离以及离线包管理。
- 参考答案:“在物理隔离网络中运行,需要将依赖项与公共软件包仓库解耦。所有应用容器、第三方库和机器学习模型都会预先打包为经过签名的 tarball 归档文件,并在通过安全数据单向网闸或物理隔离边界传输之前进行漏洞扫描。在网络内部,各服务在隔离的虚拟私有云中通过双向 TLS 通信,使用本地 DNS 和本地容器镜像仓库。数据库连接使用由客户内部目录服务配置的专用服务账户。遥测数据和审计轨迹会持久化存储到本地的只追加日志收集器中,而不是尝试对外输出。”
问题 3:当客户数据库表包含 2 亿行数据,且在繁重的分析查询下出现锁表时,你会如何优化 ELT/ETL 管道?
- 考察意图: 检查数据库性能调优能力,以及对生产环境操作对客户在线系统影响的理解。
- 核心能力: 变更数据捕获(CDC)、只读副本、索引分块以及数据库锁。
- 参考答案:“直接在活跃的事务型数据库上执行大范围分析查询,可能导致表锁并影响客户的生产工作负载。首先,我会确认是否有只读副本或备用实例可用于分析查询。如果必须从主表提取数据,我会避免无边界查询。相反,我会使用 Debezium 等工具实现基于日志的变更数据捕获(CDC),异步流式读取事务日志,而无需锁定应用表。如果日志访问受客户安全策略限制,我会在业务低峰时段以确定性的、基于索引的批次提取数据,利用带索引的时间戳范围并设置明确的查询休眠间隔,将数据库 CPU 使用率控制在约定的阈值以下。”
问题 4:如何设计一个 API 客户端,以应对上游激进的速率限制和间歇性的 502/503 错误?
- 面试意图: 考察对网络故障恢复和企业级网关限制的理解。
- 关键能力: 指数退避、抖动、熔断器和幂等键。
- 参考答案:“一个有韧性的 API 客户端必须同时保护上游服务器和下游消费者。我会实现指数退避重试机制,并结合完全抖动(full jitter),以防止服务器恢复期间出现惊群效应。每个变更类请求都包含唯一的幂等键,确保重试断开的连接不会导致重复事务。此外,我会实现客户端熔断器。如果连续的 502 或 503 错误超出预定义的错误预算,熔断器将跳闸打开,立即将传入请求路由到备用缓存或队列,而不会继续冲击故障中的上游服务。一旦上游恢复稳定,半开状态的健康探测会确认恢复情况,然后才恢复全部流量。”
类别 B:问题拆解与范围界定
问题 5:一位客户高管要求你“实施 AI 来自动化我们的保险理赔核保”。在第一周,你会如何界定这个项目的范围?
- 面试意图: 评估你拒绝宽泛、堆砌流行语的需求,并深入挖掘可衡量的业务流程的能力。
- 关键能力: 业务流程梳理、KPI 定义、风险缓解和可行性评估。
- 参考回答:“我首先会把‘理赔核保’分解为不同的操作性子任务,而不是把它当作一个整体式的自动化项目。第一周,我会跟随人工核保员观察,梳理他们的日常工作流程:文档分类、数据提取、保单核验、欺诈检查和风险评分。接下来,我会找出造成最高运营摩擦的瓶颈。如果核保员60%的时间都花在手动录入医疗账单上,那么自动化数据提取就能带来立竿见影的投资回报,且监管风险较低。相比之下,完全自动化最终的理赔审批决定会带来重大的法律责任。我会把MVP的范围严格限定在自动化文档索引和风险因素提取上,让人工核保员保留在最终审批环节。我们用具体的KPI来衡量成功:核保员处理每笔理赔的时间以及提取错误率。”
问题6:你如何判断一个企业客户的问题需要机器学习模型,还是需要确定性规则引擎?
- 面试意图:判断候选人是工程实用主义者,还是那种把复杂AI硬套在简单问题上的人。
- 核心能力:算法权衡、可解释性、可维护性和运营开销。
- 参考回答:“我遵循简约原则:从满足运营约束的最简单、可维护的方案开始。如果问题空间受严格的监管合规、刚性的法律要求或确定性算术支配,例如税务计算或合规资格判定,那么确定性规则引擎更优。规则引擎提供完全的可审计性、零幻觉,并且无需重新训练周期即可立即更新。当输入数据是非结构化的,例如自由格式的客户邮件、手写表单或对话记录,确定性正则表达式无法捕捉上下文时,机器学习或LLM才变得合适。即便在这些场景中,我也常常将两者结合:先用ML模型从原始输入中提取结构化实体,再用确定性规则引擎来执行合规和业务策略。”
问题7:你到达客户部署现场,发现他们的历史数据不完整、未建立索引,并且散落在15个Excel表格中。你会如何推进?
- 面试意图:考察应变能力、务实的数据工程能力,以及在一线应对混乱数据现实的管理能力。
- 核心能力:数据剖析、模式规范化、客户沟通和迭代交付。
- 参考答案:“这种情况在现场工程中很常见。我不会暂停部署去要求客户提供干净的数据,而是启动一次快速的数据画像冲刺。我编写自动化解析脚本,检查各电子表格中列命名差异、重复记录、缺失值以及日期格式不一致的问题。然后我设计一个规范化的目标架构,代表我们应用所需的最低可行数据模型。我将这些画像结果呈现给客户的业务分析师,通过具体的数据冲突示例逐一讲解,就数据对账规则达成一致。规则确定后,我会构建一个自动化的数据摄取管道,将电子表格数据清洗并加载到我们的结构化数据库中,同时生成异常日志,记录需要客户人工澄清的记录。”
问题 8:当同一客户的两位高管利益相关者在技术优先级上截然对立时,你如何对功能需求进行优先级排序?
- 面试意图:考察组织政治敏锐度、冲突解决能力以及需求优先级排序能力。
- 核心能力:利益相关者对齐、客观评分矩阵以及商业意识。
- 参考答案:“当高管优先级发生冲突时,试图基于主观意见进行谈判会损害关系。我会将讨论锚定在项目工作说明书中签署的总体商业目标上。我构建一个透明的优先级矩阵,依据三项客观标准对两组功能进行评分:对项目核心 KPI 的直接业务影响、当前部署时间线内的技术可行性,以及实施风险。随后,我会主持一次双方利益相关者共同参与的对齐会议,客观地阐述技术权衡,说明优先开发功能 A 会如何影响功能 B 的时间线。如果两个功能确实都不可或缺,我会提出一个分阶段交付路线图,在连续的发布里程碑中交付两个需求的核心组件。”
类别 C:应用 AI、大语言模型与生产系统
问题 9:你如何在企业级生成式 AI 应用中预防和检测幻觉?
- 面试意图:评估你在现代大语言模型架构、提示词工程和防护机制方面的技术深度。
- 核心能力:检索增强生成(RAG)、接地、语义评测以及引用验证。
- 参考答案:“防止幻觉需要结构性的架构控制,而不能仅依赖系统提示词指令。第一,我使用检索增强生成(RAG)来约束模型的生成范围,配合高质量的文本分块以及结合稠密向量与稀疏 BM25 关键词匹配的混合检索。第二,我在系统提示词中强制规定模型只能基于提供的上下文片段作答,并明确指示其在无法验证答案时返回‘信息不足’标记。第三,我实现自动化的生成后防护机制。由独立的校验检查确认生成输出中的每一条陈述都能直接对应到源文档中的引用偏移位置。最后,我们使用自动化评测框架,在生产日志中持续跟踪忠实度与答案相关性得分。”
问题 10:在客户 VPC 中部署多模态模型时,你如何处理冷启动延迟和吞吐量瓶颈?
- 考察意图: 检查 GPU 资源优化、模型服务架构以及延迟分析能力。
- 关键能力: 模型量化、投机解码、连续批处理以及 vLLM。
- 参考答案:“在客户 VPC 中优化模型服务,需要将模型架构与可用的硬件约束相匹配。为了最小化冷启动延迟,我使用 AWQ 或 GPTQ 等模型量化技术,将内存占用从 16 位精度降至 4 位或 8 位,使模型权重能够轻松装入可用的 GPU 显存,同时不会造成明显的精度损失。为了优化吞吐量,我部署 vLLM 等现代推理服务器,它们具备 PagedAttention 特性,可以消除内存碎片并支持连续批处理。如果应用需要高并发的交互式响应,我会将操作解耦:用一个紧凑、低延迟的模型提供即时对话反馈,同时将后台任务异步流式传输给更大的模型处理。”
问题 11:在没有标注基准数据的情况下,你如何在生产环境中评估 RAG 流水线的质量?
- 考察意图: 测试对不断演进的生产环境中 LLM 评测指标的理解。
- 关键能力: Ragas 指标、LLM-as-a-judge、用户反馈信号以及语义漂移。
- 参考答案:“在没有标注真实数据集的情况下,我会结合使用自动化的 LLM-as-a-judge 框架和隐性的用户遥测数据。在自动化评测方面,我会衡量 RAG 三角形的三个核心指标:上下文相关性、忠实度和答案相关性。上下文相关性衡量检索到的内容块是否与用户查询匹配。忠实度衡量生成的答案能否从上下文中逻辑推导出来。答案相关性验证补全内容是否直接回应了原始提示。在真实世界的用户信号方面,我会跟踪遥测数据,包括复制到剪贴板的操作、用户修改生成草稿时的编辑距离,以及明确的点赞/点踩评分。忠实度得分下降会触发对检索分块边界的自动审查。”
D 类:干系人管理、行为与文化契合度
问题 12:请描述一个因客户延误导致部署截止日期面临风险的场景。你是如何处理的?
- 面试意图: 考察责任担当、沟通透明度以及主动的风险缓解能力。
- 关键能力: 项目治理、主动沟通、RAID 日志以及同理心。
- 参考答案:“在一次企业部署中,我们的团队被阻塞了,因为客户的信息安全团队在项目开始三周后仍未配置我们的 VPN 凭证。被动等待会导致我们错过面向高管董事会的演示。我采取了主动行动:与其发送充满抱怨的邮件,我安排了一次与客户项目负责人和安全主管的 15 分钟简报会。我使用清晰的依赖关系跟踪表讲解了我们的部署时间线,展示凭证每延误一天,我们的上线里程碑就会推迟 24 小时。为了立即解除阻塞,我提出了一个折中方案:我们开始在一个隔离的本地预发布沙箱中编写和测试集成管道,使用按照客户 schema 生成的合成数据。十天后凭证确认到位时,我们预先测试好的适配器顺利连接成功,使我们如期完成了演示。”
问题 13:你如何向一位非技术背景的首席财务官解释一个复杂的分布式系统概念,比如数据库分片?
- 面试意图: 测试你运用通俗易懂的类比向高管领导层传达技术概念的能力。
- 关键能力: 技术转译、业务导向和表达清晰度。
- 参考答案:“我会避免使用工程术语,转而用围绕运营效率和财务成本的、易于理解的商业类比来解释。我用扩张的公司会计部门来类比分片:‘想象你的公司只有一名档案管理员,负责处理所有全球客户的发票。当业务从 100 个客户增长到 100,000 个客户时,这名管理员会完全不堪重负,发票被延误,工作陷入停滞。你可以雇一名世界纪录级的快手管理员,但费用高得离谱,而且仍然有生理极限。分片就是把那个巨大的档案柜拆分成四个区域办公桌:一张负责北美,一张负责欧洲,一张负责亚洲,一张负责拉美。每张桌子以标准成本独立运作,发票处理速度提高四倍,而且如果一张桌子积压了,其他桌子仍能正常运转。’”
问题 14:如何在 48 小时内交付客户演示的紧迫压力与编写整洁、可维护的代码之间取得平衡?
- 面试意图: 考察你对技术债务的理解,以及在一线工程工作中速度与质量之间的权衡。
- 关键能力: 务实的工程思维、技术债务管理,以及演示后的重构。
- 参考答案:“一线工程工作就是在速度与运营完整性之间取得平衡。面对紧迫的 48 小时截止期限,我的优先级会转向交付核心客户价值路径,同时保持安全性和数据完整性。我可以接受削减非必要的抽象层、硬编码临时配置变量、编写精简脚本来让流水线在演示中跑通。但我绝不会在安全边界、加密或输入净化方面妥协。关键是,我会把每一个走捷径的地方记录在专门的技术债务日志中。演示一结束,我就会立即安排专门的重构任务,将代码模块化、添加自动化单元测试,并在代码进入生产环境之前用环境变量替换临时配置。”
问题 15:为什么你想担任前沿部署工程师,而不是核心后端软件工程师?
- 面试意图: 衡量你的职业动机、真正的客户同理心,以及与该职位独特要求的契合度。
- 关键能力: 客户影响力、快速反馈循环、产品责任感,以及多面手能力。
- 参考答案:“虽然我尊重核心后端工程,但在内部基础设施中工作、与最终用户相隔好几层,可能会让人感到孤立。当我能看到自己编写的软件对运营的直接影响时,我才能发挥最佳状态。作为前沿部署工程师,我能经历完整的生命周期:我与业务负责人坐在一起,了解他们最棘手的运营挑战,设计架构,编写集成代码,并实时观察最终用户与系统的交互。反馈循环是即时的。此外,应对混乱的企业环境迫使我成为更全面的工程师,同时掌握数据管道、云架构和高管沟通。要深入了解这两种职业路径的日常工作流程、薪酬权衡和职业发展,请查看我们的前沿部署工程师与软件工程师职业对比。”
7. 六周 FDE 面试准备路线图
要在前沿部署面试中取得成功,需要在系统架构、现场编程和顾问式沟通方面进行有结构的准备。请遵循这份为期六周的针对性准备计划,在每一轮评测中建立信心。
| 组件 / 阶段 | 详情与规格 |
|---|---|
| 第 1 周 | 基础知识与混乱代码库导航 |
| 第 2 周 | 分解方法与企业范围界定 |
| 第 3 周 | 高韧性集成编程与模式验证 |
| 第 4 周 | 企业现场系统设计与治理 |
| 第 5 周 | 客户角色扮演模拟与高管汇报 |
| 第 6 周 | 端到端模拟面试与最终校准 |
第 1 周:基础知识与代码库导航
- 练习导航架构陌生的开源代码库。
- 克隆复杂的代码库并设置计时器:花 30 分钟追踪数据摄取路径、隔离入口点,并在没有文档的情况下运行单元测试。
- 复习基础的数据处理库:掌握 Pydantic 验证、Pandas 数据框转换以及 Python 中的 JSON 解析。
第 2 周:分解方法与企业范围界定
- 练习使用五阶段框架拆解模糊的现实世界业务问题。
- 每天选择两个企业运营问题:医疗供应链、飞机预测性维护、跨境汇款欺诈检测或医院床位分配。
- 在严格的 45 分钟白板环节内,勾勒出用户画像、数据模式、API 边界和 MVP 交付计划。
第 3 周:高韧性集成编程
- 从零开始实现生产级企业 API 适配器。
- 构建包含完全抖动的指数退避、断路器、死信队列和流式文件解析器的项目。
- 编写全面的单元测试套件,覆盖边界情况:损坏的 JSON 载荷、网络超时、空响应以及意外的数据类型。请参考 Pydantic 官方文档 了解现代验证模式。
第 4 周:企业级现场系统设计
- 将重心从消费级规模转向企业安全与治理。
- 学习企业网络概念:双向 TLS、SAML 2.0 身份联合、气隙容器部署以及行级数据库访问控制。
- 练习在严格的监管约束(HIPAA、SOC 2、FedRAMP)下设计系统。探索 Kubernetes 架构指南,了解如何在气隙集群中部署服务。
第 5 周:客户角色扮演模拟
- 练习口头表达能力和商务缓和技巧,要大声说出来。
- 与一位工程师同伴合作进行现场模拟,让他们扮演敌对的客户副总裁、强势的产品经理或困惑的客户工程师。
- 专注于积极倾听、在生产环境出现意外故障时保持冷静,以及将技术术语转化为商业价值。
第 6 周:端到端模拟循环与校准
- 在一天内执行完整的 4 小时模拟面试循环,涵盖全部五个面试阶段。
- 就节奏、讲解的清晰度和技术结构征求直接反馈。
- 通过查看 Levels.fyi 薪资数据 上经过验证的现场工程职级范围,校准你的目标薪酬预期。
要了解前沿部署工程师职业与更广泛的技术发展路径的交集,请探索我们关于 AI 与机器学习工程专业化方向 的对比指南。
8. 常见问题(PAA 与搜索意图)
什么是 Palantir 分解面试?
Palantir 分解面试是一场 60 至 90 分钟的技术评估,候选人需要在不编写代码的情况下,将一个模糊的运营挑战拆解为结构化的软件架构。候选人要主导一场架构探索会议,定义用户原型、映射数据模式、划分服务边界,并提出分阶段交付计划。
前沿部署工程师面试有多技术化?
前沿部署工程师面试非常技术化,与核心后端软件流程的严格工程标准相当。不过,评估侧重于务实的系统集成,例如解析混乱的数据、处理网络重试以及气隙部署,而不是抽象的白板智力题。
如何准备混乱代码库面试?
准备混乱代码库环节的方法是:克隆开源项目,练习在 30 分钟内定位执行入口点、数据流和失败的单元测试。通过编写防御性适配层来建立肌肉记忆,使用 Pydantic、指数退避重试和结构化调试日志。
FDE 面试和解决方案架构师面试有什么区别?
前沿部署工程师面试侧重于编写生产级代码、构建定制化集成、重构现有软件以及主导深入的架构分解。相比之下,解决方案架构师面试主要聚焦于售前需求挖掘、评估云厂商服务目录、绘制高层参考架构,以及进行商业软件演示,而无需向客户仓库提交生产代码。
FDE 面试最适合使用哪些编程语言?
Python 和 TypeScript 是前沿部署工程面试中最有效的语言,因为它们在数据管道和全栈界面中被企业普遍采用。Go 也被广泛接受,常用于基础设施工具、容器编排和高性能网络自动化。
FDE 面试如何评估面向客户的技能?
面向客户的技能通过专门的模拟或行为角色扮演环节来评估,面试官会扮演持怀疑态度的客户高管或承受巨大压力的数据库管理员。评估者会考察你是否积极倾听、能否在压力下缓和紧张气氛,以及能否清晰地解释技术权衡而不让非技术背景的领导层产生疏离感。
软件工程师没有现场经验可以转型为 FDE 吗?
可以,软件工程师可以通过展示面向客户的 API 集成经验和生产事故响应经验,成功转型为前沿部署工程师。在面试中展现结构化的问题分解能力和较强的商业同理心,会对招聘评审团产生决定性的影响。
FDE 面试中最大的危险信号有哪些?
主要的危险信号包括:在弄清约束条件之前就动手写代码或选择数据库;在被质疑权衡方案时变得防御性强;以及在角色扮演中对非技术利益相关者说话居高临下。候选人还会因为用不必要的 AI 框架对简单问题过度设计,同时忽视数据治理、物理隔离(air-gap)和网络故障模式而失败。
9. 结语:拿下企业现场工程师的 Offer
前沿部署工程面试旨在识别那些能够将生产级软件工艺与高管级商业领导力相结合的全能型工程师。成功并非来自死记硬背算法技巧,而是来自在面对混乱需求时展现出可靠的工程判断力。
通过掌握五阶段问题分解框架、构建防御性数据集成管道,以及练习顾问式沟通,你就能从普通候选人中脱颖而出。你将证明自己值得信赖,能够在高风险的客户董事会会议室和关键任务型企业环境中代表公司。
在完成面试准备时,请将你的技术叙述扎根于生产环境的实际情况。回顾真实世界中的故障模式,练习积极倾听,并把每一个模糊的场景都视为构建实用、可扩展软件的机会。