前沿部署 AI 工程:在企业环境中部署 Agent 与 RAG
掌握前沿部署 AI 工程。学习如何在复杂的企业基础设施内部署自主 AI Agent 与物理隔离的 RAG 流水线。
在企业环境中部署生成式模型会面临标准教程和软件开发工具包很少涉及的挑战。原型演示在干净的云端沙箱中可以稳定运行,但企业部署必须在封闭的子网内运行、严格遵守监管合规要求,并查询数十年来碎片化的企业记录。
行业研究显示,80% 到 95% 的企业生成式人工智能试点在达到规模化生产之前便陷入停滞。主要瓶颈并非模型能力,而是将非确定性智能集成到遗留交易系统中的结构性困难。
弥合这一差距需要以安全、韧性和运营同理心为核心的专业工程实践。如需了解现场工程职业路径和核心能力的端到端概览,请阅读我们的前沿部署工程师综合指南。
核心要点 前沿部署 AI 工程师通过将脆弱的原型模型转变为具备韧性的企业系统,来解决实施危机。企业部署失败的主要原因是脏乱的孤立数据、物理隔离的网络边界、失控的延迟预算、模型漂移以及监管风险。生产级检索增强生成依赖于检索前身份注入,以及将稠密向量与稀疏词法排序相融合的混合搜索。自主 Agent 封装需要纵深防御架构,包括自动 PII 脱敏、Token 预算、指数退避重试和严格的模式校验。
1. 企业 AI 的现实检验:实施危机
前沿基础模型的快速演进让高管层产生了一种错误预期,认为生成式软件可以轻松部署。企业领导层常常以为,购买 API 订阅或开通托管云实例就足以自动化复杂的业务流程。
在实践中,组织会遭遇企业软件架构的残酷现实。专有数据库没有干净的向量索引,网络防火墙拒绝出站互联网流量,数据隐私官禁止将客户记录发送到公共端点。
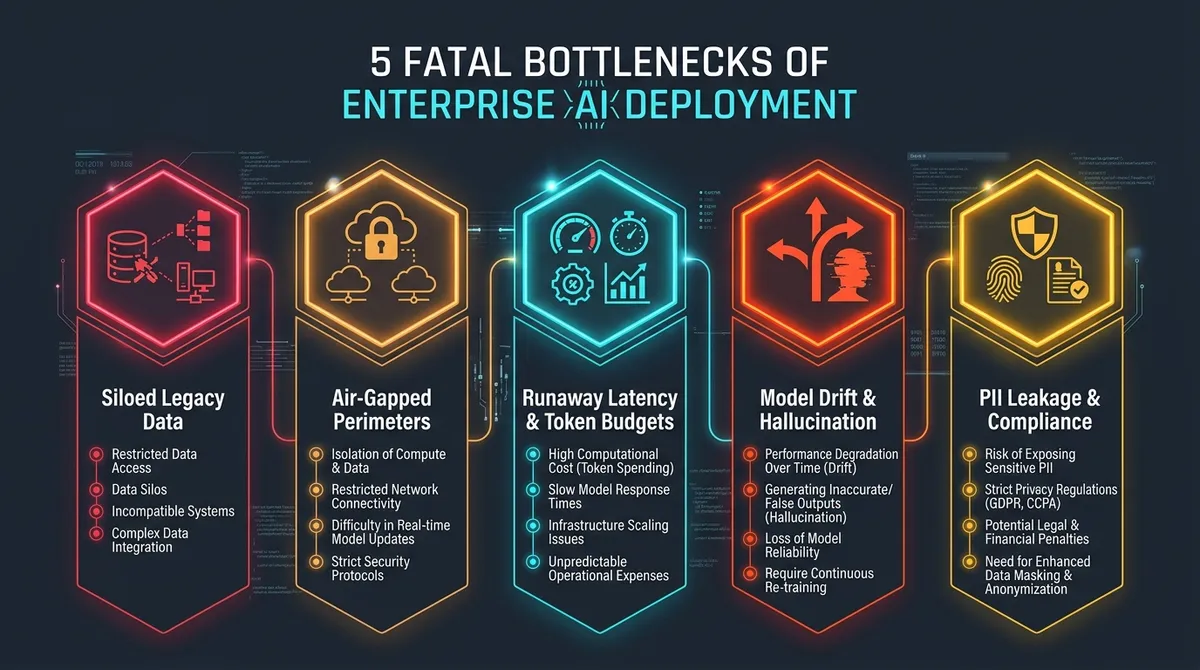 图 2:从原型过渡到生产过程中遇到的五大主要运营障碍。
这种运营摩擦提升了前沿部署 AI 工程师的战略重要性。与在集中式研究实验室中专注于损失函数和训练运行的传统机器学习工程师不同,现场工程师直接深入客户环境中工作。
他们从事最后一公里 AI 工程实践,将未格式化的文档和脆弱的业务逻辑转化为可靠的自动化服务。要了解这些智能系统的架构剖析,请参阅我们关于自主 AI Agent 架构与能力的指南。
原型与生产之间的鸿沟
一个可运行的概念验证与企业级 Agent 部署之间的差异体现在多个关键维度上。未能认识到这些差异的团队,其部署往往在初始安全审计阶段就被取消。
| 架构维度 | 笔记本概念验证 | 企业生产系统 |
|---|---|---|
| 数据摄取 | 干净的静态 PDF 和格式化的 CSV 文件 | 非结构化的 SharePoint 数据湖、SAP 导出文件和遗留 SQL |
| 网络出站 | 直接 HTTPS 调用公共商业 API | 气隙隔离的 VPC、双向 TLS 以及零互联网连接 |
| 访问治理 | 单一管理 API 令牌 | 基于 SAML 和 Active Directory 的检索前身份注入 |
| 错误处理 | 未处理的异常和手动重启终端 | 熔断器、指数退避重试和死信队列 |
| 延迟要求 | 不受约束的 15 至 45 秒推理循环 | 面向客户界面的严格亚秒级服务等级协议 |
| 审计验证 | 临时的控制台打印语句 | 加密只追加账本和可验证的引用 |
2. 企业 AI 部署的五大致命障碍
在企业客户部署中,需要预判软件可能在何处出错。前沿部署工程师专门设计能够抵御这五大致命障碍的架构,以避免企业项目脱轨。
保护客户环境免受漏洞侵害需要严格的系统控制。有关防御机制的详细解析,请参阅我们关于企业 AI Agent 安全最佳实践的综合资源。
1. 孤立、非结构化和脏乱的遗留数据
企业知识很少被整齐地组织起来。有用的运营上下文往往埋藏在数十年前的企业资源规划系统、内部维基页面和电子邮件存档中。
此外,重复文件、相互矛盾的政策备忘录和过时的电子表格污染着企业存储库。天真的摄取管道将这些相互冲突的数据直接转换为向量嵌入,导致自信的幻觉和错误的业务决策。
2. 气隙隔离边界与主权零出站网络
国防、投资银行和医疗保健领域的组织在严格的信息安全指令下运营。这些公司禁止企业知识产权、员工通信或客户记录离开其私有子网。
商业模型提供商的公共推理端点完全不可用。现场工程师必须构建气隙隔离的 AI 架构,让数据摄取、嵌入、向量索引和模型推理全部在自托管基础设施上运行。
3. 失控的延迟预算与无上限的 Token 消耗
自主 AI Agent 利用多步规划循环,生成中间思考过程和工具调用来解决用户请求。在不受控的环境中,这些循环经常触发级联的 API 查询。
一个复杂的用户查询可能触发十五次递归工具调用,消耗超过 80,000 个 token,并需要两分钟才能返回响应。在生产环境中,这种行为会烧掉基础设施预算,并让期望快速软件响应的企业运营者感到沮丧。
4. 非确定性输出漂移与边缘案例退化
传统软件工程依赖确定性执行路径,相同的输入产生相同的输出。相比之下,大语言模型在温度设置、系统提示词修改和库版本变更下会表现出细微的行为差异。
一个在一月成功处理财务资产负债表的提示词模板,可能在三月因季度报告格式略有变化而悄然失效。没有持续的离线评测套件,现场部署会在无人察觉的情况下退化。
5. 敏感数据暴露与监管治理
欧盟《人工智能法案》、NIST AI 风险管理框架、HIPAA 和 SOC 2 Type II 等监管框架都执行严格的数据保护准则。在企业环境中部署 AI Agent 必须保证个人身份信息(PII)永远不会以明文形式记录或保留在模型权重中。
现场系统必须保证用户只能查询其明确有权查看的信息。客服代表绝不能收到包含高管薪酬数据的 AI 补全内容,即使模型摄取了全公司的薪资数据库。
3. 架构蓝图:四层前沿部署 Agent 技术栈
为了克服这些运营挑战,前沿部署团队构建模块化系统,在每个执行阶段都强制实施安全性和可靠性。企业架构不将模型逻辑与用户界面直接耦合,而是将职责分离到四个不同的层级。
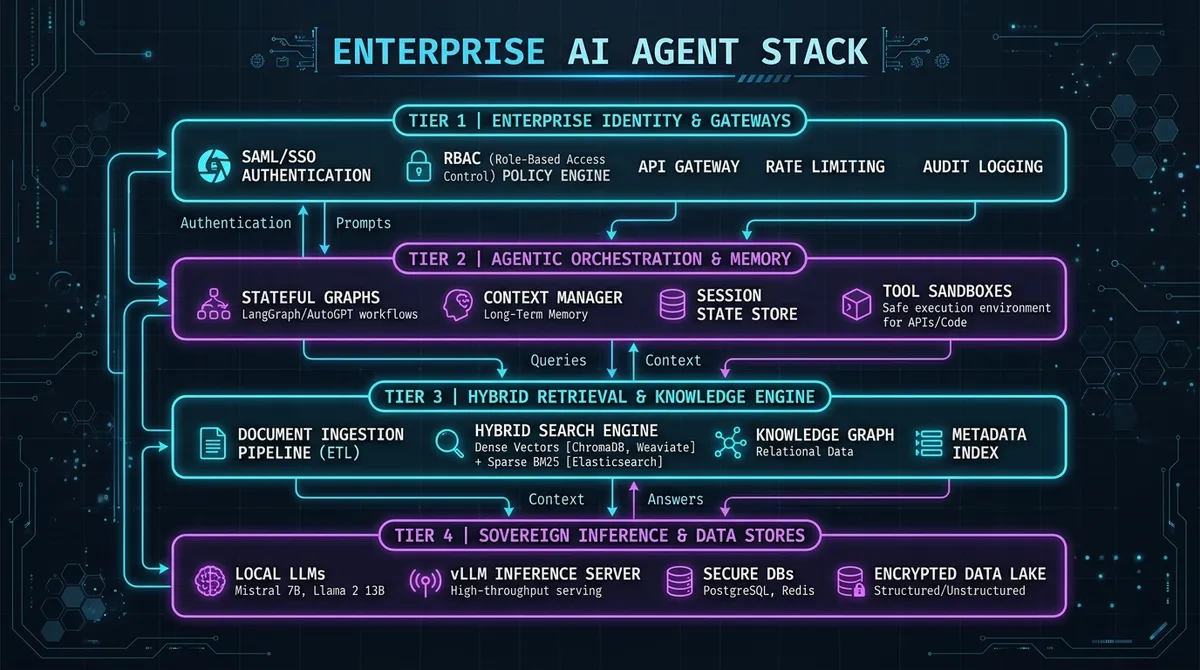 图 1:在企业边界内部署高弹性 AI Agent 的四层架构框架。
标准化 AI Agent 与企业数据源之间的接口,可以避免定制化开发造成的瓶颈。如果您正在设计可扩展的工具适配器,请查阅开放的 Model Context Protocol 服务器规范,以构建可互操作的连接器。Anthropic Model Context Protocol 规范中详述的规范,为企业工具提供了标准化的客户端-服务器模型。
| 步骤 | 工作流 / 架构阶段 |
|---|---|
| 1 | [ 第 1 层:身份与策略执行 ] |
| 2 | SAML 2.0 / OIDC 会话验证 |
| 3 | 检索前身份注入(ABAC / RBAC) |
| 4 | 入站速率限制与提示词净化 |
| 5 | [ 第 2 层:智能体编排与记忆 ] |
| 6 | 有状态图执行引擎 |
| 7 | 情景记忆与工作会话记忆 |
| 8 | 人机协同审批关卡 |
| 9 | [ 第 3 层:知识引擎 ] [ 第 4 层:主权推理 ] |
| 10 | 混合检索(稠密向量+BM25) - 气隙隔离模型服务 |
| 11 | 倒数排名融合 - PagedAttention(vLLM) |
| 12 | 文档血缘账本 - 量化模型权重 |
第 1 层:企业身份、网关与策略执行
外围边界使用企业单点登录协议(如 SAML 2.0 或 OpenID Connect)对传入请求进行身份验证。网关提取经过验证的用户身份令牌、部门隶属关系和安全许可级别。
第 1 层不会将用户查询直接传递给模型,而是对输入字符串进行净化,过滤恶意提示词注入模式和有害字符。在将请求路由到下游之前,它还会跟踪每个组织的速率限制和 API 配额。
第 2 层:智能体编排与有状态执行
第 2 层管理认知执行流程。借助有状态图框架,编排引擎将高层目标分解为离散的推理步骤,并维护对话检查点和工作记忆。
至关重要的是,该层管理工具执行边界。当 AI Agent 决定调用企业 API(例如处理发票退款或修改保险保单)时,第 2 层会验证授权边界,并对破坏性变更强制执行人工审批检查。
第 3 层:混合检索与向量知识存储
第 3 层充当企业的机构记忆。它通过自动化的提取、转换和加载(ETL)管道摄取企业文档,将原始文件转换为结构化嵌入向量。
为防止未经授权的数据访问,第 3 层采用检索前身份注入。在第 1 层验证过的用户安全属性会被直接传入向量数据库搜索查询中,在向量计算开始之前就从数学上排除未经授权的记录。
第 4 层:主权推理与持久化存储
基础层承载模型推理和存储系统。在物理隔离(air-gapped)环境中,Tier 4 在隔离的虚拟私有云内使用 vLLM 等优化推理引擎运行开放权重模型。工程师可以查阅 vLLM 开源推理引擎仓库,了解高并发生产部署。
所有交互、模型补全、系统提示词和工具输出都会写入仅可追加、防篡改的审计账本。这确保了合规审计和内部绩效审查的完整取证可追溯性。
4. 物理隔离 RAG 架构:从 Notebook 到主权子网
在物理隔离网络内构建企业级 RAG 部署,需要重新审视每一条标准的检索假设。在消费级应用中,开发者依赖云端嵌入和近似最近邻向量搜索。
在企业环境中,纯向量相似度检索会失效。企业用户经常搜索特定的发票序列号、法律条文条款或工程零件编码。向量嵌入会将这些精确的字母数字标记映射到宽泛的语义簇中,导致检索精度低下。
要应对企业部署的技术复杂性,需要扎实的基础知识。请查阅我们的实用 前沿部署工程师路线图与技能栈,掌握底层系统工程技能。此外,如需在物理隔离的企业网络边界内部署有状态集群,请参阅 Kubernetes 架构概念指南。
为什么纯稠密检索在企业环境中会失效
稠密向量模型擅长语义概念匹配,例如将“汽车维修”与“汽车发动机保养”关联起来。然而,企业文档中包含大量专业术语和精确的字母数字标识符。
例如,一位航空航天工程师搜索“Part A-492-X 螺栓失效”时,纯语义搜索的结果会很差。嵌入模型评估的是“螺栓”和“失效”这类泛化概念,而不是精确匹配字母数字序列号“A-492-X”。
解决方案:基于倒数排名融合的混合搜索
生产级物理隔离检索系统将稠密语义嵌入与基于 BM25 算法的稀疏词法关键词匹配相结合。两种检索流程在本地文档库上并行运行,其结果通过倒数排名融合(RRF)进行合并。
对于文档 $d$,其在检索系统集合 $R$ 上的倒数排名融合分数计算如下:
$$RRF_Score(d) = \sum_{r \in R} \frac{1}{k + rank_r(d)}$$
其中 $k$ 是平滑常数,通常设为 60。通过对倒数排名求和,在关键词匹配或语义相似度上表现特别出色的文档会升至上下文窗口的顶部。
| 步骤 | 工作流 / 架构阶段 |
|---|---|
| 1 | 用户输入查询:“更换 4 号泵上的传感器模块 SN-8812” |
| 2 | [ 稠密向量搜索 ] [ 稀疏 BM25 搜索 ] |
| 3 | (语义概念) (精确字母数字匹配) |
| 4 | 前 20 个语义命中结果 前 20 个词法命中结果 |
| 5 | [ 倒数排名融合 ] |
| 6 | (统一排名评分) |
| 7 | [ 交叉编码器重排序器 ] |
| 8 | (前 5 个上下文片段) |
| 9 | [ 本地物理隔离 LLM 推理 ] |
检索前身份注入机制
在朴素的 RAG 教程中,系统会搜索整个文档数据库,检索前十个片段,然后再过滤掉用户无权查看的文件。这种方法在企业环境中是不可接受的,原因有二:
- 信息匮乏: 如果检索到的前十个片段中有九个属于机密文件,过滤后模型只剩下一个片段来组织答案,导致响应质量低下。
- 上下文窗口泄露: 过滤逻辑可能在错误信息中意外暴露文档标题、元数据头部或文件路径,泄露内部组织情报。
前沿部署工程师实现检索前身份注入。用户身份声明(例如 Active Directory 安全组:
["Finance-L2", "Risk-Analyst", "Region-EMEA"]
)被直接注入到数据库查询过滤器中:
{
  "query_vector": [0.024, -0.081, 0.142, "..."],
  "filter": {
    "and": [
      { "security_classification": { "lte": 3 } },
      { "authorized_groups": { "in": ["Finance-L2", "Risk-Analyst"] } },
      { "geographic_region": { "in": ["EMEA", "GLOBAL"] } }
    ]
  },
  "top_k": 5
}
数据库在执行最近邻计算之前先应用布尔安全过滤器。向量搜索仅在用户有权查看的文档范围内运行。
5. 生产代码实现:弹性企业 Agent 适配器
前沿部署 AI 工程师构建弹性集成适配器,置于原始模型与客户端应用之间。这些适配器保护企业后端免受格式错误输出的影响,脱敏敏感信息,跟踪 token 消耗,并管理间歇性网络故障。
在构建自定义 Agent 封装时,评估框架选择是至关重要的一步。请参阅我们的对比分析 PydanticAI vs LangChain vs LangGraph 框架对比,为你的技术栈选择合适的基础。关于模式验证标准,请参考 Pydantic 官方文档 来设计弹性的数据模型。
以下可执行的 Python 实现展示了生产级企业弹性模式。它具备基于正则表达式的 PII 脱敏、Pydantic 模式验证、token 预算管理,以及带完全抖动的指数退避重试机制。
"""
Resilient Enterprise Agent Adapter.
Demonstrates PII redaction, schema validation, token governance, and retries.
"""

from typing import Dict, Any, List, Optional
import re
import time
import random
import logging
from pydantic import BaseModel, Field, ValidationError

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")
logger = logging.getLogger("EnterpriseAgentAdapter")


class EnterpriseAnalysisOutput(BaseModel):
    """Defines strict schema structure for agentic business recommendations."""
    incident_id: str = Field(..., min_length=4, description="Unique operational incident identifier")
    severity_level: str = Field(..., pattern=r"^(CRITICAL|HIGH|MEDIUM|LOW)$")
    root_cause_summary: str = Field(..., min_length=20, max_length=500)
    recommended_actions: List[str] = Field(..., min_items=1, max_items=5)
    confidence_score: float = Field(..., ge=0.0, le=1.0)
    estimated_remediation_hours: float = Field(..., ge=0.5, le=120.0)


class SecurityRedactor:
    """Sanitizes text inputs and outputs to prevent PII leakage."""

    EMAIL_PATTERN = re.compile(r"\b[A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Z|a-z]{2,7}\b")
    SSN_PATTERN = re.compile(r"\b\d{3}-\d{2}-\d{4}\b")
    CREDIT_CARD_PATTERN = re.compile(r"\b(?:\d{4}[-\s]?){3}\d{4}\b")

    @classmethod
    def redact_pii(cls, text: str) -> str:
        """Replaces sensitive patterns with generic privacy redaction tokens."""
        text = cls.EMAIL_PATTERN.sub("[REDACTED_EMAIL]", text)
        text = cls.SSN_PATTERN.sub("[REDACTED_SSN]", text)
        text = cls.CREDIT_CARD_PATTERN.sub("[REDACTED_CARD]", text)
        return text


class TransientModelSocketError(Exception):
    """Raised when on-premises model server experiences an intermittent network timeout."""
    pass


class EnterpriseAgentAdapter:
    """Manages input redaction, model interaction, retries, and schema validation."""

    def __init__(self, token_budget: int = 10000, max_retries: int = 3, base_backoff_sec: float = 0.5):
        self.token_budget = token_budget
        self.tokens_consumed = 0
        self.max_retries = max_retries
        self.base_backoff_sec = base_backoff_sec
        self.dead_letter_records: List[Dict[str, Any]] = []

    def _mock_model_inference_call(self, prompt: str, fail_rate: float = 0.25) -> Dict[str, Any]:
        """Simulates local model inference call with token consumption and occasional network drops."""
        # Check token budget governor
        estimated_tokens = len(prompt.split()) * 2 + 150
        if self.tokens_consumed + estimated_tokens > self.token_budget:
            raise RuntimeError(f"Token budget exceeded. Consumed: {self.tokens_consumed}, Requested: {estimated_tokens}")

        self.tokens_consumed += estimated_tokens

        # Simulate network socket flakiness
        if random.random() < fail_rate:
            raise TransientModelSocketError("504 Gateway Timeout: Local vLLM worker disconnected")

        # Return simulated JSON payload
        return {
            "incident_id": "INC-8892",
            "severity_level": "HIGH",
            "root_cause_summary": "Upstream database connection pool exhausted due to unindexed join queries.",
            "recommended_actions": [
                "Deploy temporary read replica to relieve transactional load",
                "Apply missing composite index on telemetry table",
                "Restart application connection pool with strict keep-alive limits"
            ],
            "confidence_score": 0.94,
            "estimated_remediation_hours": 3.5
        }

    def execute_resilient_analysis(self, raw_incident_text: str) -> Optional[EnterpriseAnalysisOutput]:
        """Runs end-to-end sanitized inference workflow with retries and output validation."""
        # Step 1: Pre-inference PII redaction
        clean_input = SecurityRedactor.redact_pii(raw_incident_text)
        logger.info("Executing analysis on sanitized input (Length: %d chars)", len(clean_input))

        # Step 2: Resilient inference call loop
        raw_output = None
        for attempt in range(1, self.max_retries + 1):
            try:
                raw_output = self._mock_model_inference_call(clean_input)
                logger.info("Inference succeeded on attempt %d", attempt)
                break
            except TransientModelSocketError as err:
                if attempt == self.max_retries:
                    logger.error("All %d inference retries exhausted: %s", self.max_retries, err)
                    self._route_to_dead_letter(clean_input, reason=str(err))
                    return None

                sleep_duration = self.base_backoff_sec * (2 ** (attempt - 1)) + random.uniform(0, 0.1)
                logger.warning("Attempt %d failed. Retrying in %.2f seconds...", attempt, sleep_duration)
                time.sleep(sleep_duration)

        if not raw_output:
            return None

        # Step 3: Strict Schema Validation
        try:
            validated_result = EnterpriseAnalysisOutput(**raw_output)
            logger.info("Output successfully validated against schema. Confidence: %.2f", validated_result.confidence_score)
            return validated_result
        except ValidationError as err:
            logger.error("Output schema validation failure: %s", err.errors())
            self._route_to_dead_letter(raw_output, reason=f"ValidationError: {str(err)}")
            return None

    def _route_to_dead_letter(self, data: Any, reason: str) -> None:
        """Stores unprocessable items in an internal dead-letter queue for forensic review."""
        entry = {
            "payload": data,
            "timestamp": time.time(),
            "reason": reason
        }
        self.dead_letter_records.append(entry)
        logger.error("Transaction routed to Dead-Letter Queue. Total DLQ items: %d", len(self.dead_letter_records))


# Verification run
if __name__ == "__main__":
    sample_text = (
        "Server outage reported by user john.doe@enterprise-corp.com (SSN: 000-12-3456). "
        "Postgres cluster experiencing memory pressure and locking transactions."
    )

    adapter = EnterpriseAgentAdapter(token_budget=5000, max_retries=3, base_backoff_sec=0.1)
    outcome = adapter.execute_resilient_analysis(sample_text)

    if outcome:
        print("\nValidated Incident Recommendation:")
        print(f"Severity: {outcome.severity_level}")
        print(f"Summary: {outcome.root_cause_summary}")
        print(f"Remediation Time: {outcome.estimated_remediation_hours} hours")
        print(f"Total Tokens Used: {adapter.tokens_consumed}")
该实现的架构洞见
- 入口处的防御性脱敏: 请注意,PII 脱敏在将提示词传入模型之前执行。这确保了客户隐私数据永远不会进入提示词内存缓冲区或日志聚合器。
- Token 预算调控器: 适配器在发起网络调用之前会验证剩余的 token 容量。如果某个出现故障的 AI Agent 进入无限循环,调控器会在触发预算超支之前终止执行。
- 结构化 Pydantic 契约: 模型补全结果会被强制转换为显式的 EnterpriseAnalysisOutput 模型。如果语言模型输出了幻觉字段或无效的状态字符串,验证层会拦截该错误并将载荷路由到死信队列。
6. 企业级 AI Agent 的工具调用安全与纵深防御
赋予自主语言模型调用外部应用程序接口的能力会带来巨大的安全风险。在实验室环境中,AI Agent 可以自由地查询数据库、执行终端脚本和发送电子邮件。
在企业生产环境中,一个不受约束的 AI Agent 会对数据完整性构成生存性威胁。一个误解提示词的模型可能会删除正在使用的数据库表、批准欺诈性交易,或向公共邮件列表广播机密文档。
前沿部署工程师在将 AI Agent 连接到企业后端时,会实施严格的纵深防御原则。
| 步骤 | 工作流 / 架构阶段 |
|---|---|
| 1 | 传入的模型工具调用请求 |
| 2 | [ 静态安全策略检查 ] |
| 3 | 请求的操作是只读还是变更型? |
| 4 | [ 只读操作 ] [ 变更型操作 ] |
| 5 | SELECT 查询 - UPDATE、DELETE、POST |
| 6 | 文档查询 - 金融转账 |
| 7 | [ 人在回路网关 ] |
| 8 | 需要经过验证的操作员签核 |
| 9 | 两阶段事务锁 |
| 10 | [ 临时沙箱容器 ] |
| 11 | 网络隔离,零互联网访问 |
| 12 | 最小权限数据库凭据 |
| 13 | [ 加密执行日志 ] |
1. 只读操作与变更型操作的分离
企业工具必须划分为两个不同的安全类别:
- 只读工具: 检查状态而不修改底层记录的操作,例如检索产品文档、查询工单状态或查看账户余额。这些工具在标准速率限制下自主执行。
- 变更型工具: 更改记录、删除数据或发起金融交易的操作。例如更新客户账单地址、转账资金或配置云服务器。
2. 人在回路审批与两阶段提交
变更型操作绝不能仅凭模型推理而自主执行。当 AI Agent 判定某个账户记录需要修改时,它会生成一个暂存的事务提案。
系统通过企业门户向人工操作员发出审批工单。人工审核员检查提议的参数,验证业务理由,并进行加密签署。只有在收到经过验证的操作员批准后,Agent 才会执行该变更操作。
3. 临时沙箱与最小权限执行
代码执行工具(例如用于数据分析的 Python 解释器)必须在锁定的、临时的 microVM 或容器沙箱中运行。
执行容器必须没有出站互联网访问权限,仅挂载临时的内存文件系统,并以受限的用户权限运行。如果用户尝试通过提示注入读取主机系统文件,沙箱边界可以完全遏制该攻击。
7. 评测、回归防护与模型漂移监控
一旦企业 Agent 系统在生产环境中上线,工程任务就从初始集成转向持续的可靠性监控。在不断变化的企业环境中运行的软件面临持续的数据模式更新、用户行为变化以及细微的模型漂移。
要胜任高级现场工程职位,需要在掌握系统设计的同时精通评测方法。要了解常见的技术面试题和校准标准,请参阅我们的指南:前沿部署工程师面试题与拆解评分标准。
用于自动化性能评估的 RAG 三元组
前沿部署团队部署自动化评测流水线,在不依赖昂贵的人工标注的情况下对生产环境的生成结果进行评分。这一评测方法的基础是 RAG 三元组:
| 步骤 | 工作流 / 架构阶段 |
|---|---|
| 1 | [ 用户查询 ] |
| 2 | / \ |
| 3 | 上下文相关性 答案相关性 |
| 4 | / \ |
| 5 | [ 检索到的上下文 ] ▶ [ 生成的答案 ] |
| 6 | \ |
| 7 | 忠实度 |
| 8 | \ |
| 9 | (有据可依) |
- 上下文相关性: 衡量搜索引擎检索到的文档块是否确实包含回答用户查询所需的事实。相关性得分低表明分块边界不佳或向量嵌入效果欠佳。
- 忠实度(有据可依): 衡量生成答案中的每一条陈述是否都能在数学上追溯到检索到的上下文。如果答案包含上下文中不存在的断言,其忠实度得分就会很低,这标志着出现了幻觉。
- 答案相关性: 衡量模型的生成结果是直接回答了用户的原始提问,还是偏离主题或返回通用的模板化文本。
持续遥测与运营质量指标
除了算法评测之外,现场团队还会监控真实世界的用户交互遥测数据,以发现细微的工作流程摩擦:
- 隐式反馈信号: 追踪企业用户将生成内容复制到剪贴板的频率、提交草稿前编辑的字符数,以及放弃自动化工作流而手动完成任务的频率。
- 延迟分布百分位: 测量第 50、95 和 99 百分位的端到端响应时间。p99 延迟的飙升通常表明向量数据库内存碎片化或本地推理服务器中的排队延迟。
- 回退触发率: 追踪触发回退逻辑、死信路由或人工干预的用户请求百分比。回退率的意外上升表明上游企业数据库架构发生了漂移。
8. 常见问题(PAA 与搜索意图)
前沿部署 AI 工程师是做什么的?
前沿部署 AI 工程师是一种嵌入式软件工程师,在客户环境中构建、集成和定制人工智能系统。他们不是在研究实验室中训练模型,而是将算法连接到企业数据库、保护物理隔离的基础设施,并构建有韧性的 Agentic 工作流。
为什么大多数企业 AI Agent 试点会失败?
企业 AI Agent 试点失败的主要原因是干净的 Notebook 原型与混乱的企业生产环境之间的学习鸿沟。孤立的老旧数据、防火墙限制、过高的延迟以及合规障碍,使未经审查的原型无法通过企业安全审计。
如何在物理隔离环境中部署 AI Agent?
在物理隔离环境中部署 AI Agent 需要将整个软件栈托管在一个零出站互联网连接的隔离私有网络内。现场工程师将容器镜像和开放权重模型打包成签名的离线包,并使用内部 GPU 集群上的 vLLM 等高吞吐量本地推理引擎进行服务。
什么是企业 RAG 中的检索前身份注入?
检索前身份注入是一种安全模式,即在搜索执行之前,将经过验证的用户授权声明直接注入向量数据库查询过滤器中。这确保检索引擎只搜索用户有权合法访问的文档,从而消除上下文匮乏和数据泄露问题。
为什么企业检索必须使用混合搜索?
混合搜索之所以必不可少,是因为稠密语义向量无法匹配发票号、错误代码和技术缩写等精确的字母数字标记。通过倒数排名融合(Reciprocal Rank Fusion)将稠密语义嵌入与稀疏词法 BM25 排名相结合,可将检索准确率提升 15% 到 25%。
前沿部署 AI 工程师如何防范提示词注入?
现场工程师通过实现纵深防御的安全层来防止提示注入,而不是依赖系统提示指令。他们通过确定性令牌过滤器对输入进行净化,将不可信的外部数据与指令隔离,强制执行严格的 Pydantic 输出模式,并在隔离的沙箱中执行工具。
哪些框架最适合企业级智能体编排?
像 LangGraph 和 PydanticAI 这样的有状态图框架是企业级智能体编排的标准选择,因为它们支持显式的状态持久化和循环路由。这些框架允许工程师定义确定性的执行边界、事务回滚以及人在回路中的审批检查点。
企业如何监控智能体性能和模型漂移?
企业通过使用 RAG 三元组的自动化离线测试套件以及实时生产遥测来监控智能体性能。现场团队跟踪令牌消耗、p99 延迟百分位、用户编辑距离和回退触发率,以便尽早发现运行性能退化。
9. 结论:现场 AI 工程的未来
将生成式智能部署到复杂的企业环境中,是当今技术时代最具挑战性的工程前沿之一。成功并非来自追逐更大的基础模型,也不是靠给脆弱的网页封装添加复杂的提示指令。
真实世界的企业影响力需要严谨的软件工艺。它要求构建防御性的数据验证层,掌握主权气隙架构,强制执行严格的工具安全边界,并以严谨的工程怀疑态度对待非确定性智能来设计系统。
随着组织从实验性技术评估过渡到长期运营采用,前沿部署 AI 工程师仍然是不可或缺的人类桥梁。通过掌握这些架构蓝图和部署模式,你将把自己置于应用型企业人工智能的最前沿。