编程 Agent 在任务中花费大量时间寻找正确的文件。三种方法:grep 加阅读、基于 MCP 的代码知识图谱(codebase-memory-mcp)以及由模型评判的检索(jevgrep)。本文介绍其架构、真实的基准测试数据、需要注意的坑,以及在客户代码库上应该选用哪种方案。
作者:ARJUN MEHTA · FDEINTERVIEWS 编辑部 · 更新于 2026 年 10 月 7 日 · 阅读时长 10 分钟
实践练习:Model Context Protocol(MCP)概念 · RAG 与 Agent 设计问题 · 系统设计问题 · 必知的 FDE 问题
编程 Agent 通过三种方式查找代码:逐个 grep 并阅读文件、查询预先构建的仓库结构索引,或者让模型判断哪些文件和函数是相关的。 两个开源项目代表了后两种较新的方式。codebase-memory-mcp(MIT 许可,截至 2026 年 10 月 7 日在 GitHub 上约有 46,000 颗星)将仓库解析为知识图谱并通过 MCP 提供服务。jevgrep(MIT 许可,2026 年 9 月 26 日发布)使用 TypeSafe 的 Jev 模型判断相关性,以文件和逐字摘录来回答自然语言问题。两者都发布了测量数据,而且细读之后都比只看 README 横幅更有意思。图谱 agent 使用的 token 比 grep 加阅读的 agent 少约十倍,但在答案质量上得分为 0.83,而后者为 0.92。jevgrep 在 SWE-bench 上与其基线同样解出 10 题中的 8 题,总成本低 25.8%,其中大部分节省来自一个任务。
为什么查找代码是成本最高的环节
观察一个编程 Agent 在陌生仓库上的表现,它早期的绝大多数轮次都是搜索:列出一个目录、grep 一个名称、打开三个文件、grep 这些文件调用了什么、再打开两个文件。每次读取都会进入上下文窗口,也都会计入账单。Codebase-Memory 论文很好地描述了这种错配:开发者提出的问题是结构性的(谁调用了这个、如果我改了它会破坏什么、模块边界在哪里),但 Agent 的工具却是文本性的。用 grep 跟踪调用链意味着每一跳都要一次搜索加一次读取,因此工具调用和 token 数量会随代码库规模增长。
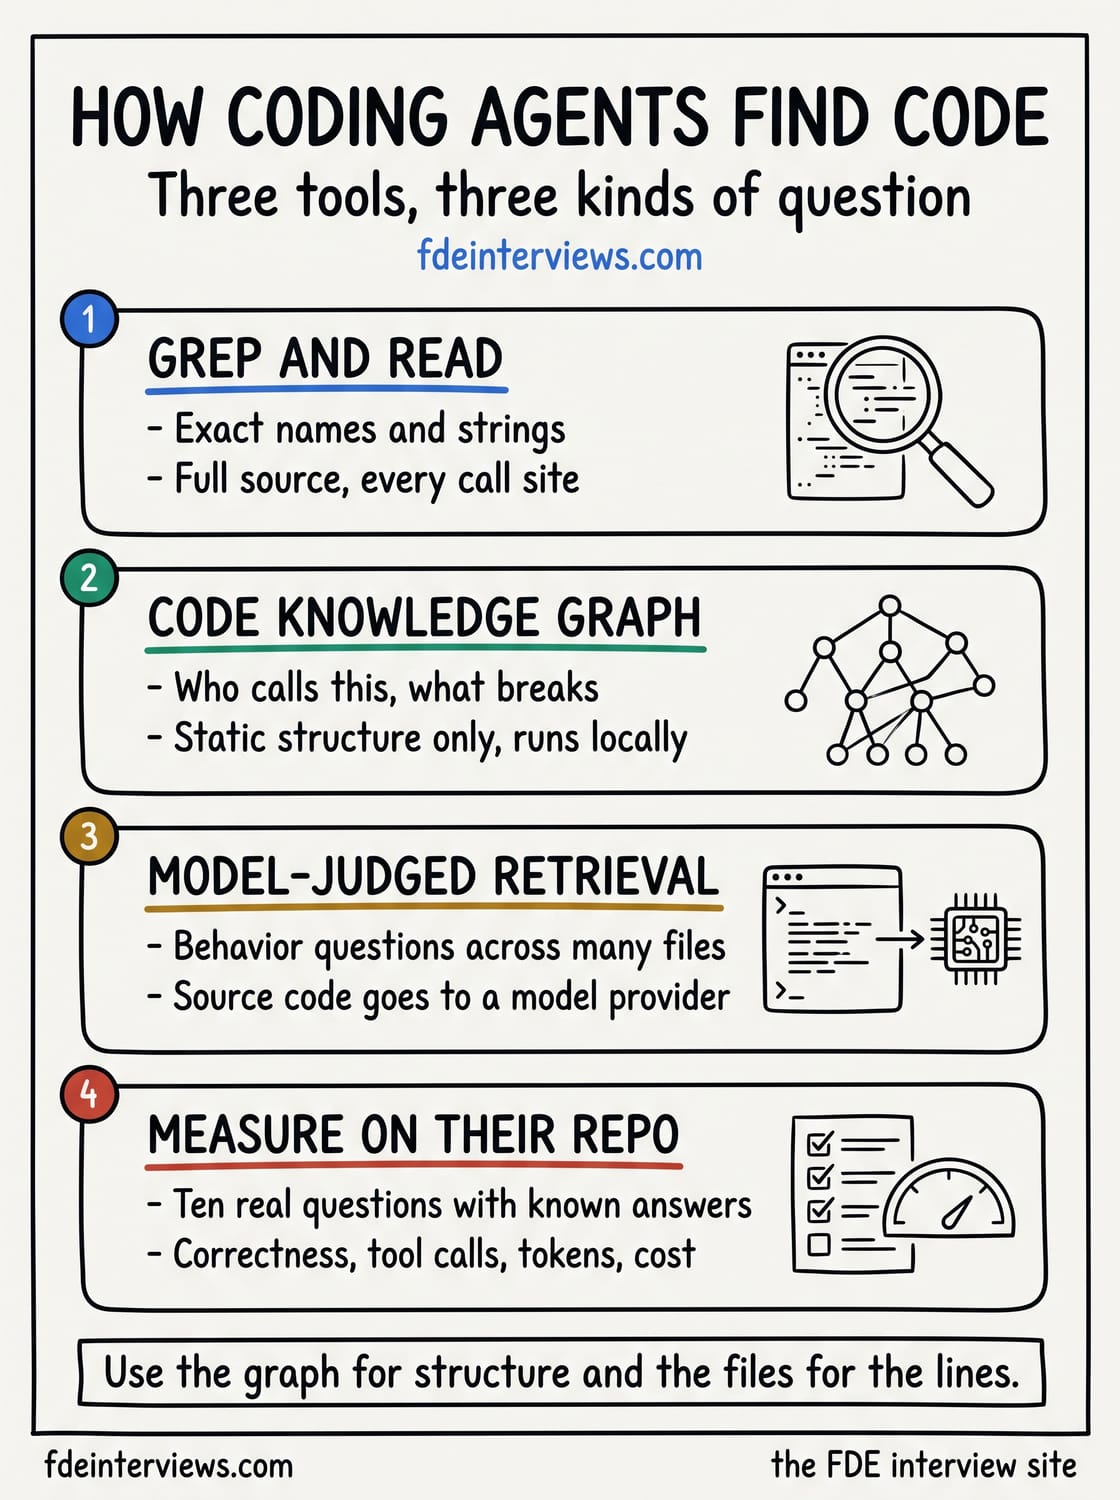
图示展示了三种方法回答同一个问题的情况。
codebase-memory-mcp:将仓库视为一张图
它是什么。 一个静态链接的单一 C 二进制文件,无运行时依赖,支持 macOS、Linux 和 Windows。它将仓库索引为一张图,存储在
~/.cache/codebase-memory-mcp/
下的 SQLite 中,并向任何支持 MCP 的 agent 暴露该图。它不包含语言模型。当你问你的 agent “谁调用了 ProcessOrder?”时,agent 会调用
trace_path
并组织结果的表述,因此无需额外的 API 密钥,也不需要为第二个模型付费。
索引是如何构建的。 解析分为两层运行。tree-sitter 处理所有支持的语言:论文报告了 66 种语言,而 README 现在列出了 158 到 162 种编译进二进制文件的语法。它提取定义、调用和导入。第二层“混合 LSP”处理,是对 pyright、gopls 和 rust-analyzer 等语言服务器中类型解析思想的 C 语言重新实现,为 Python、TypeScript 和 JavaScript、PHP、C#、Go、C、C++、Java、Kotlin、Rust 和 Perl 精化调用边。没有它,
user.profile.display_name()
只是一个名字。有了它,调用就能解析到三个模块之外的方法。论文描述了一个六策略调用解析级联,其中前三个策略在结构良好的代码库中能解析约 80% 的调用。在图之上还有 Louvain 社区检测(用于发现功能模块)、git-diff 影响映射以及跨服务的 HTTP 路由匹配。
Agent 能看到的工具。 当前 README 中有 17 个 MCP 工具。其中改变 agent 工作方式的包括:
| 工具 | 它回答什么 |
|---|---|
| search_graph | 按名称模式、标签或度查找符号;在图上进行 BM25 和语义搜索 |
| trace_path | 谁调用了它,以及它调用了什么,广度优先最多 5 层 |
| detect_changes | 你未提交的 diff 触及了哪些符号,并给出影响范围风险等级 |
| query_graph | 只读的 openCypher 子集,例如查找没有调用者的函数 |
| get_architecture | 一次调用获取语言、包、入口点、路由、热点和集群 |
| get_code_snippet | 通过限定名获取单个函数的源代码 |
一个用受支持子集编写的死代码查询如下所示:
MATCH (f:Function)
WHERE NOT EXISTS { (f)<-[:CALLS]-() }
RETURN f.name LIMIT 20
速度。 README 报告,在一台 Apple M3 Pro 机器上,对 Linux 内核(2800 万行、75,000 个文件、481 万个节点和 772 万条边)的完整索引约需 3 分钟,Django 约 6 秒,图查询不到一毫秒。论文测得调用者遍历约为 0.3 毫秒。
仔细解读基准测试
论文(arXiv 2603.27277,2026 年 3 月)才是应该引用的证据,而不是 README 徽章。它针对 31 种语言各选一个真实仓库,运行了 12 个问题类别,使用同一模型上的两个 agent:一个使用图工具,另一个用 grep 并读取文件。
| Graph agent | Grep-and-read agent | |
|---|---|---|
| 回答质量(0 到 1) | 0.83 | 0.92 |
| 每个问题的工具调用次数 | 2.3 | 4.8 |
| 每个问题的 token 数 | 约 1,000 | 约 10,000 |
| 查询延迟 | 不到 1 毫秒 | 10 到 30 秒 |
图谱 Agent 以约十分之一的 token 达到了 explorer 90% 的质量。在 31 种语言中的 19 种里,它在枢纽检测和调用者排名上表现更好。explorer 在需要完整源码上下文的问题(31 个中的 16 个)和穷尽式调用点搜索(31 个中的 10 个)上表现更好,而宏密集的 C 语言是图谱结果中最弱的,得分为 0.58 对 1.00,因为宏不会出现在 tree-sitter 语法树中。作者坦率地列出了局限:只用一个模型、每种语言一个仓库、答案由第一作者对照参考答案评分,并且尚未与基于 embedding 的检索或普通语言服务器进行比较。他们自己的建议是混合方案:图谱用于结构,文件用于源码。
README 中的两个数字需要谨慎对待。“token 减少 120 倍”和“减少 99.2%”的数据来自五个结构性查询(约 3,400 个 token 对约 412,000 个 token),而不是来自那项发现约 10 倍差距的 31 仓库研究。此外,README 在数量上自相矛盾(158 或 162 种语言、15 或 17 个工具、43 或 45 个客户端界面),这对于一个快速迭代的项目来说很正常,也是引用带日期来源的理由。
安装前需要注意的坑
- 仅限静态结构。 反射、依赖注入 容器、动态分发和运行时生成的路由不在图谱中。在 Spring 或 Rails 代码库上,“没有东西调用它”可能意味着“框架调用了它”。
- 团队工件可能使 git 历史膨胀。 你可以提交一个压缩的图谱快照,让队友跳过重新索引。README 警告说,每次刷新都提交会把一个约 20 MB 的文件变成数 GB 的历史,并引用了一个团队在该单一路径上约 350 次提交后达到约 6 GB 的例子。按节奏提交,或按文档使用 Git LFS。
- 每个进程必须运行完全相同的构建。 一个守护进程协调所有 Agent 会话,版本不匹配会在启动时被拒绝。更新后,重启每个打开的 Agent 会话。
- 监视器默认只跟随 git 项目。 非 git 目录的索引会保持冻结,直到你 reindex。
- 它是一个能访问你源码的二进制文件。 该项目为每个版本发布校验和、Sigstore 签名、SLSA 3 级来源证明和 VirusTotal 扫描,并且 gh attestation verify 会检查来源证明。这是一个很强的基线,论文也主张 MCP 生态应当要求这一点。但你的客户的安全团队仍需要批准它。
jevgrep:询问代码在做什么
它是什么。 一个 Node.js CLI(
npm install -g @dzhng/jevgrep
,Node 22 或更新版本),附带一个 Agent 技能,教 Claude Code、Codex、OpenCode 及类似 Agent 如何调用它。你提出一个行为性问题,例如
jg "Where is authentication checked before a request reaches a handler?" .
,它会打印一个摘要、一个紧凑的文件列表、带行号引用的逐字源码摘录,然后是声明和调用位置。README 明确指出,这是给 Agent 的证据,而不是生成的答案,也不保证找到了每一个相关文件。
工作原理。 其架构文档描述了一种分层遍历方式。目录元数据和内容预览决定探索的位置,因此它不会先上传整个目录树。在每一层,Jev(我们在什么是 Jev中介绍过的决策模型)判断相关性。文件在超过 0.5 阈值时被纳入,没有固定的 top-N 限制。选中的文件被解析为声明:Python、Go 和 Rust 使用 tree-sitter,TypeScript 和 JavaScript 使用 TypeScript 编译器,其余则使用有界的文本块。源代码从不被执行,当搜索预算用尽时,输出会说明发现是部分的,而不是假装完整。
仔细解读基准测试
jevgrep 的作者公布了每项任务的成本,让你可以核实标题数字。在 2026 年 9 月 28 日对 0.4.3 版本的总成本重跑中,十个 Python SWE-bench 任务各运行一次,编码 Agent 使用中等强度,并与未使用 jevgrep 的已保存基线运行进行对比:
两次运行都解决了相同的 10 个任务中的 8 个。总成本从 $7.62 降至 $5.66,其中 $1.48 是 Jev 本身的成本,因此包含检索模型在内降低了 25.8%。(“约 30%”的横幅数字是较早的、未计入 Jev 成本的数字;README 中有说明。)现在来拆解一下。pytest 任务从 $2.34 降至 $0.53,节省了 $1.82,占总节省 $1.97 的大部分。仅这一个任务就占了效果的约 92%。在其余九个任务中,总成本为 $5.13 对 $5.28,约降低 2.8%,而且十个任务中有五个使用 jevgrep 后成本反而更高。
这些都没有被隐藏。结果文件说明这些任务是经过调优的开发任务,而非保留集,每任务一个样本无法确立因果效应,且总体节省并非每任务的保证。后来的 0.5.0 评估将 Jev 自身的成本相比 0.4.3 运行降低了约 59%,但综合成本却比那次运行高出 2 到 3%。诚实的总结是:该工具在一小部分任务上以更低的成本匹配了解决率,主要是通过把一个昂贵的任务变便宜。这值得在你自己的仓库上做一次试点,而不是作为预算预测。
安装前需要注意的坑
- 你的源代码会发送给模型提供商。 搜索会通过 Vercel AI Gateway、TypeSafe、OpenRouter、OpenCode Zen 或兼容端点将符合条件的文件内容发送给 Jev。默认过滤器会跳过被忽略的、隐藏的、依赖项、二进制以及明显的凭据文件,且 README 明确说明这些过滤器不保证敏感数据已被移除。先运行 jg files:它会统计一次搜索会读取的内容,且不进行网络调用。其他内容使用 --exclude。
- 仅靠 CLI 对你的 Agent 没有任何作用。 运行 jg skill 来安装技能,并在升级后重新运行,因为 npm 更新不会覆盖你项目中的技能文件。
- 声明解析覆盖四个语言家族。 Python、Go、Rust 以及 TypeScript 或 JavaScript 会获得声明级别的摘录。其他语言则回退到文本块。
- 对于精确符号,grep 仍然更快。 README 中就是这么说的:当你知道名称或路径时,直接读取或 rg 就足够了。
何时使用哪种工具
| 情况 | 选择 | 原因 |
|---|---|---|
| 源码不能离开本机(受监管、物理隔离环境) | 图工具加 grep | 一切都在本地运行;没有任何模型提供商能看到代码 |
| “谁调用了这个?”,“如果我改动它会有什么破坏?” | 图工具 | 预先物化的调用边,大约十分之一的 token 消耗 |
| 在陌生仓库中问“这里的重试是怎么工作的?” | 模型判定的检索 | 行为类问题涉及的文件名与问题并不匹配 |
| 你知道符号或字符串 | grep 或 rg | 精确、免费、现成可用 |
| 宏密集的 C 代码、大量反射或依赖注入 | grep 并阅读 | 静态图无法捕捉语法树之外的东西 |
FDE 视角:在客户代码库上进行代码搜索
前沿部署工程师通常工作在自己没有编写的代码中,遵循自己没有制定的规则,这使得第一个约束是法律层面的而非技术层面的。在选择工具之前,先问源码是否根本不能发送到第三方模型端点。对于许多银行、保险公司和公共部门客户来说,答案是不能,这就排除了模型判定的检索,使得本地索引加有纪律的 grep 成为默认选择。
然后在客户自己的仓库上进行测量,因为上述两项研究使用的公共仓库可能不像一个有 15 年历史的单体应用。列出团队第一个月实际提出的十个问题(计费在哪里计算,什么调用了遗留的 auth 模块,哪些服务读取这张表),并在团队的帮助下写下正确答案。用每种工具配置运行 agent,并记录正确性、工具调用次数、token 和成本。这正是两个项目都使用的协议的缩小版,它给你一个客户会相信的数字,因为它来自他们自己的代码。codebase-memory-mcp 的文档中恰好包含一份在自己工作负载上测量质量和节省成本的指南。
最后,告诉 agent 哪个工具用于什么用途。在仓库的 AGENTS.md 中写一行简短说明(“用 trace_path 查调用者,用 search_code 查字面字符串,用 jg 查工作原理类问题”),可以防止 agent 去用 grep 搜索图工具已经持有的调用链。这就是微缩版的 harness 工程;我们关于 AI 编码 agent 的 harness 工程的文章涵盖了其余内容。
在面试中,这体现为检索设计:何时使用结构化检索而非嵌入(embeddings),如何在推广前评估代码搜索工具,以及哪些数据会离开客户的网络。Model Context Protocol 和 GraphRAG 与上下文检索 涵盖了基础知识,而 RAG 与 Agent 题库则提供了可供练习的设计问题。
把它转化为录用机会。练习与之对应的真实问题和概念:
常见问题
一个用 C 编写、采用 MIT 许可证的开源 MCP 服务器,它使用 tree-sitter 将代码仓库解析为一个持久的知识图谱,涵盖文件、函数、类、调用、路由和跨服务链接,并存储在你本机的 SQLite 中。编码 Agent 通过 search_graph、trace_path、detect_changes 等工具以及一个只读的 Cypher 子集来查询它,而不是用 grep 搜索和阅读文件。它不包含任何语言模型;Agent 本身就是查询翻译器。
一款面向编码 Agent 的 MIT 许可证命令行工具,于 2026 年 9 月发布,它能用一次响应回答关于代码仓库的自然语言问题,并给出相关文件、阅读线索和逐字源代码摘录。它会遍历文件夹层级,并让 Jev(TypeSafe AI 的决策模型)判断文件夹、文件和声明的相关性。它会通过你配置的提供商将符合条件的源代码内容发送给该模型。
在唯一一项已发表的研究中,总体上并非如此。在 Codebase-Memory 论文(arXiv 2603.27277)中,使用图谱的 Agent 在答案质量上得分为 0.83,而使用 grep 搜索并阅读文件的 Agent 得分为 0.92,但前者的 token 用量少了约十倍,工具调用次数少了 2.1 倍。图谱在结构性问题上胜出,例如枢纽检测和调用者排名,而在需要完整源代码或穷举调用点搜索的问题上落败。
在十个经过调优的 SWE-bench 任务上,单次运行,总体而言是的:包含 Jev 的总成本重测显示,在同样解决 10 个任务中的 8 个的情况下,成本降低了 25.8%。但其中一个任务(pytest)贡献了约 92% 的节省,十个任务中有五个成本更高,而且维护者自己也表示,总体结果并不能保证每个任务都如此。把它视为有前景的证据,并在你自己的代码仓库上进行测量。
首先取决于两个约束条件:源代码能否离开机器,以及团队会提出什么问题。如果代码不能离开,那么像 codebase-memory-mcp 这样的本地图谱加上普通 grep 是可选方案。如果可以,且问题是行为性的(这个在哪里处理,那个如何工作),那么像 jevgrep 这样由模型判断的检索就合适。在这两种情况下,都要保留 grep 和文件读取功能,因为每项研究都发现,普通的探索方式在某些问题类型上仍然胜出。
讨论 (5)
论文自己的结论就是应该向客户重复的那句话:混合方案。用图来分析谁调用谁以及影响范围,用文件来查看实际的代码行。每一个宣称要取代 grep 的工具,最终都只是变成了 grep 旁边又一个工具。
是的,而且 Agent 需要知道该用哪个。这既是工具问题,也是指令问题:在 AGENTS.md 中写一行说明,指出用 trace_path 查找调用者、用 search_code 查找字面字符串,比任何单个工具都能节省更多 token。
读者提问:在工作笔记本电脑上安装来自 GitHub 的 MCP 服务器二进制文件安全吗?
去问你们的安全团队,并带上证据。这个项目发布了校验和、Sigstore 签名以及 SLSA 3 级来源证明,你可以在运行之前用 gh attestation verify 进行验证。这已经比大多数项目好了。它仍然拥有对你源代码的读取权限和对 Agent 配置文件的写入权限,而这正是安全审查应该关注的内容。
pytest 的数据才是真正的教训。一个任务在总共 1.97 美元中节省了 1.82 美元。如果你只看标题,会以为每个任务都变便宜了,但其中一半并没有。十个任务只是一次试点,而不是定论,jevgrep 的作者在他们自己的结果文件中也这样说明,这一点值得称赞。